前言
我这人出差必落东西。充电器、耳机盒、牙刷,每次到酒店才发现躺在我家抽屉里。
所以看到 Core Vision Kit 里有个"多目标识别"(objectDetection)的时候,我脑子里立刻冒出这个功能:行李箱摊开拍一张,应用把里面的东西列出来,和一份"必带清单"做差集,缺什么当场提醒。听着就是个周末能写完的小工具。
写完没有?写完了。能用吗?我把真机数据贴出来,你自己判断。
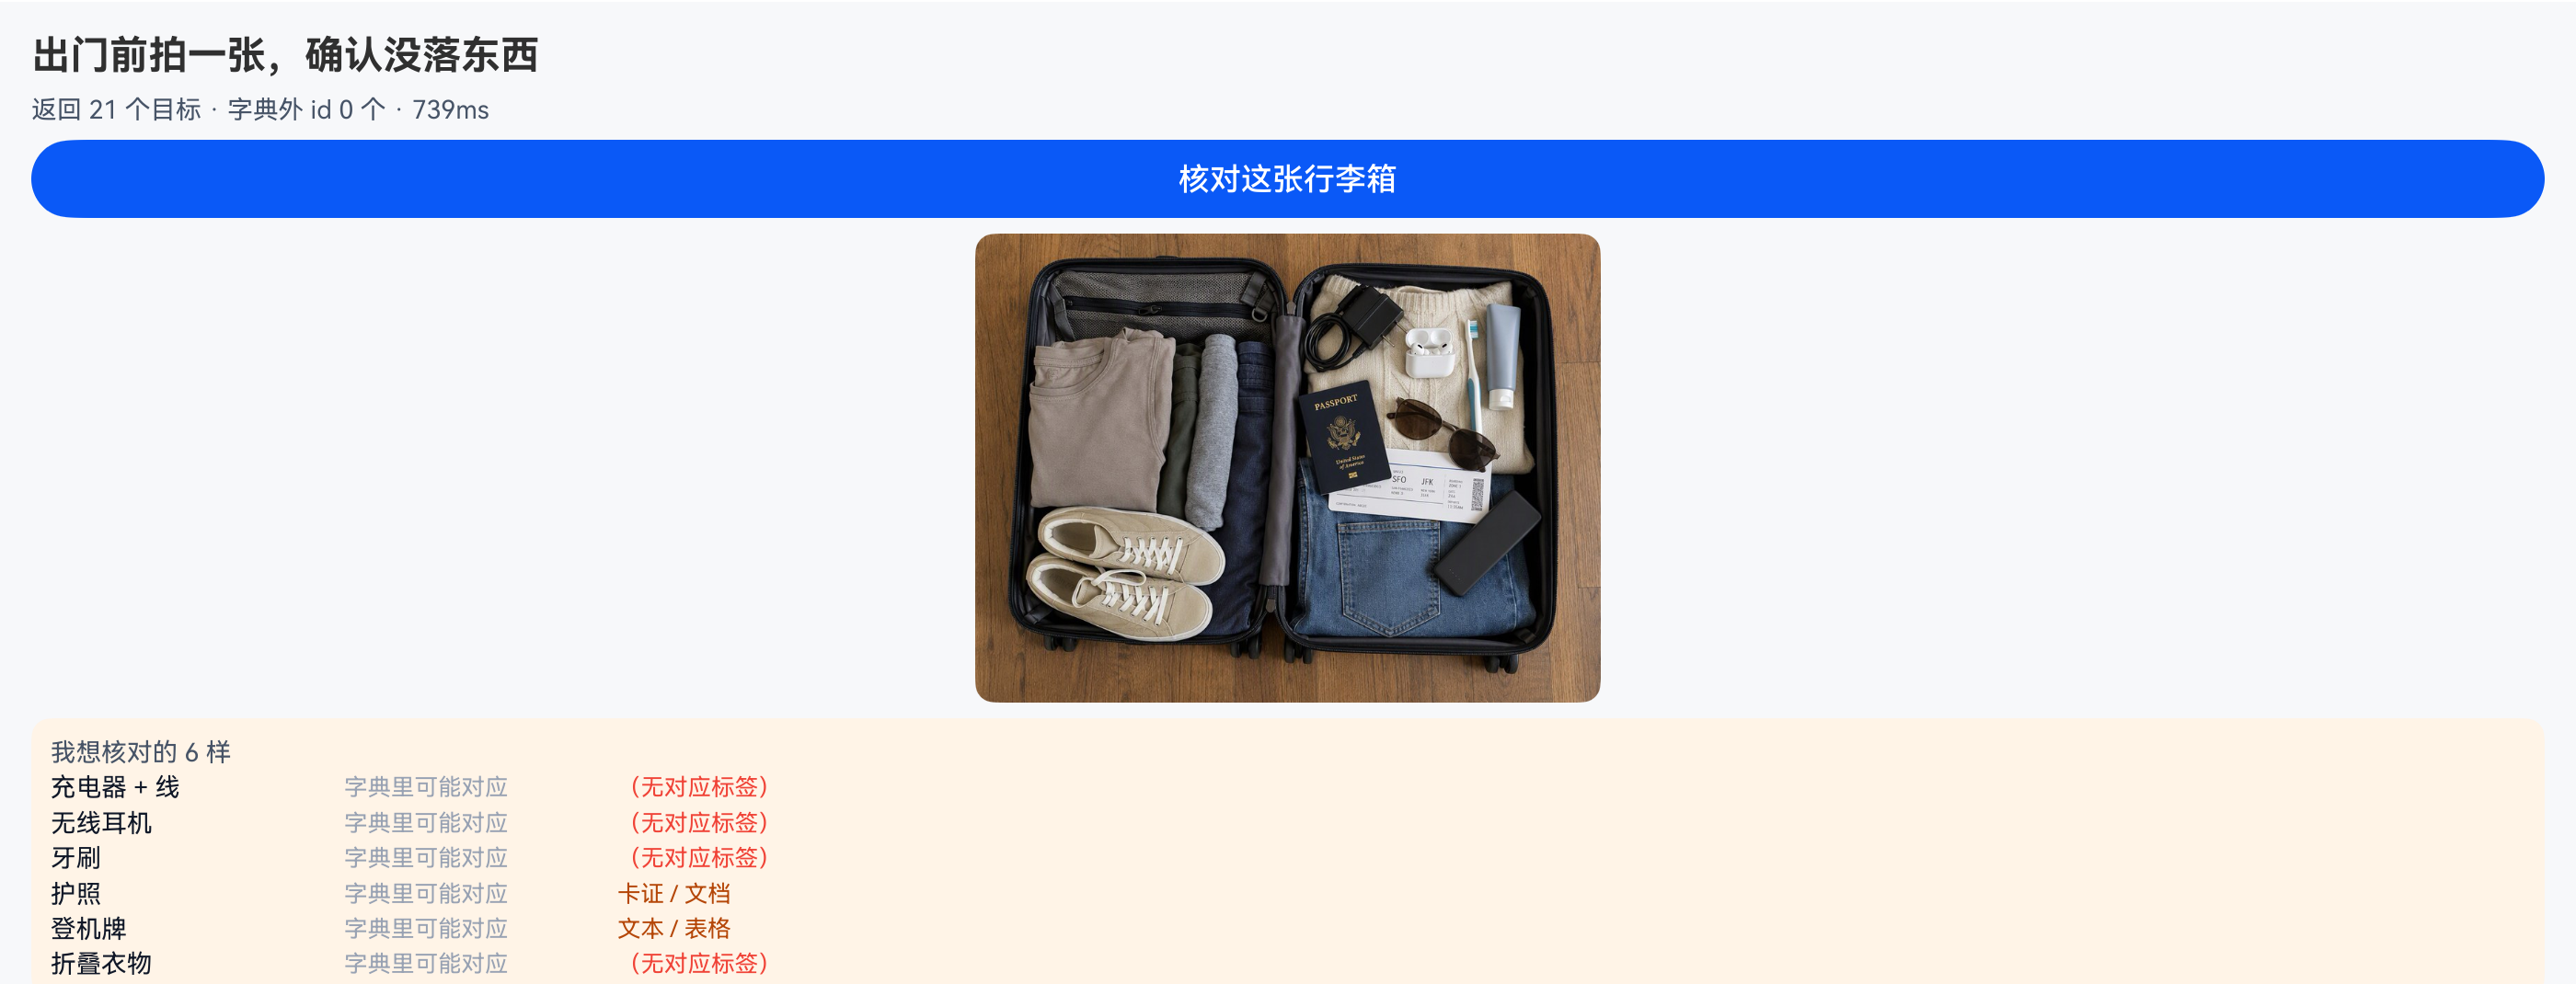
一句话预告:我核对 6 样东西,模型返回 21 个目标,21 个全是"文本"。
我期待什么,拿到什么
先说清楚测试条件,别到时候有人说"是你不会用"。
样本是一张 900×675 的行李箱俯拍图,里面明摆着摊着:折叠衣物、一双鞋、黑色充电头加数据线、白色无线耳机盒(开着)、牙刷、护照、登机牌、洗漱瓶、墨镜、充电宝。
调用就一行,minScore 我给的是 0——不设门槛,先看它到底能吐多少东西:
const out: DetectOutcome = await runner.detect(pm, 0);结果:
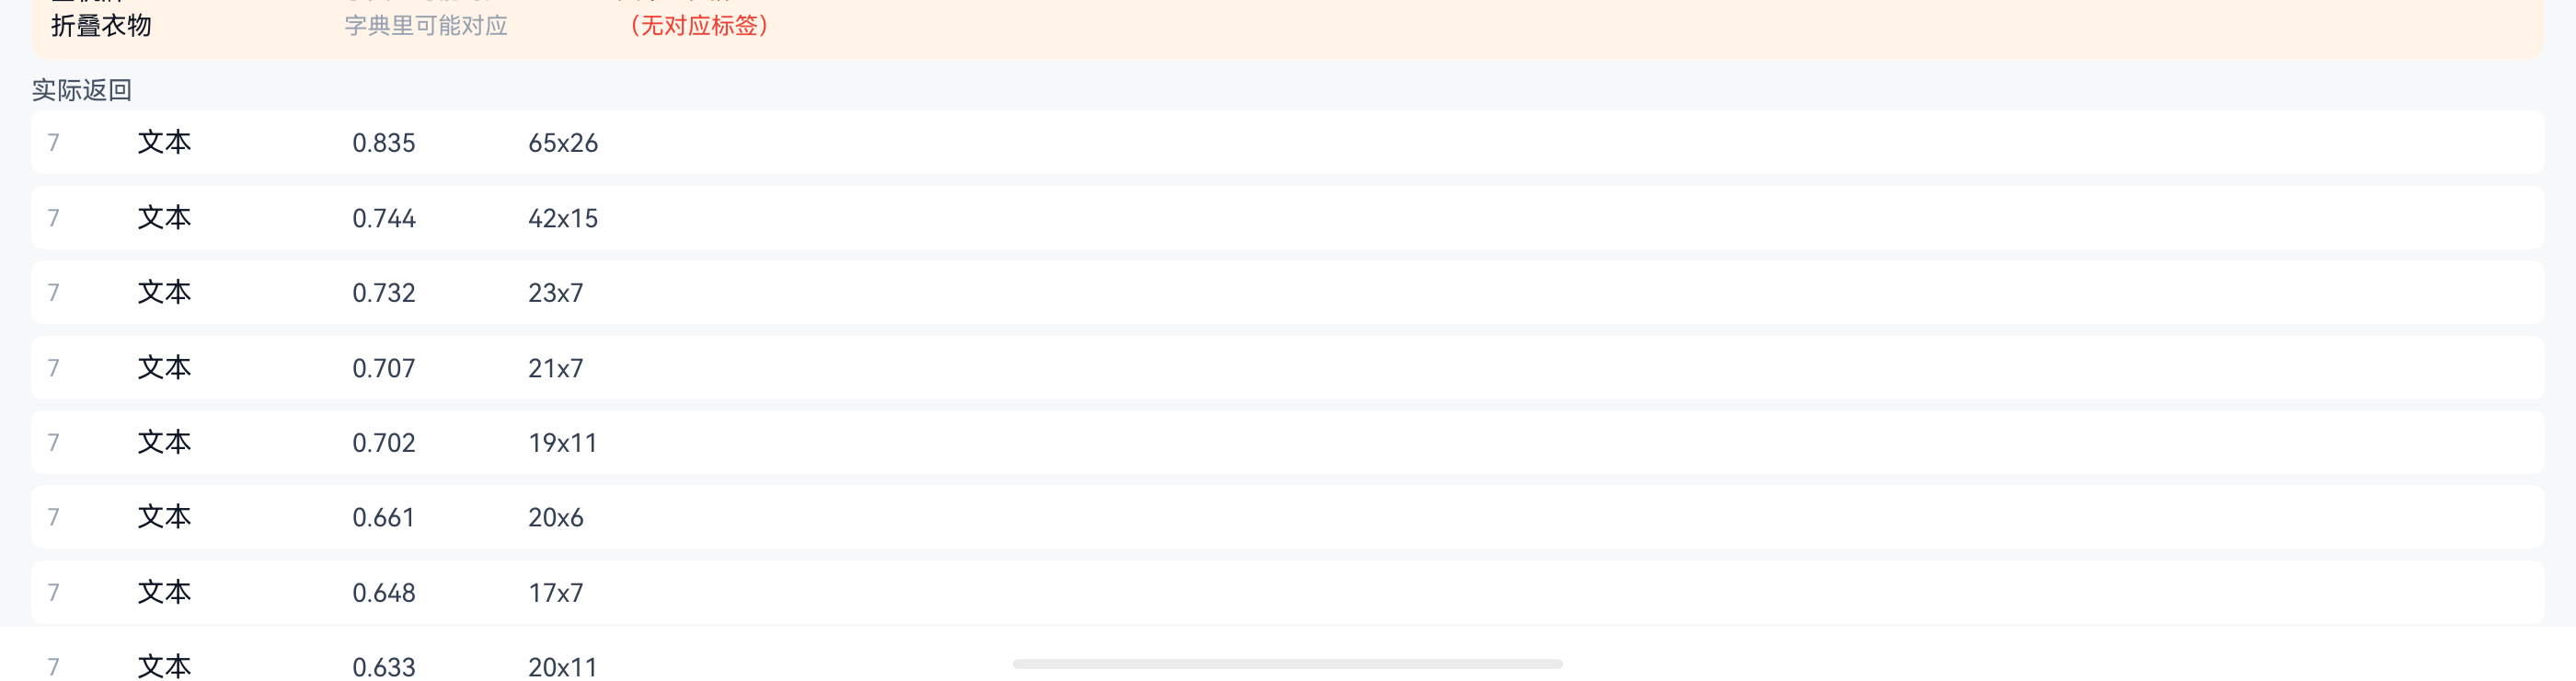
返回 21 个目标 · 字典外 id 0 个 · 739ms
labelId=7 name=文本 score=596 box=32,8
labelId=7 name=文本 score=550 box=18,6
labelId=7 name=文本 score=548 box=23,7
...(省略 18 行,全是 labelId=7)
labelId=7 name=文本 score=262 box=105,68
21 个框,labelId 全部等于 7,也就是"文本"。没有一个框是"充电器",因为字典里就没有充电器。
我核对的 6 样,命中数:
| 想核对的东西 | 字典里可能对应的类 | 实际结果 |
|---|---|---|
| 充电器 + 线 | 无 | 没有 |
| 无线耳机 | 无 | 没有 |
| 牙刷 | 无 | 没有 |
| 护照 | 卡证(22) / 文档(21) | 没有 |
| 登机牌 | 文本(7) / 表格(6) | 一堆"文本",但没法说是登机牌 |
| 折叠衣物 | 无 | 没有 |
零命中。
这 15 个类里根本没有"物"
把字典摊开看就明白了,这是我把字典抄下来时的那 15 个标签:
风景 动物 植物 建筑 人脸 表格 文本 人头 猫头 狗头 食物 汽车 人体 文档 卡证数一下:15 个类里,场景 4 个(风景/建筑 + 表格/文本这类画面元素),生物 5 个(动物/植物/人头/猫头/狗头/人体,含人脸共 6),文档类 4 个(表格/文本/文档/卡证)。真正算"一个物体"的只有 食物 和 汽车。
所以这个 API 的准确叫法不是"物体检测",是"画面元素识别"。它回答的是"这张照片里有什么种类的东西",不是"这张照片里有哪几件物品"。
我拿它做行李箱核对,等于拿一个只会说"这是风景、这是文本"的人去帮他数行李。他没错,是我问错了。
顺手补一刀:换成文搜图行不行
我不死心。Core Vision Kit 里还有个文搜图(textSearchImage),它是自然语言检索,理论上"充电器"这种词它该认识。
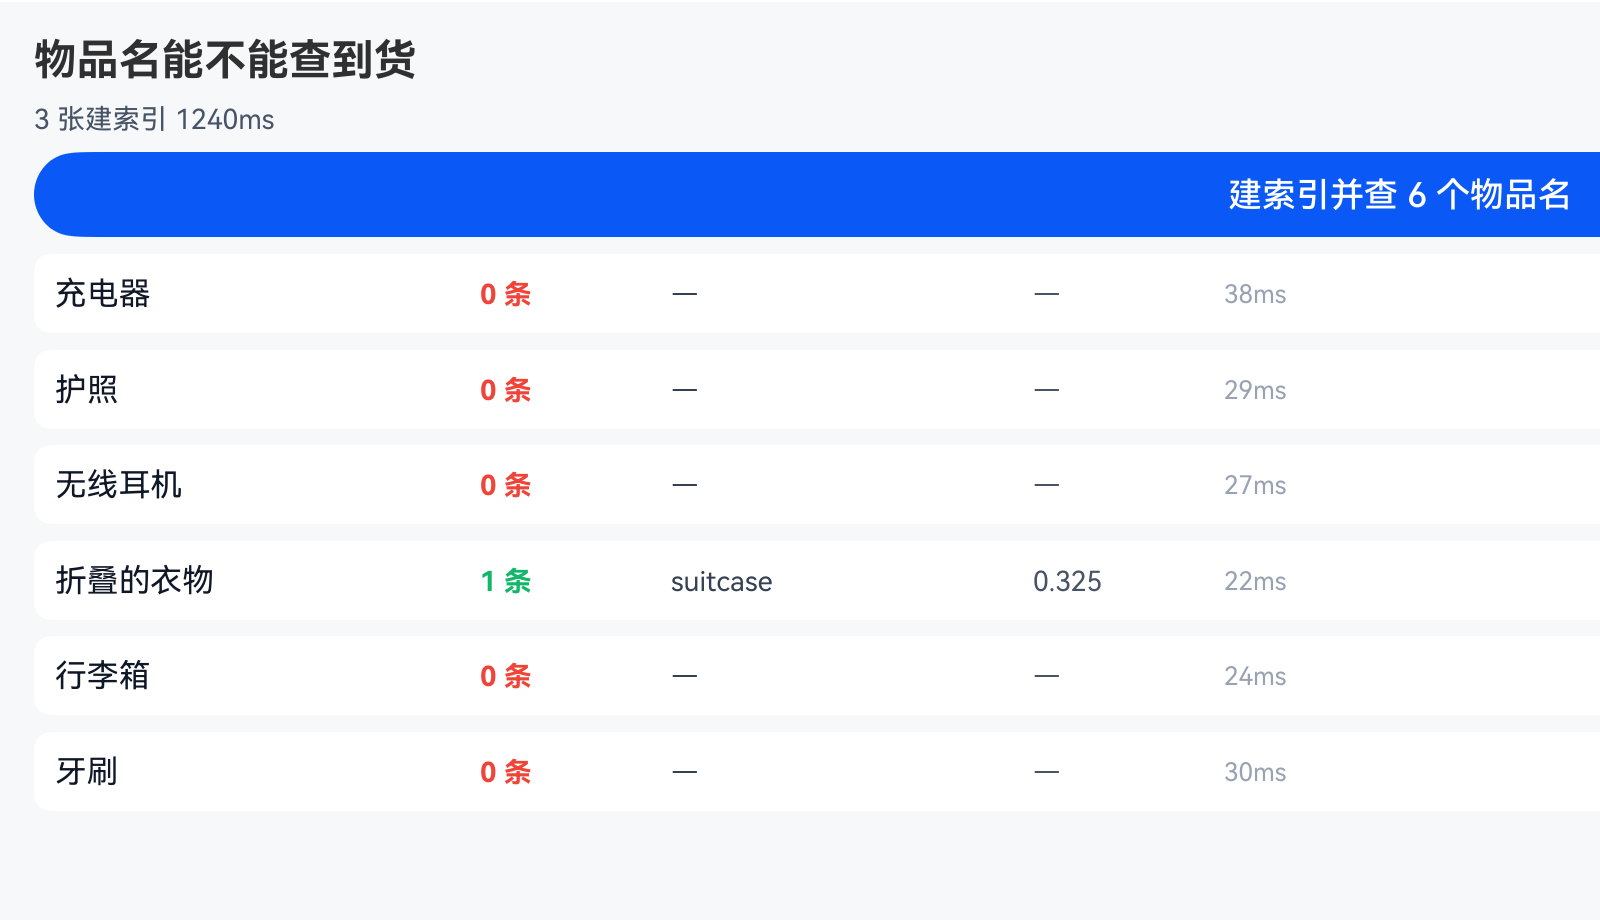
把这张行李箱照片单独建索引(另外放两张无关图当对照),然后拿 6 个物品名去查:
| 查询 | 命中数 | 首位 | 耗时 |
|---|---|---|---|
| 充电器 | 0 | — | 38ms |
| 护照 | 0 | — | 29ms |
| 无线耳机 | 0 | — | 27ms |
| 折叠的衣物 | 1 | suitcase | 22ms |
| 行李箱 | 0 | — | 24ms |
| 牙刷 | 0 | — | 30ms |
1/6。而且最讽刺的一行是**"行李箱"查不到这张行李箱的照片**。
唯一命中的是"折叠的衣物"——因为衣物在画面里占了最大面积,整图的语义向量被它主导了。
两个能力其实栽在同一个地方
想明白这点之后,结论就一句话:它们都是"整图级"的,不是"物体级"的。
- 文搜图把一张照片编码成一个向量。一张照片一个向量,就意味着这张照片里所有东西被搅成一锅。你想问"这里面有没有充电器",它只能回答"这张整体像不像充电器"。
- 多目标识别虽然给框,但它的类表是给"画面构成"设计的,物品不在里面。
所以"从一张照片里核对若干具体小物件"这个需求,端侧这套现成能力一个都接不住。这不是参数、不是阈值、不是用法问题,是能力边界。
那这个功能还能做吗
能做,但要换形态。三条我认真考虑过的路子:
- 一件一张。 拍的时候就把取景框对准单个物品,一张照片一样东西。这时候"整图级"反而变成优点——整张图就是那个东西,文搜图能查、
objectDetection里的"食物/卡证"也能兜住一部分。代价是拍照次数从 1 变成 10,用户愿不愿意是另一个问题。 - 只核对"有字的东西"。 护照、登机牌、合同、身份证这些有文字或有版式的,走 OCR + 关键词,命中率立刻可用(我拿发票和快递面单试过,能读出关键字段)。缺点是只能覆盖有字的那一小部分。
- 自己训一个物品分类模型。 这是唯一能真正回答"行李箱里有没有充电器"的路,但那就不是"调个 Kit"的工作量了。
我的选择是先做第 2 条:出差必带清单里,真正会落的东西其实就那么几样有字的——护照、登机牌、工卡、合同。剩下的靠人自己看一眼。功能小了一半,但它能上线。
顺带两个观察
"15 个标签"不等于"最多返回 15 个框"。 这次返回 21 个框,全是同一个类。顺带纠正一个容易误读的说法:字典只有 15 类,不代表最多返回 15 个框。类和框数是两回事。
minScore 给 0 会拿到一堆 12×6、13×9 像素的碎框。 这次最小几个框就是这种尺寸,分数 0.26~0.41。生产里必须自己设门槛,我给的建议起点是 0.5,并且按框面积过滤掉小于画面 0.1% 的结果——不过这次所有框都太小了,滤完就什么都不剩。
真机数据
| 项目 | 实测值 |
|---|---|
| 设备 | MatePad Pro(HarmonyOS 7 / API 26,序列号略) |
| 样本 | 900×675 行李箱俯拍,含 10 类物品 |
| 多目标识别 | 21 个框,全部 labelId=7(文本),字典外 id 0 个,739ms |
| 框分数范围 | 0.262 ~ 0.596 |
| 框尺寸范围 | 12×6 ~ 105×68 像素 |
| 物品命中率 | 0/6 |
| 文搜图对照 | 1/6(仅"折叠的衣物"命中),建索引 413ms/张,查询 22~38ms |
总结
objectDetection 适合判断"这张图里有没有人 / 有没有文档 / 是不是风景"这类画面构成问题:相册自动分类、拍照时提示"检测到文档"、视频里过滤无人画面。这些场景它够用而且很快。
不适合数物品、核对物品、按物品检索。凡是需求里出现"某某东西在不在里面"的,先回去看字典有没有那个类——15 个类里没有"物",这个坑绕不过去,只能换方案。
💡 一句话:多目标识别返回的 15 个类里没有"充电器"这个词——我拿它核对 6 样行李,它回了 21 个"文本"。
参考文献
- 多目标识别(开发指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-object-detection
- objectDetection(多目标识别)API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-object-detection-api
- 通过文本搜索图片(开发指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-text-search-image
- Core Vision Kit 目录:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-kit-guide