前言
产品需求原本只有一句话:"用户把手机靠在墙上,自己做深蹲,应用负责数次数。"
听起来是个 CV 活儿,拆开之后其实只有三件事:拿到人体的关节点、把关节点变成一个角度、用角度判断"这算不算一次"。前两件鸿蒙 7 的 Core Vision Kit 直接给了,第三件——阈值——是产品自己的决定,而且这个决定最后会成为整个功能最容易挨骂的地方。
我们在 MatePad Pro(API 26)上把这条链跑通了,样本是自己造的三张健身图。这篇文章按落地顺序记录:先确认能力边界,再定指标,最后写代码。中间踩到的四个坑,每一个都会直接影响线上口径。
先确认能力边界
上线前必须回答的四个问题,以及我们在真机拿到的答案:
| 问题 | 结论 |
|---|---|
| 支持哪些点? | 固定 17 个:鼻、左右眼、左右耳、左右肩、左右肘、左右腕、左右髋、左右膝、左右踝 |
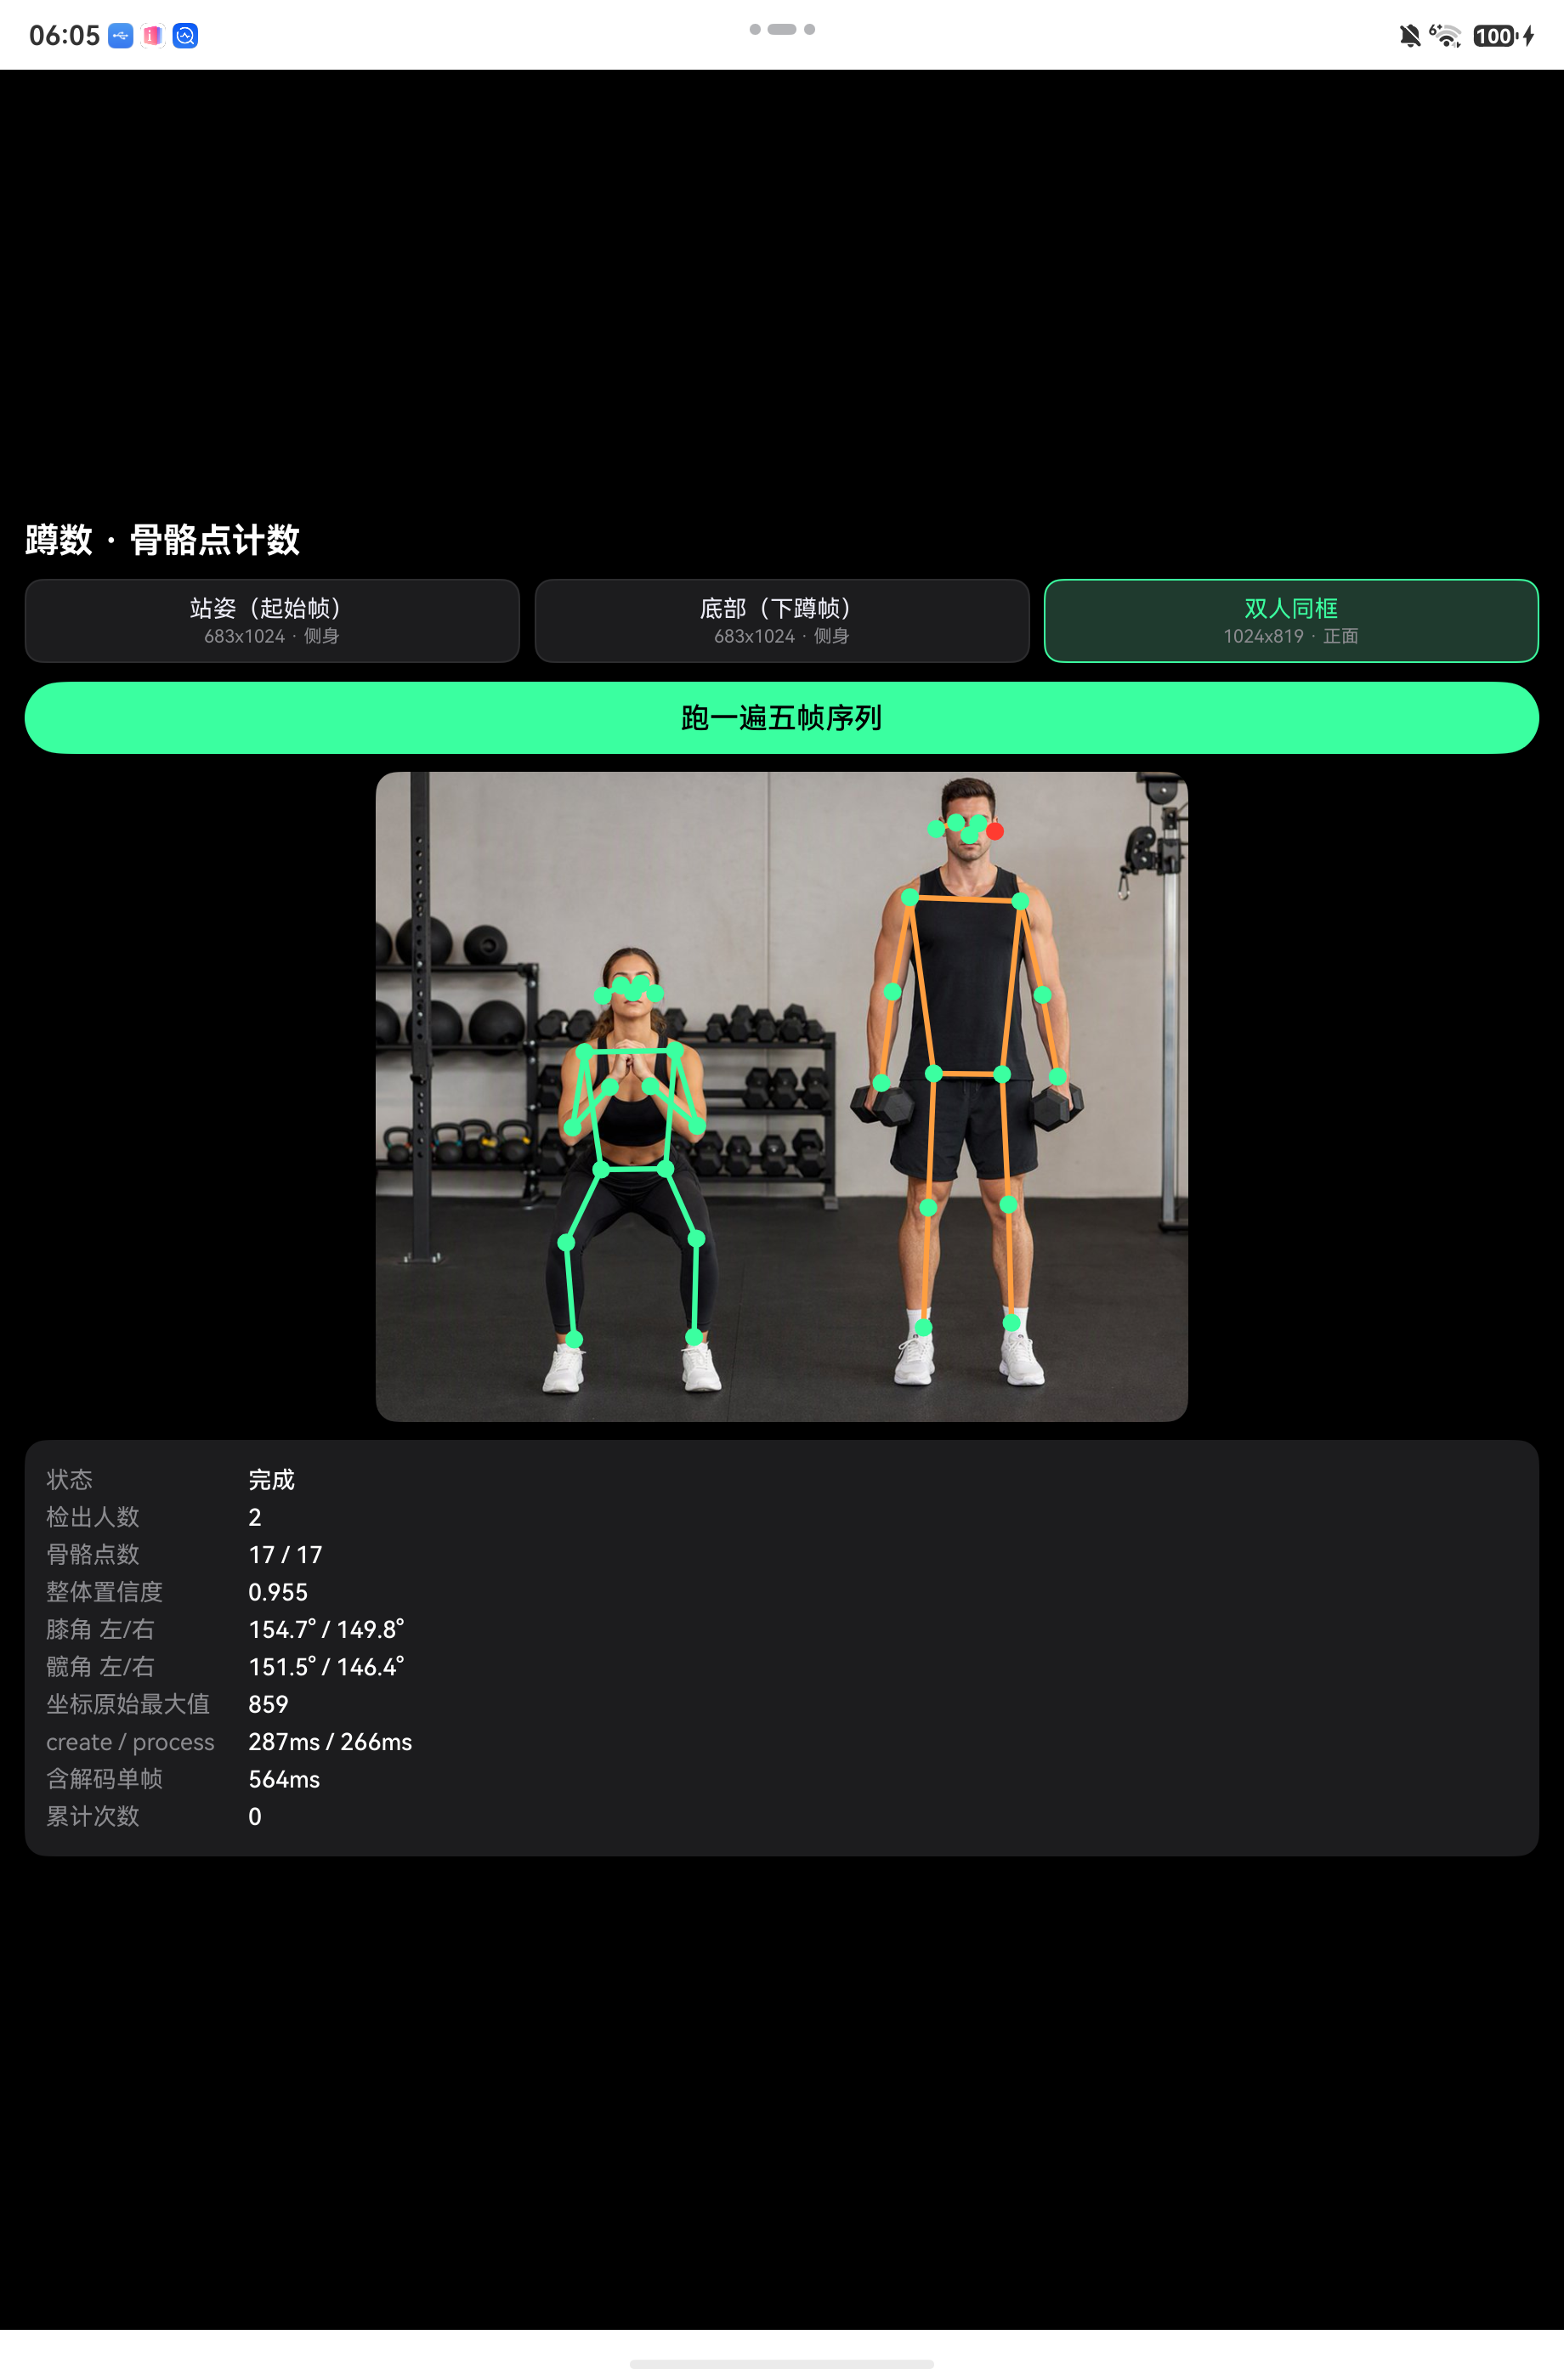
| 一次能出几个人? | 可以。双人同框返回 skeletons.length = 2,两套点都完整 |
| 多人会明显变慢吗? | 不会。单人 process 176ms,双人 175ms,基本免费 |
| 单帧耗时多少? | process 稳定在 166~285ms;create 另需 290~360ms,能不能摊掉见第 5 步 |
第四条里藏着一个坑,而且是我们自己写的代码造成的,后面细说。
另外官方 FAQ 明确提到:部分设备没有 NPU,会导致骨骼点检测变慢。所以"我这台 300ms"不能当成所有人的 300ms,上线前得留一个降级口径(比如降到"每 500ms 采一帧"),而不是假设人人都有 NPU。
指标定义:阈值就是产品
深蹲计数的通行做法是看髋-膝-踝三个点夹出来的膝角:站起来接近 180°,蹲下去变小。我们最后定的状态机只有两个状态、两个阈值:
膝角 < 110°  → 判定为「下蹲」
膝角 > 160°  → 判定为「起立」,并在 下蹲→起立 这条边上计数 +1
两个阈值而不是一条,是为了做迟滞。只用一个 135° 的线,用户在底部抖动一下就变成两次,客服工单会告诉你什么叫真实世界。
真正需要产品拍板的是"蹲到多少度才算蹲"。我们在双人样本里量到一个特别有用的数字:画面里那位女士明明在做高脚杯深蹲,肉眼看着"蹲下去了",膝角实测 154.7°。也就是说,如果阈值定在 110°,她这组动作一次都不会被记上。
这就是这类功能最难的地方:算法没错,用户的"蹲"和产品的"蹲"不是一个东西。我们的处理是上线时给一个"灵敏度"开关(110° / 140° 两档),而不是替用户决定他蹲得够不够深。
第 1 步:把图变成 PixelMap
样本放在 rawfile 里,读出来直接构造 ImageSource:
static async decode(bytes: Uint8Array): Promise<image.PixelMap> {
  const buffer: ArrayBuffer =
    bytes.buffer.slice(bytes.byteOffset, bytes.byteOffset + bytes.byteLength);
  const source: image.ImageSource = image.createImageSource(buffer);
  const pm: image.PixelMap = await source.createPixelMap();
  await source.release();
  return pm;
}
注意 Uint8Array.buffer 要按 byteOffset / byteLength 切片,直接拿 .buffer 在别的样本上会带出多余字节。
第 2 步:一次检测拿回 17 个点
const detector = await skeletonDetection.SkeletonDetector.create();
const request: visionBase.Request = { inputData: { pixelMap: pm } };
const data: skeletonDetection.SkeletonDetectionResponse = await detector.process(request);
await detector.destroy();接口本身没有参数可调:没有阈值、没有"最多几个人"、没有精度档位。SkeletonDetector.process 的注释里还写了一句"仅支持单任务处理,不支持批量任务",所以别指望一次塞多张图。
第 3 步:算膝角,先处理那三个假点
拿回的角度函数很朴素,余弦定理:
static angle(a: SkelPoint, b: SkelPoint, c: SkelPoint): number {
  const v1x = a.x - b.x, v1y = a.y - b.y;
  const v2x = c.x - b.x, v2y = c.y - b.y;
  const d = v1x * v2x + v1y * v2y;
  const n = Math.hypot(v1x, v1y) * Math.hypot(v2x, v2y);
  if (n <= 0) { return -1; }
  return Math.round(Math.acos(Math.max(-1, Math.min(1, d / n))) * 1800 / Math.PI) / 10;
}
真正重要的是调用它之前那一步。侧身下蹲这张图,17 个点的置信度依次是:
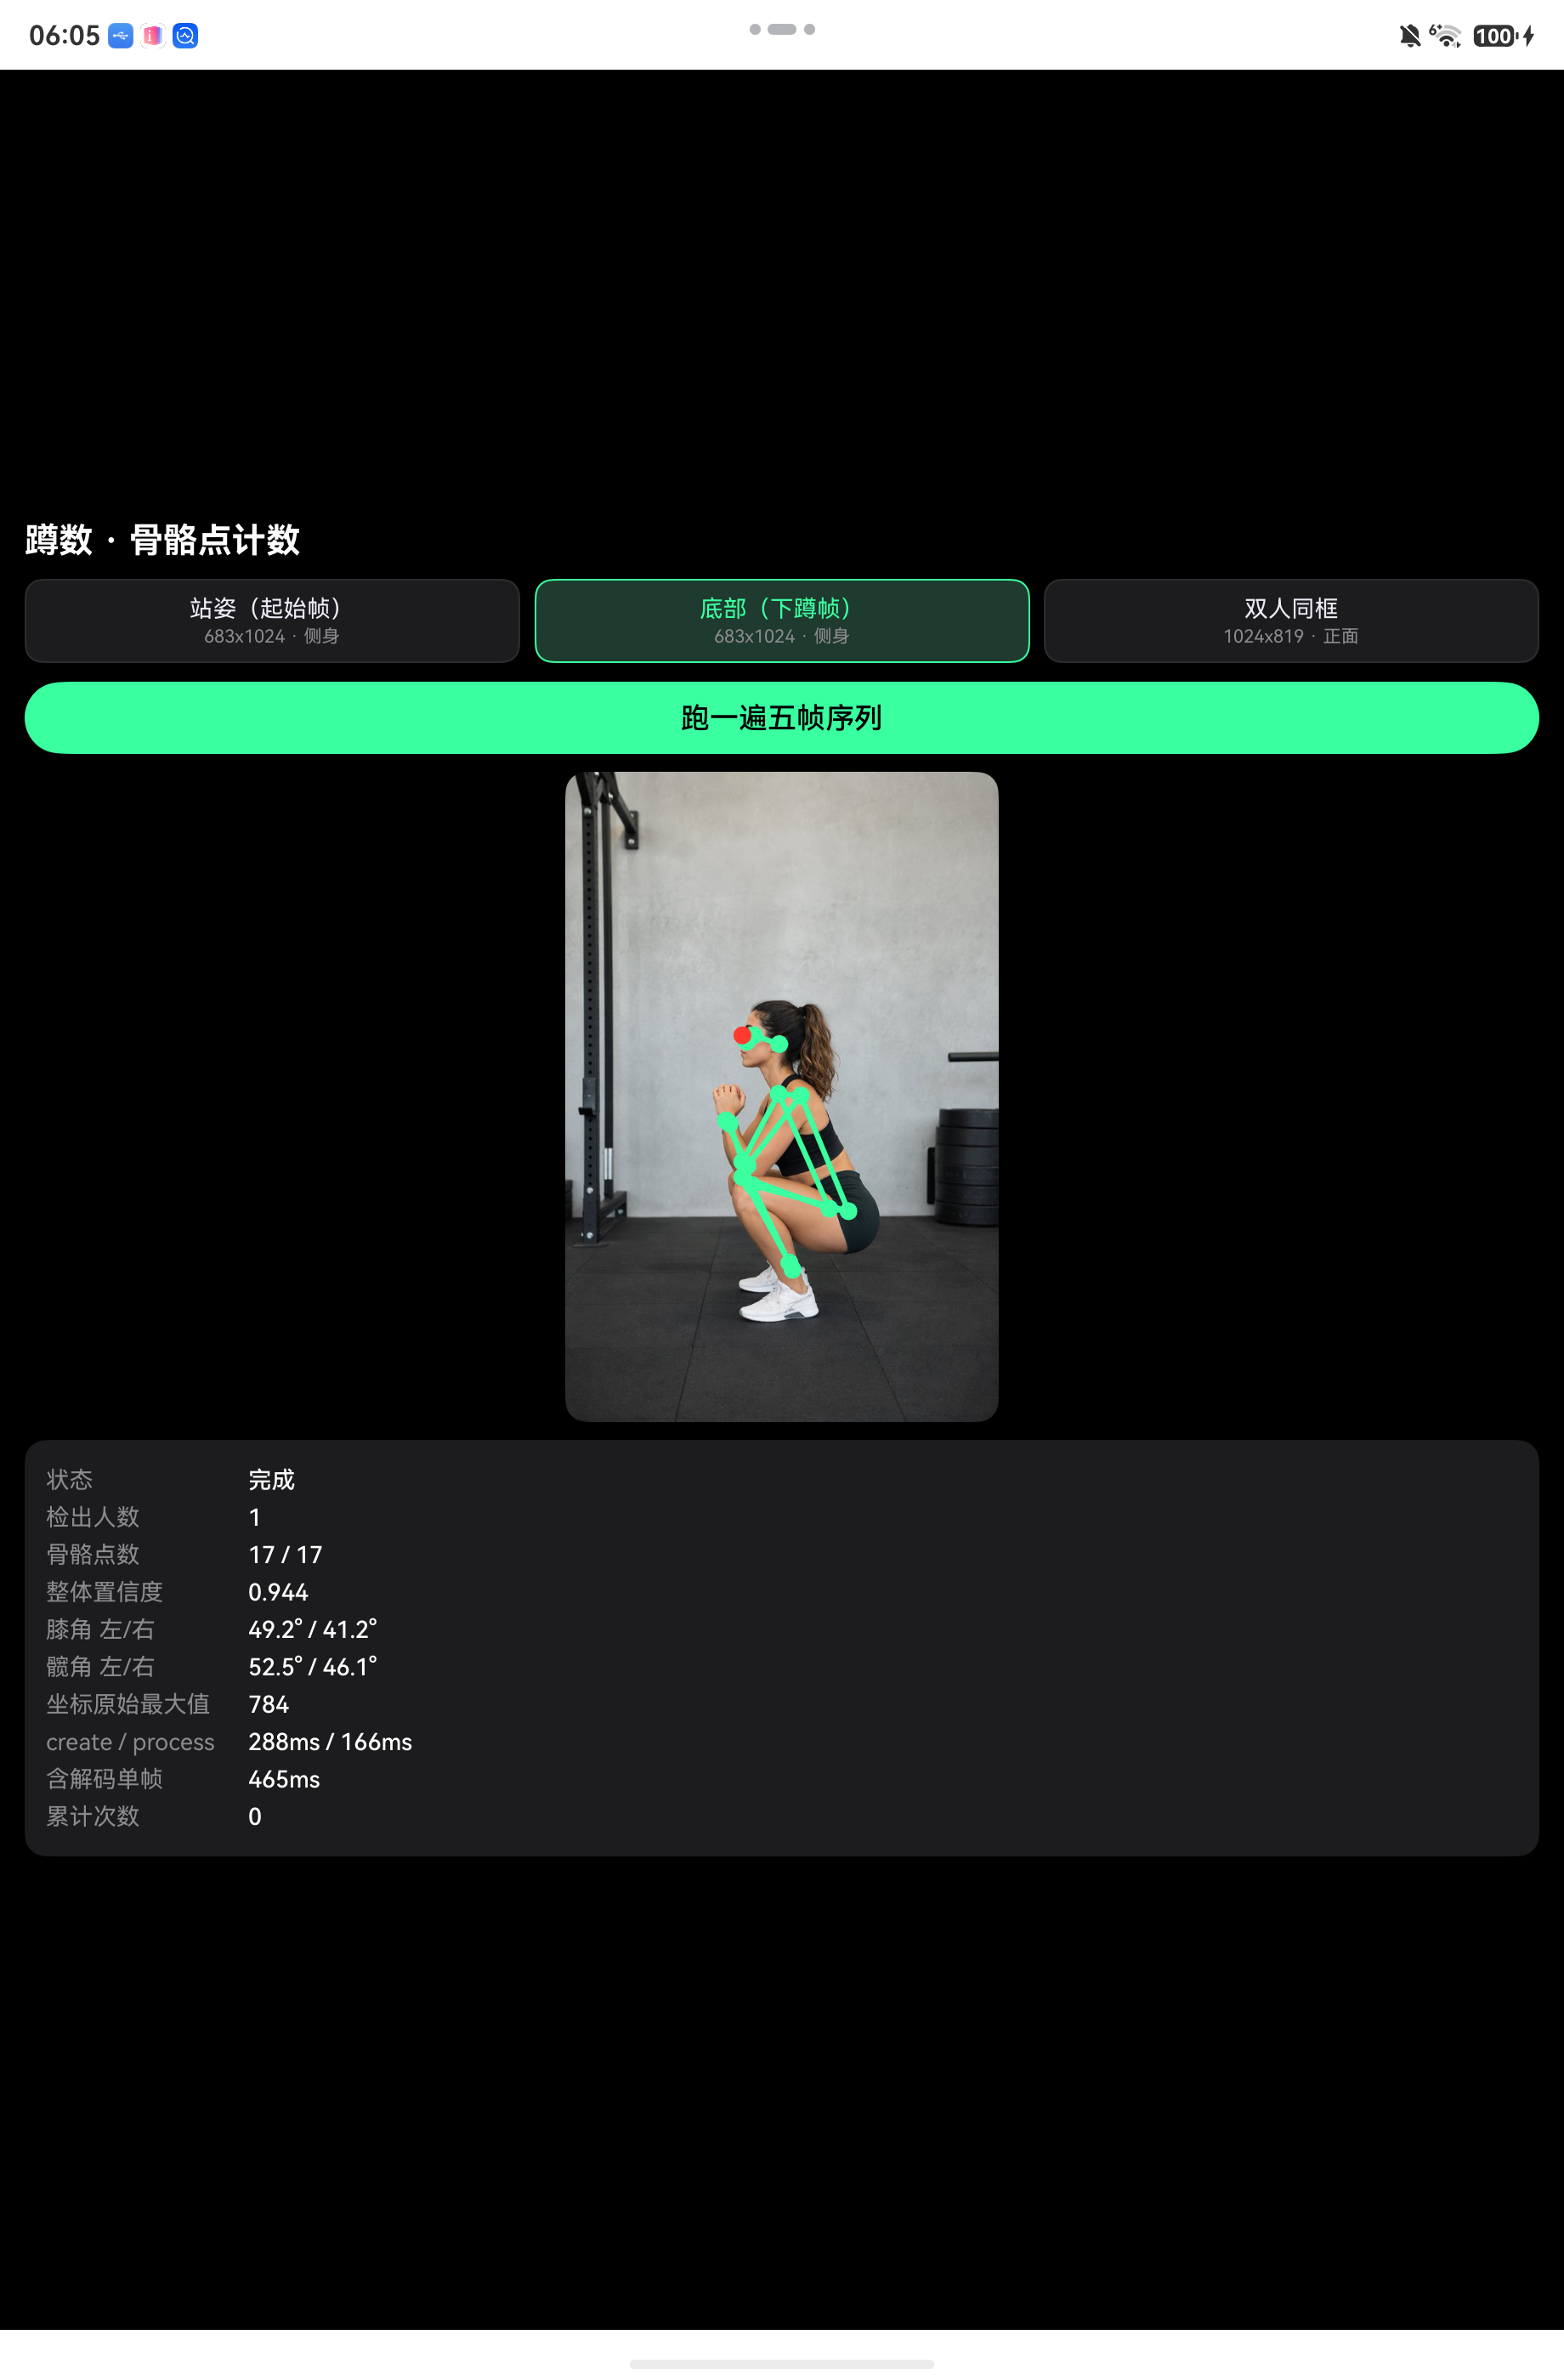
95,95,51,94,0,100,99,98,91,97,91,98,97,97,95,92,91第 5 个(右耳)是 0,而它的坐标是 (0, 0)。这就是第一个坑:points 永远是 17 个元素,检不出来的点不会被删掉,而是给你一个坐标 (0,0) + 置信度 0。如果这个点正好在你要算的角上(比如脚踝出画),余弦定理会照常算出一个"看起来很合理"的角度,你根本发现不了。
所以判据不能是"点存在吗",只能是"score 够不够"。我们在 pick() 里对 score 为 0 的点直接返回哨兵值,角度函数返回 -1,上层遇到 -1 就不更新状态——宁可少计一次,也不要计错。
第 4 步:左右是解剖学左右,不是画面左右
双人样本里,左边那位女士的肘部横坐标是:
LEFT_ELBOW  x = 405
RIGHT_ELBOW x = 248
左手在画面右边。也就是说 LEFT_* 指的是人自己的左手,正面朝向镜头时和画面左右正好相反。侧身图里这个差异会小得多(髋部 446 vs 416),基本靠置信度区分。
对产品的影响很具体:只要你的功能涉及"左右各做几次"(比如单侧哑铃),必须明确告诉用户是解剖学左右,否则用户一定认为数反了。我们最后在设置页里放了"镜像显示"开关,而不是让用户去理解这个词。
第 5 步:把 detector 挪出循环
前面说的"我们自己造成的坑"就是这个。最初的写法每帧都 create() → process() → destroy(),五帧序列实测:
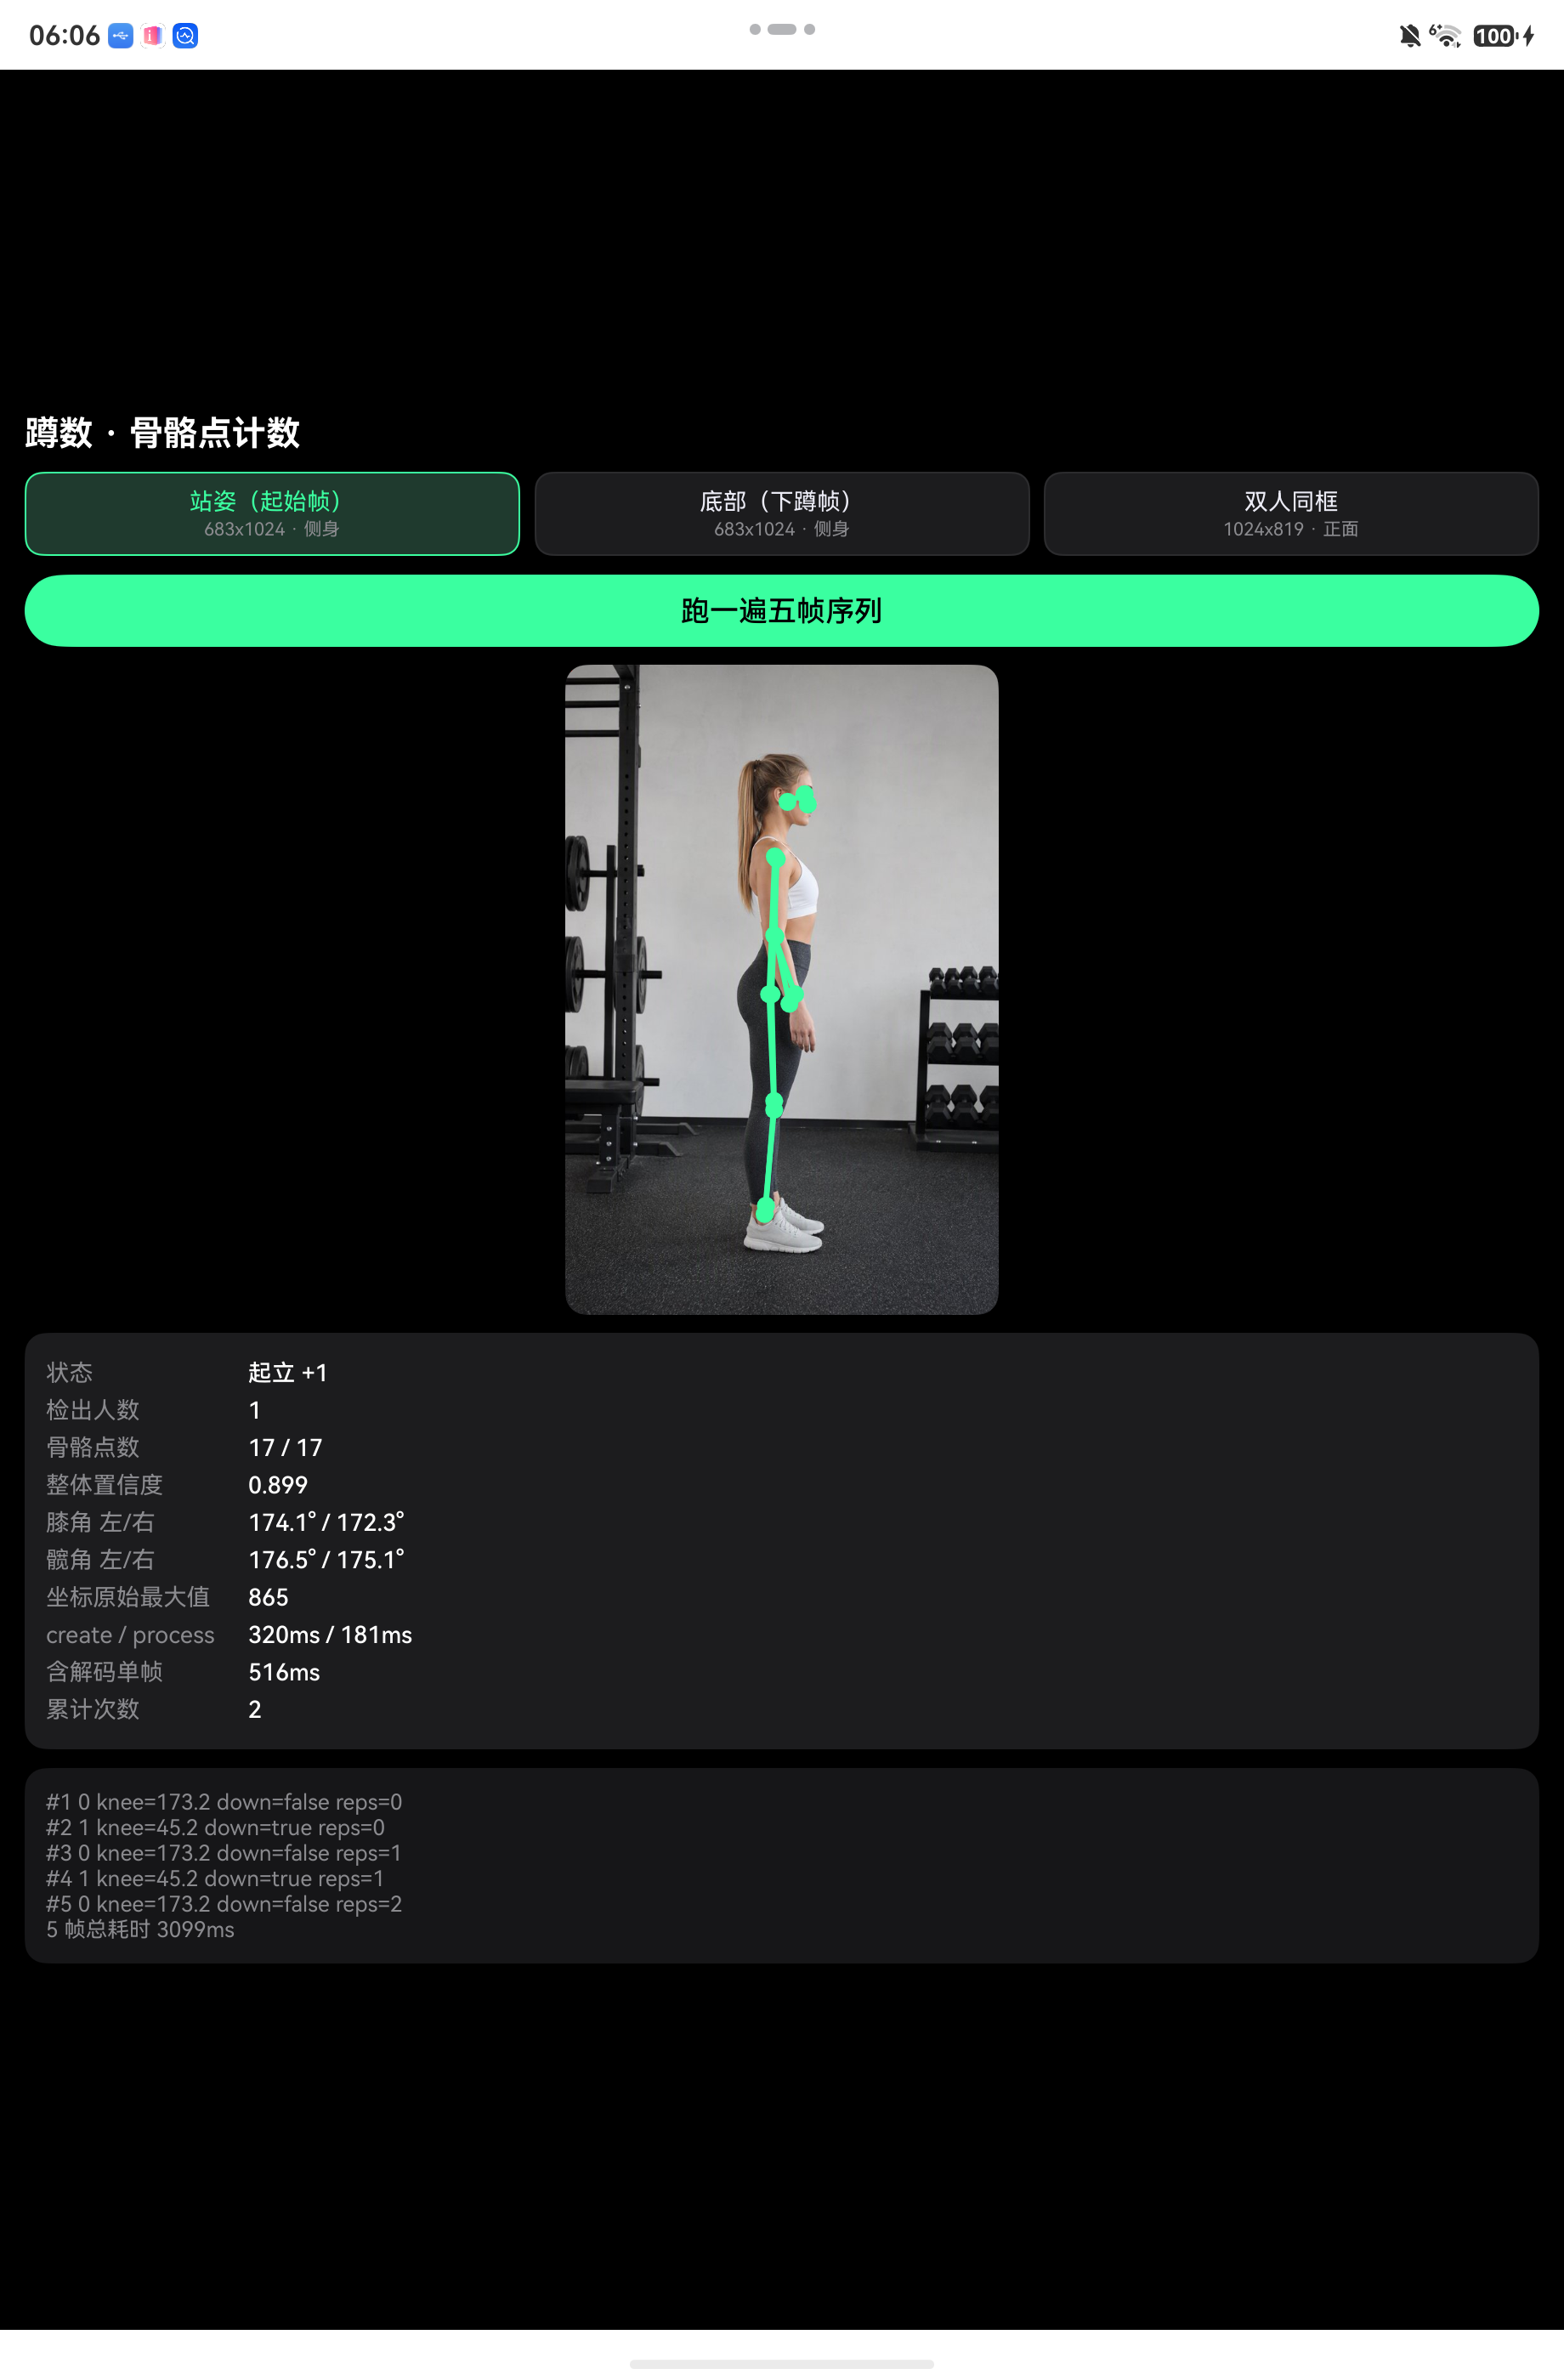
#1 stand  knee=173.2 down=false reps=0
#2 bottom knee=45.2  down=true  reps=0
#3 stand  knee=173.2 down=false reps=1
#4 bottom knee=45.2  down=true  reps=1
#5 stand  knee=173.2 down=false reps=2
5 帧总耗时 3397ms
计数 2 次,正确。但 3397 / 5 = 680ms 一帧,只有 1.5fps,做实时相机流完全不能用。拆开看:create 290~360ms,process 175~220ms。也就是说将近一半的时间花在反复创建同一个模型上。
于是改成"进页面 create 一次、退出 destroy",同样的五帧再跑一遍:
warm0 elapsed=453ms   warm1 elapsed=622ms   warm2 elapsed=808ms
warm3 elapsed=995ms   warm4 elapsed=1187ms
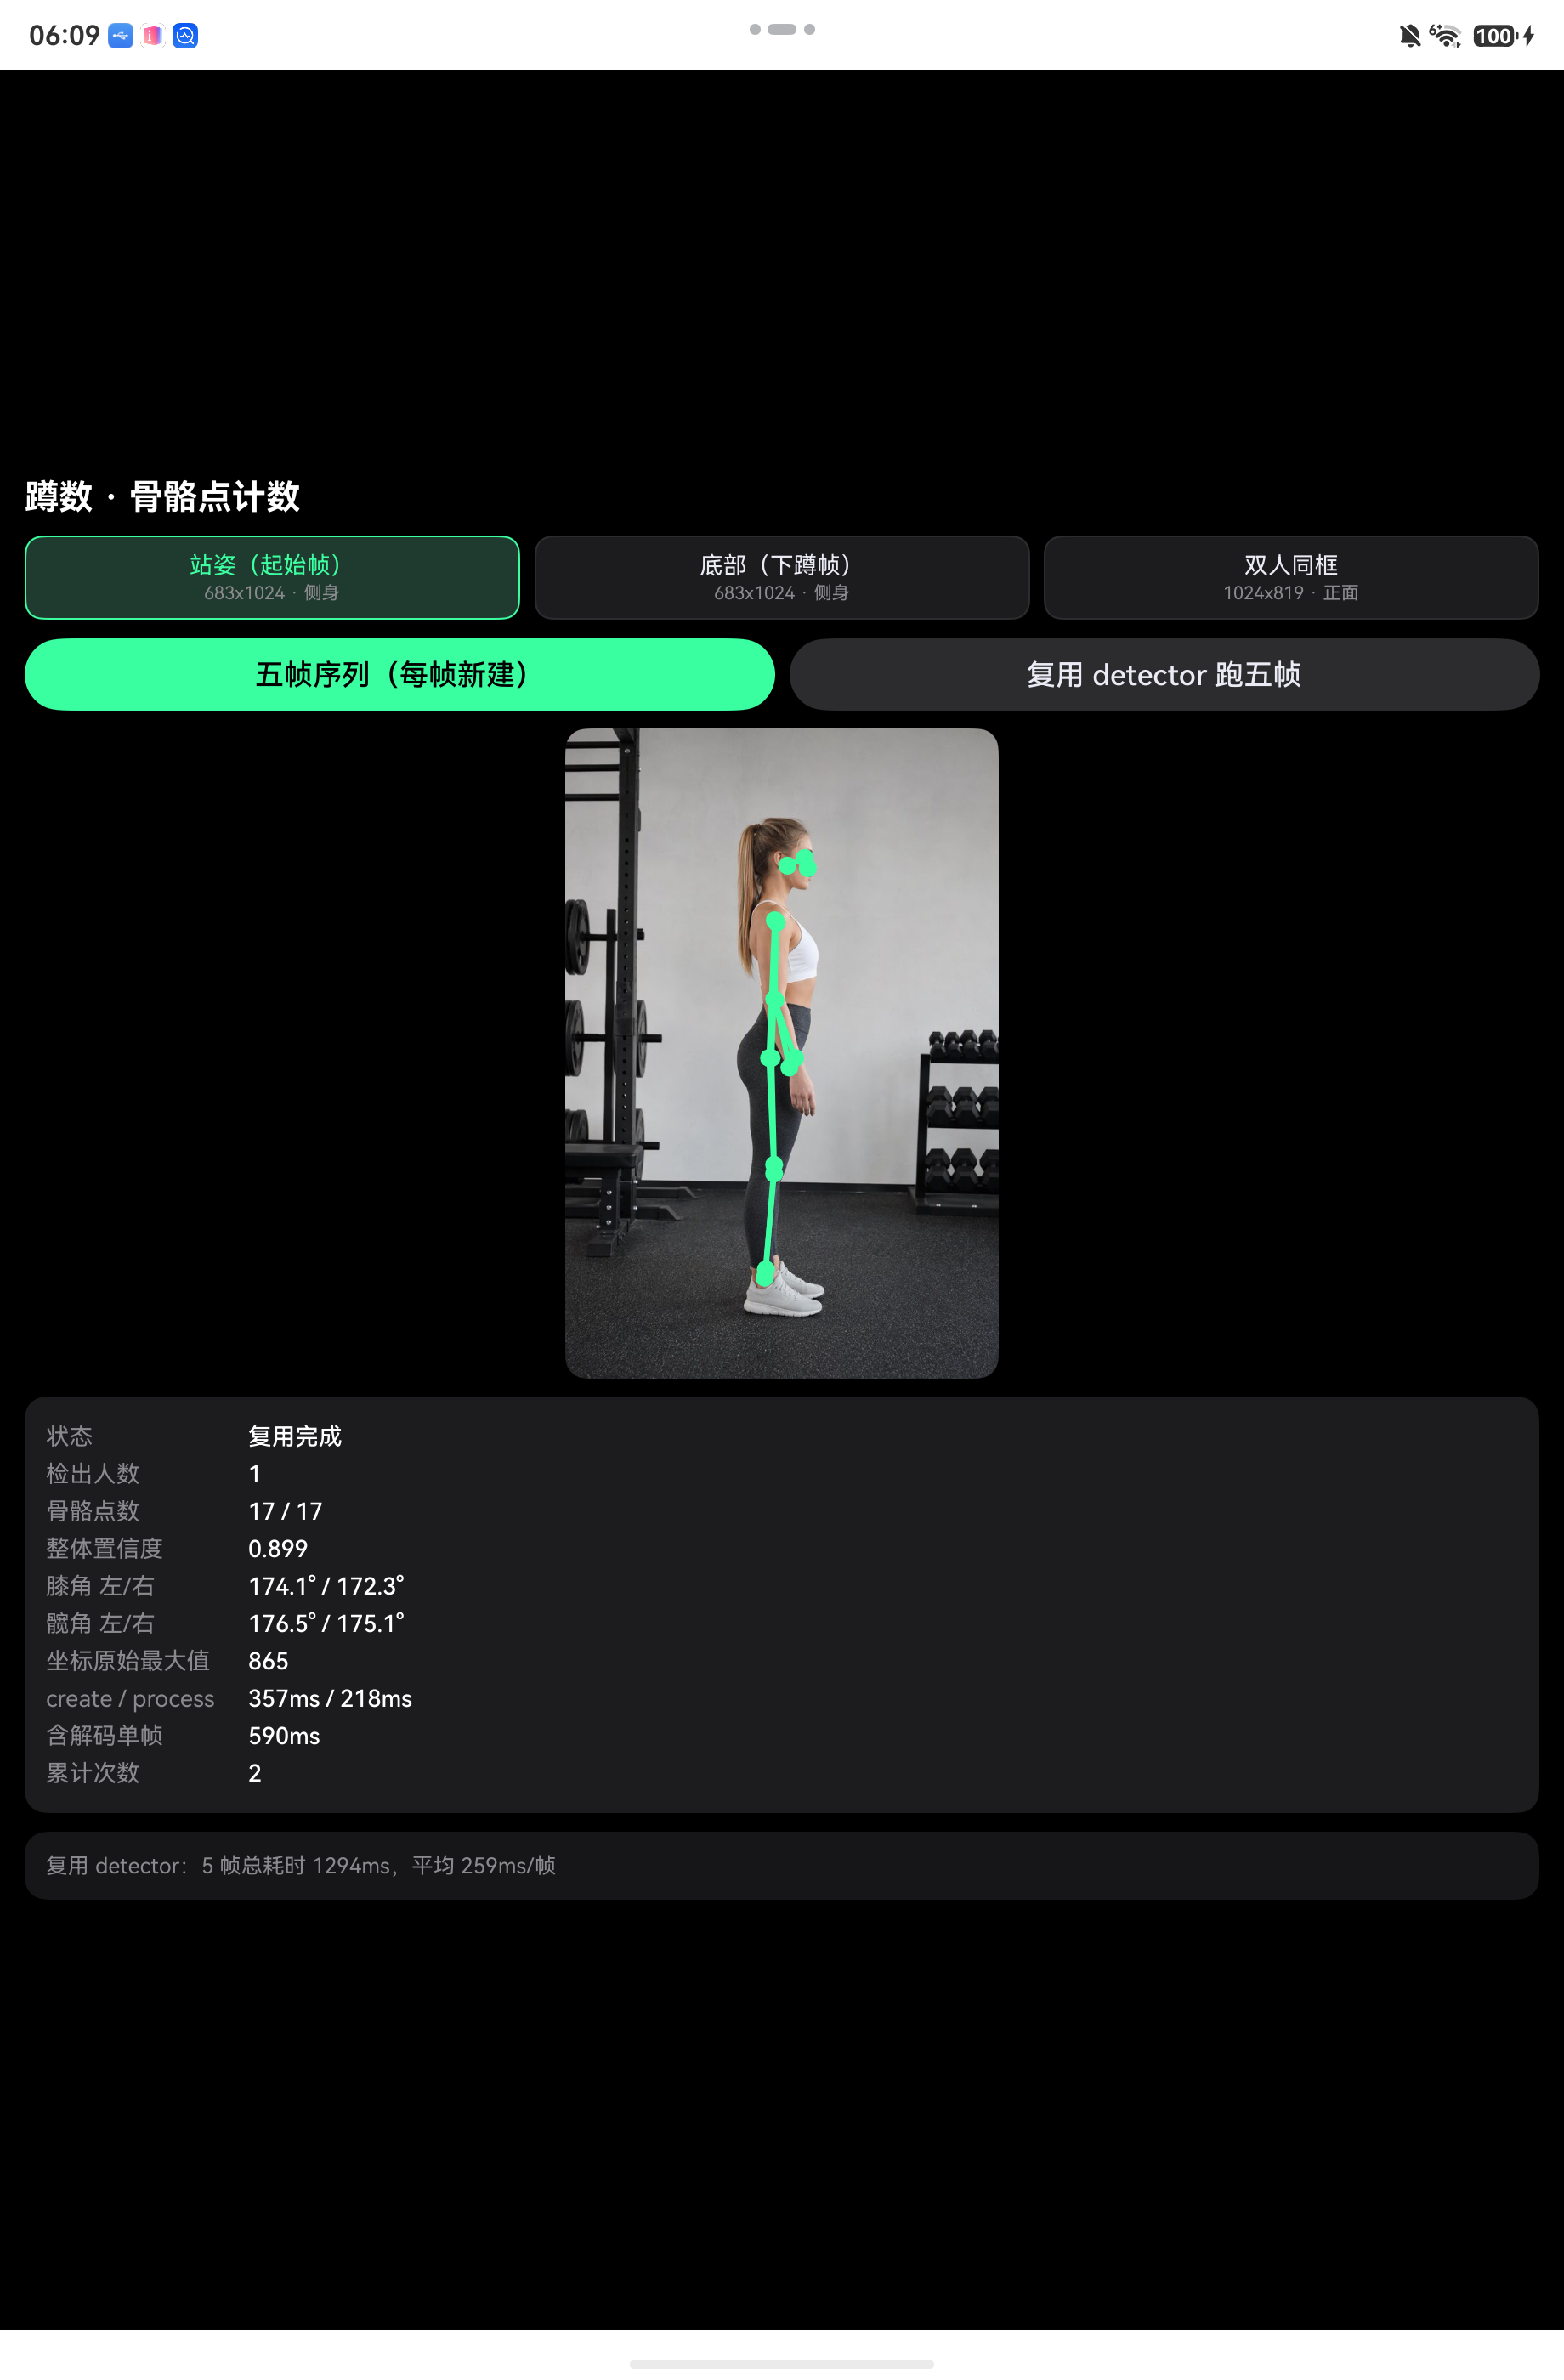
warm total=1294ms createOnly=287ms frames=5
1294ms / 5 = 259ms 一帧,比原来快 2.6 倍。注意每帧之间的间隔(169ms、186ms、187ms、192ms)就是 process 的真实成本,非常稳;第一次的 453ms 里包含了 create 的 287ms。
这个改动不难,但如果你像我们一开始那样照着示例代码抄,很容易忽略——官方示例都是单张图,看不出循环成本。
第 6 步:score 为 0 是遮挡信号,而且是可复现的
计数功能一旦上线,最常被问的是"为什么这次没数"。所以我们把两张侧身图各重复检测了 5 次,把 17 个点的置信度逐位对比:
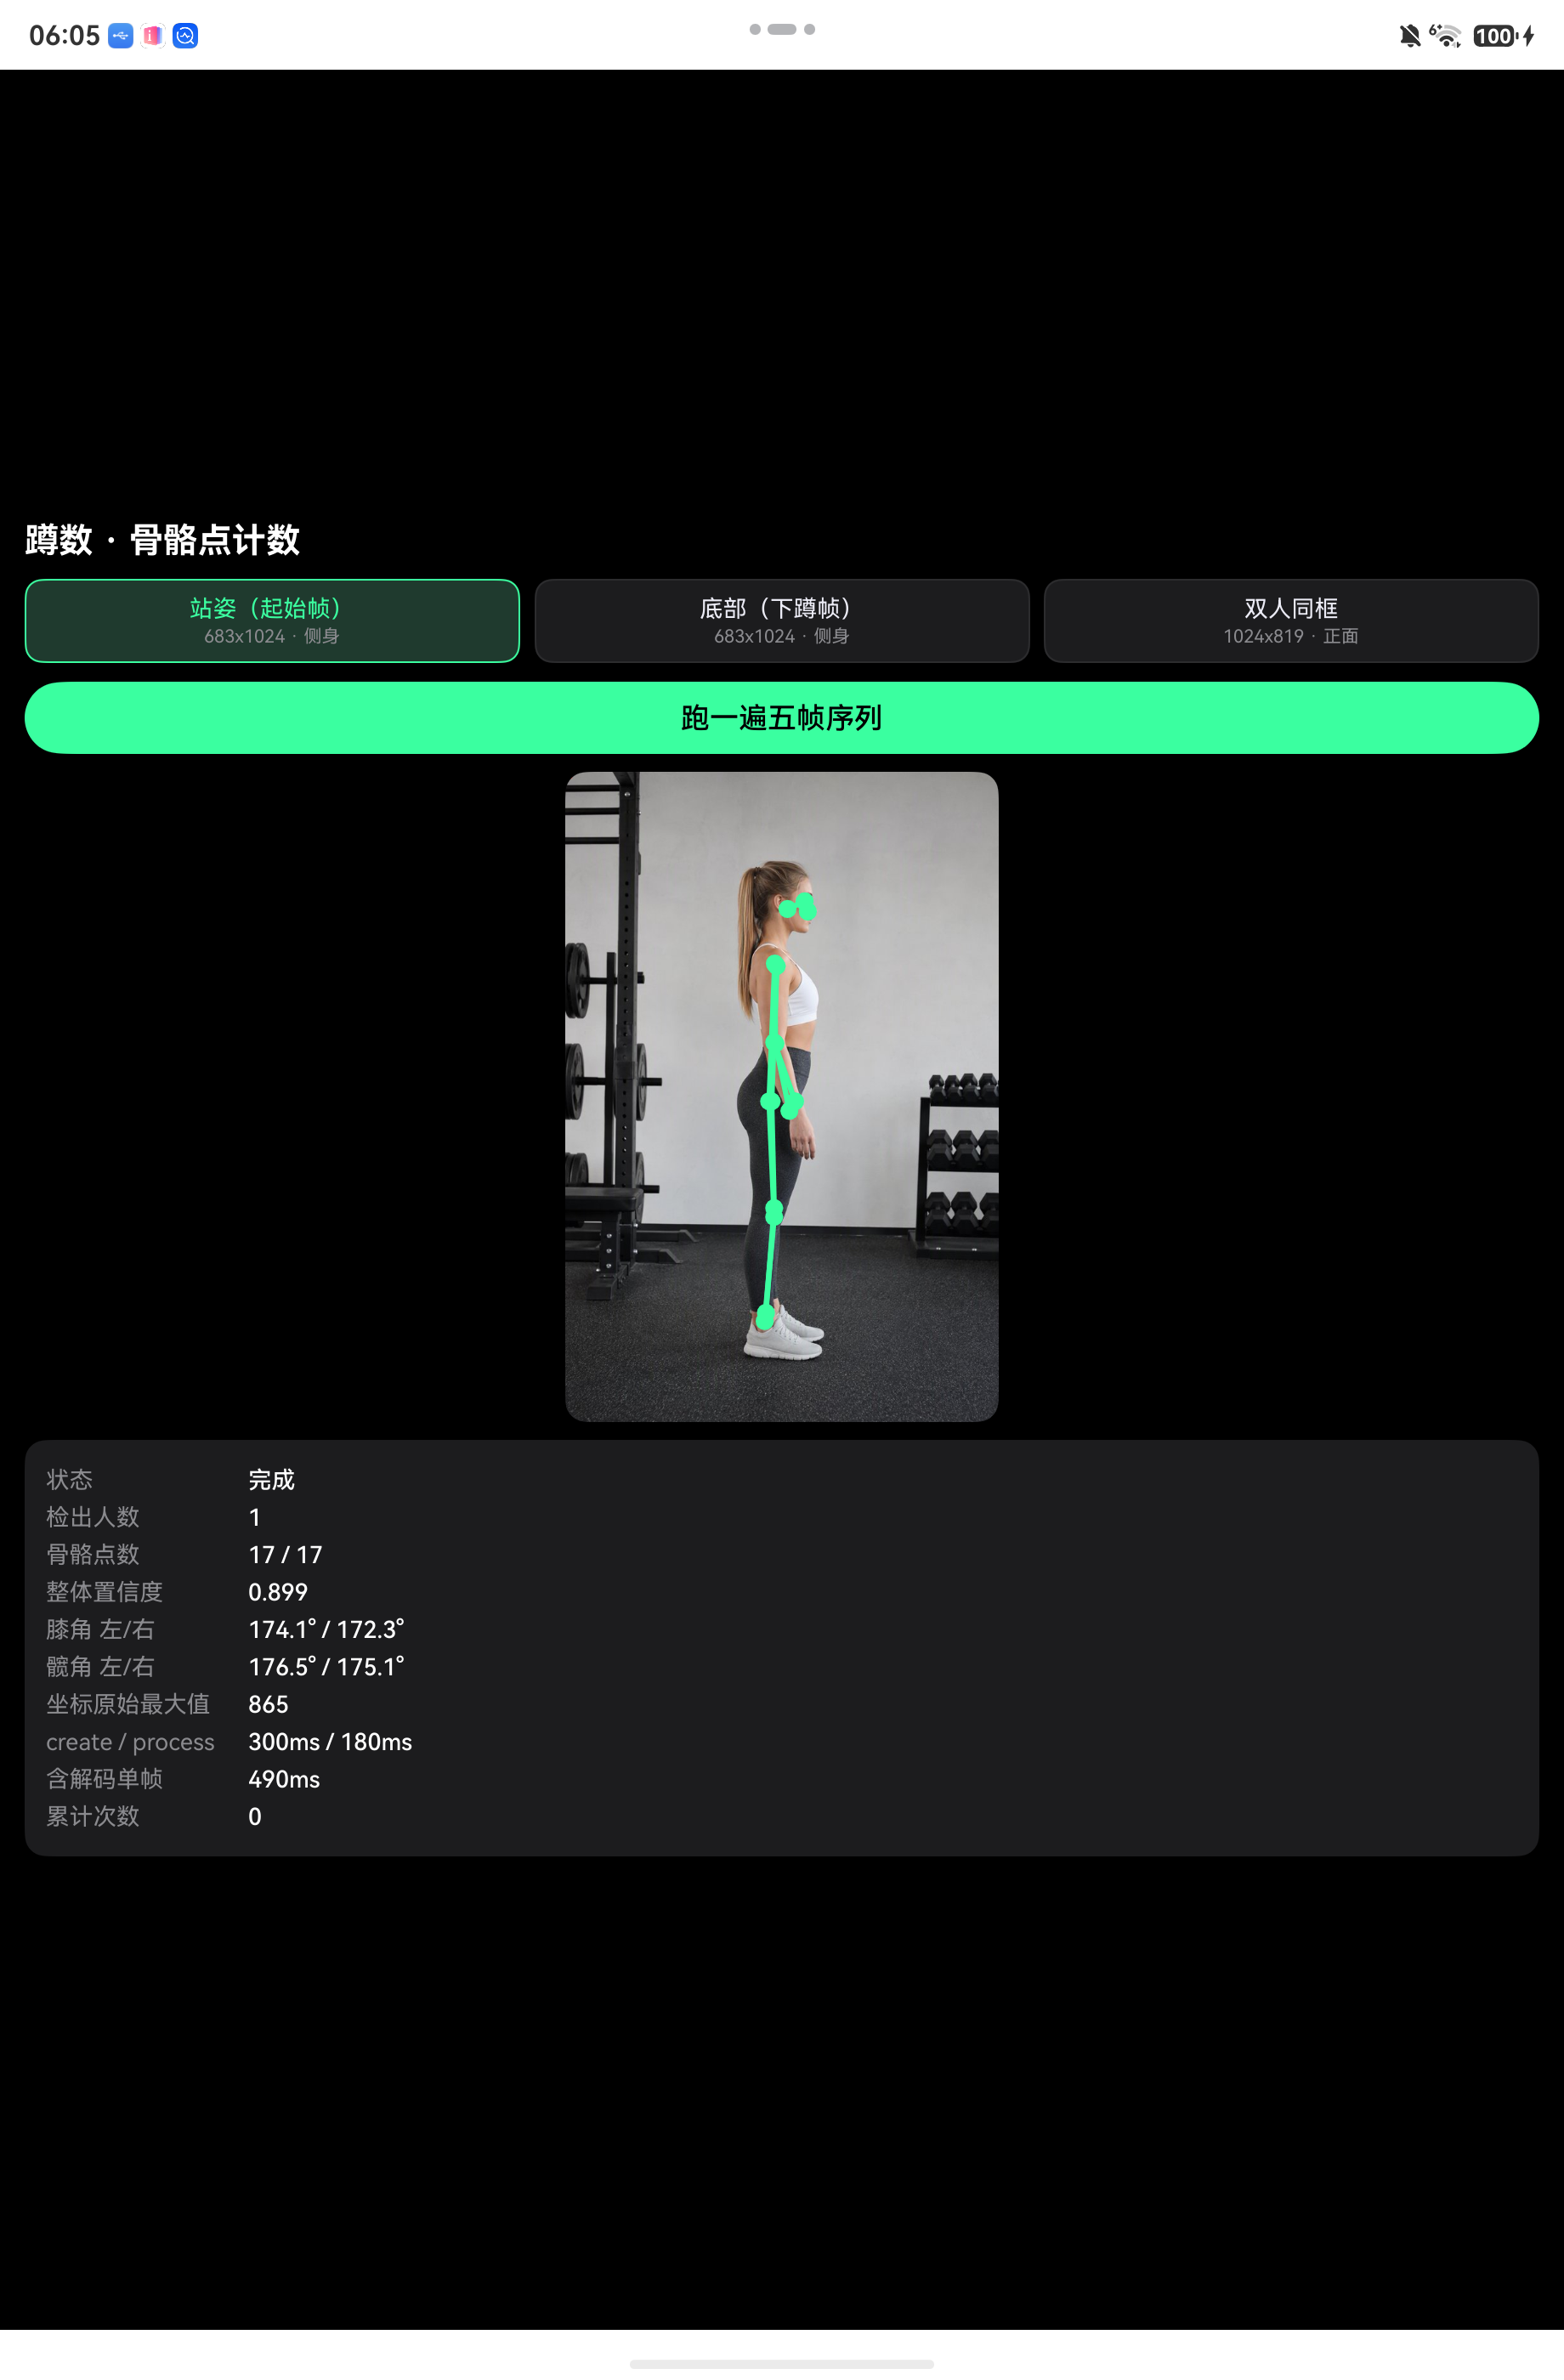
站姿图(5 次完全一致):92,0,91,0,94,98,99,91,97,90,96,99,99,98,99,94,94
底部图(5 次完全一致):95,95,51,94,0,100,99,98,91,97,91,98,97,97,95,92,91
两点结论。
同一张图的输出逐位可复现,不是随机噪声。这意味着 score 可以放心当判据用,不需要在时间维度上做投票平滑。
**为 0 的点恰好是被挡住的那一侧。**站姿图里人是右侧面朝向镜头,为 0 的是左眼、左耳(索引 1、3),坐标同时归零;底部图为 0 的是右耳。也就是说 score == 0 是一个确定性的"这个点在当前帧不可见"信号,而不是"检测失败"。
这条对产品的价值很直接:侧身机位做深蹲计数,本来就会有一半的肢体被挡住。既然模型明确告诉你哪一侧不可见,正确的做法是只用可见侧算角度,而不是要求用户必须正对镜头——后者会直接把"手机靠墙放"这个使用场景作废。
真机数据
MatePad Pro(HarmonyOS 7 / API 26,1840×2800,序列号略)。每张图重复检测 5 次,结果逐位一致,下表取任一次:
| 样本 | 尺寸 | 检出 | 点数 | 整体置信度 | 膝角(左/右) | create | process |
|---|---|---|---|---|---|---|---|
| 站姿·侧身 | 683×1024 | 1 | 17/17 | 0.899 | 174.1° / 172.3° | 289~357ms | 177~285ms |
| 底部·侧身 | 683×1024 | 1 | 17/17 | 0.944 | 45.2°(均值) | 288~367ms | 166~207ms |
| 双人·正面 | 1024×819 | 2 | 17/17 ×2 | 0.955 / 0.952 | 154.7° / 149.8° | 287ms | 175~266ms |
五帧序列的两种跑法:
| 跑法 | 5 帧总耗时 | 平均单帧 | 折算帧率 |
|---|---|---|---|
| 每帧 create/destroy | 3154 / 3397ms | 631~680ms | 约 1.5fps |
| 复用同一个 detector | 1294ms | 259ms | 约 3.9fps |
坐标单位是图像像素,不是归一化值——站姿帧最大坐标 865,底部帧 784,都落在各自图高 1024 之内。绘制时按 canvasW / imgW 缩放即可,不要按 0~1 处理。
总结
这条能力适合"事后计数"和"低帧率姿态判断":跳绳、深蹲、平板支撑的角度提醒、体测动作是否达标。它的输入就是一张静图,所以任何能拿到 PixelMap 的地方都能用,包括相册里的历史视频抽帧。
不适合实时姿态纠正。复用 detector 之后单帧 259ms、约 3.9fps,做"膝盖别内扣"这种实时语音提醒,画面会明显跟不上动作。真要做实时,方向是降分辨率 + 只算关键角,而不是指望接口本身变快。
💡 一句话:骨骼点检测给你的 17 个点里,检不出来的那个不会消失,而是变成坐标 (0,0)——先按 score 过滤,再谈角度。
参考文献
- 骨骼点检测(开发指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-skeleton-detection
- skeletonDetection(骨骼点检测)API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-skeleton-detection-api
- visionBase(通用数据结构)API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-vision-base-api
- Core Vision Kit 目录:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-kit-guide