前言
出差回来要贴发票。一百多张,每张都要把金额、日期、发票代码抄进报销表,抄错一个小数点就得重来。
如果有个功能:手机对着发票拍一下,三个字段自动落进表格——这篇文章就带你做这个。
拆开看,这件事只有两小步:把图里的字认出来,和从一堆字里挑出我要的三个值。
第二步听起来简单,其实坑最多。我们后面会亲眼看到它把 11.04 当成报销金额。
第一步交给鸿蒙的现成能力:通用文字识别(textRecognition),归属 @kit.CoreVisionKit。不需要联网、不需要申请任何权限、不用自己塞模型。
这里要特别说明一点:发票上有公司税号,属于敏感数据。"识别过程完全在设备本地完成"这件事,对能不能上架、用户愿不愿意用,都是关键。
先认识一下它给的数据长什么样
很多人以为 OCR 返回的就是一串字符串。不完全是,它的返回是带层级的:
TextRecognitionResult
├── value: string                    // 全部文本,就是我们以为的那串字
└── blocks: TextBlock[]              // 文本块(一段)
        ├── value: string
        └── lines: TextLine[]        // 行
                ├── value: string
                ├── cornerPoints: PixelPoint[]   // 这一行的四个角点
                └── words: TextWord[]            // 词
                        ├── value: string
                        └── cornerPoints: PixelPoint[]
- OCR(Optical Character Recognition):光学字符识别,把图片里的文字转成可编辑文本。
- PixelPoint:一个二维坐标点
{ x, y }。- cornerPoints:四个角点,因为一行文字可能是倾斜的,用矩形框表达不了。
注意两点:
- 坐标是
cornerPoints(四个点),不是boundingBox(一个矩形)。 你想做"点哪复制哪",得用这四点算区域。 value是拼接结果,blocks / lines / words才是结构。 只拿value做正则,等于放弃了模型已经帮你切好的行。
接口本身很薄:
textRecognition.init(): Promise<boolean>                                  // 5.0.0(12) 起
textRecognition.release(): Promise<void>                                  // 5.0.0(12) 起
textRecognition.getSupportedLanguages(): Promise<Array<string>>
textRecognition.recognizeText(visionInfo, configuration?): Promise<TextRecognitionResult>
configuration 目前只有一个字段 isDirectionDetectionSupported——是否允许旋转文字方向检测。
我们一步一步写
第一步:起一个引擎壳子
init() 是全局的,不要每次识别都调。我们用一个布尔位记住状态:
export class OcrRunner {
  private inited: boolean = false;

  async init(): Promise<void> {
    if (this.inited) {
      return;
    }
    try {
      this.inited = await textRecognition.init();
    } catch (err) {
      const e = err as BusinessError;
      throw new Error(`OCR 服务初始化失败(${e.code}):${e.message}`);
    }
  }

  async release(): Promise<void> {
    if (!this.inited) {
      return;
    }
    await textRecognition.release();
    this.inited = false;
  }
}
顺手把 getSupportedLanguages() 打出来看看它到底认几种字。我们在真机上实测返回:
zh-CN / en / ja / ko / zh-TW五种。也就是说简中、繁中、英、日、韩都在能力范围内——但它是按字符识别的,不做语义纠错,这一点第三节末尾会看到后果。
第二步:拿到 PixelMap
样票走 rawfile,真实票据从相册选。两条路都是 createImageSource → createPixelMap:
async decode(bytes: ArrayBuffer): Promise<image.PixelMap> {
  const source: image.ImageSource = image.createImageSource(bytes);
  const pm: image.PixelMap = await source.createPixelMap();
  await source.release();
  return pm;
}
从相册导入时传 fd:image.createImageSource(fd.fd)。
别忘了 source.release()。ImageSource 持有原生资源,页面反复进出会累积。
第三步:识别
const info: textRecognition.VisionInfo = { pixelMap: src };
const conf: textRecognition.TextRecognitionConfiguration = { isDirectionDetectionSupported: rotate };
const res: textRecognition.TextRecognitionResult = await textRecognition.recognizeText(info, conf);
然后自己数一遍结构(返回值里没有现成的行数和词数):
let lines: number = 0;
let words: number = 0;
for (let i = 0; i < res.blocks.length; i++) {
  const bl: textRecognition.TextLine[] = res.blocks[i].lines;
  lines += bl.length;
  for (let j = 0; j < bl.length; j++) {
    words += bl[j].words.length;
  }
}
这三个数字一定要显示出来,理由见下一节。
第四步:抽字段——真正的坑在这里
我们的目标是三个值:金额、日期、号码。第一版正则我是这么写的(这是错的,故意留着):
const money = raw.match(/([¥¥]\s*\d[\d,]*(?:\.\d{1,2})?)|(\d[\d,]*\.\d{2})/);看起来很合理:匹配一个带货币符号的金额,或者一个两位小数。
真机跑出来的结果:金额 = 11.04。
为什么?因为增值税专用发票的表格里有十几行明细,每行都有单价、金额、税额三个小数。11.04 是票面上第一个出现的两位小数——它命中了正则的第二个分支,而正则只返回第一个匹配。真正的价税合计 ¥1401.08 在票面靠下的位置,根本没轮到。
修正的思路:不要找"第一个像金额的",要找"最像合计的"。票面上带 ¥ 符号的金额里,最大的那个就是价税合计:
/** 票面上有十几个小数,取带货币符号的最大值才是价税合计。 */
static pickAmount(raw: string): string {
  const all: RegExpMatchArray | null = raw.match(/[¥¥]\s*(\d[\d,]*(?:\.\d{1,2})?)/g);
  if (!all || all.length === 0) {
    return '未识别';
  }
  let best: number = -1;
  let bestText: string = '';
  for (let i = 0; i < all.length; i++) {
    const num: number = Number(all[i].replace(/[^\d.]/g, ''));
    if (num > best) {
      best = num;
      bestText = all[i].trim();
    }
  }
  return bestText;
}

/** 优先取标签后的编号,避免命中统一社会信用代码。 */
static pickCode(raw: string): string {
  const m: RegExpMatchArray | null =
    raw.match(/(?:发票代码|發票代码|发票号码|發票号码|号码|码)[::]?\s*(\d{8,20})/);
  if (m) {
    return m[1];
  }
  const any: RegExpMatchArray | null = raw.match(/\d{10,20}/);
  return any ? any[0] : '未识别';
}改完再跑,三个字段全对:金额 ¥1401.08、日期 2024年04月24日、号码 044032100111。
请注意这里的一个细节:pickCode 里我把繁体 發票代码 也写进了候选。原因是下面要讲的那个现象。
第五步:别忘了 release
aboutToDisappear(): void {
  this.runner.release();
}真机运行结果
测试机:HUAWEI MatePad Pro(MRDI-W00),HarmonyOS 7.0.0.107,API 26。样票是一张 720×900 的增值税发票照片。
识别完成后的界面:
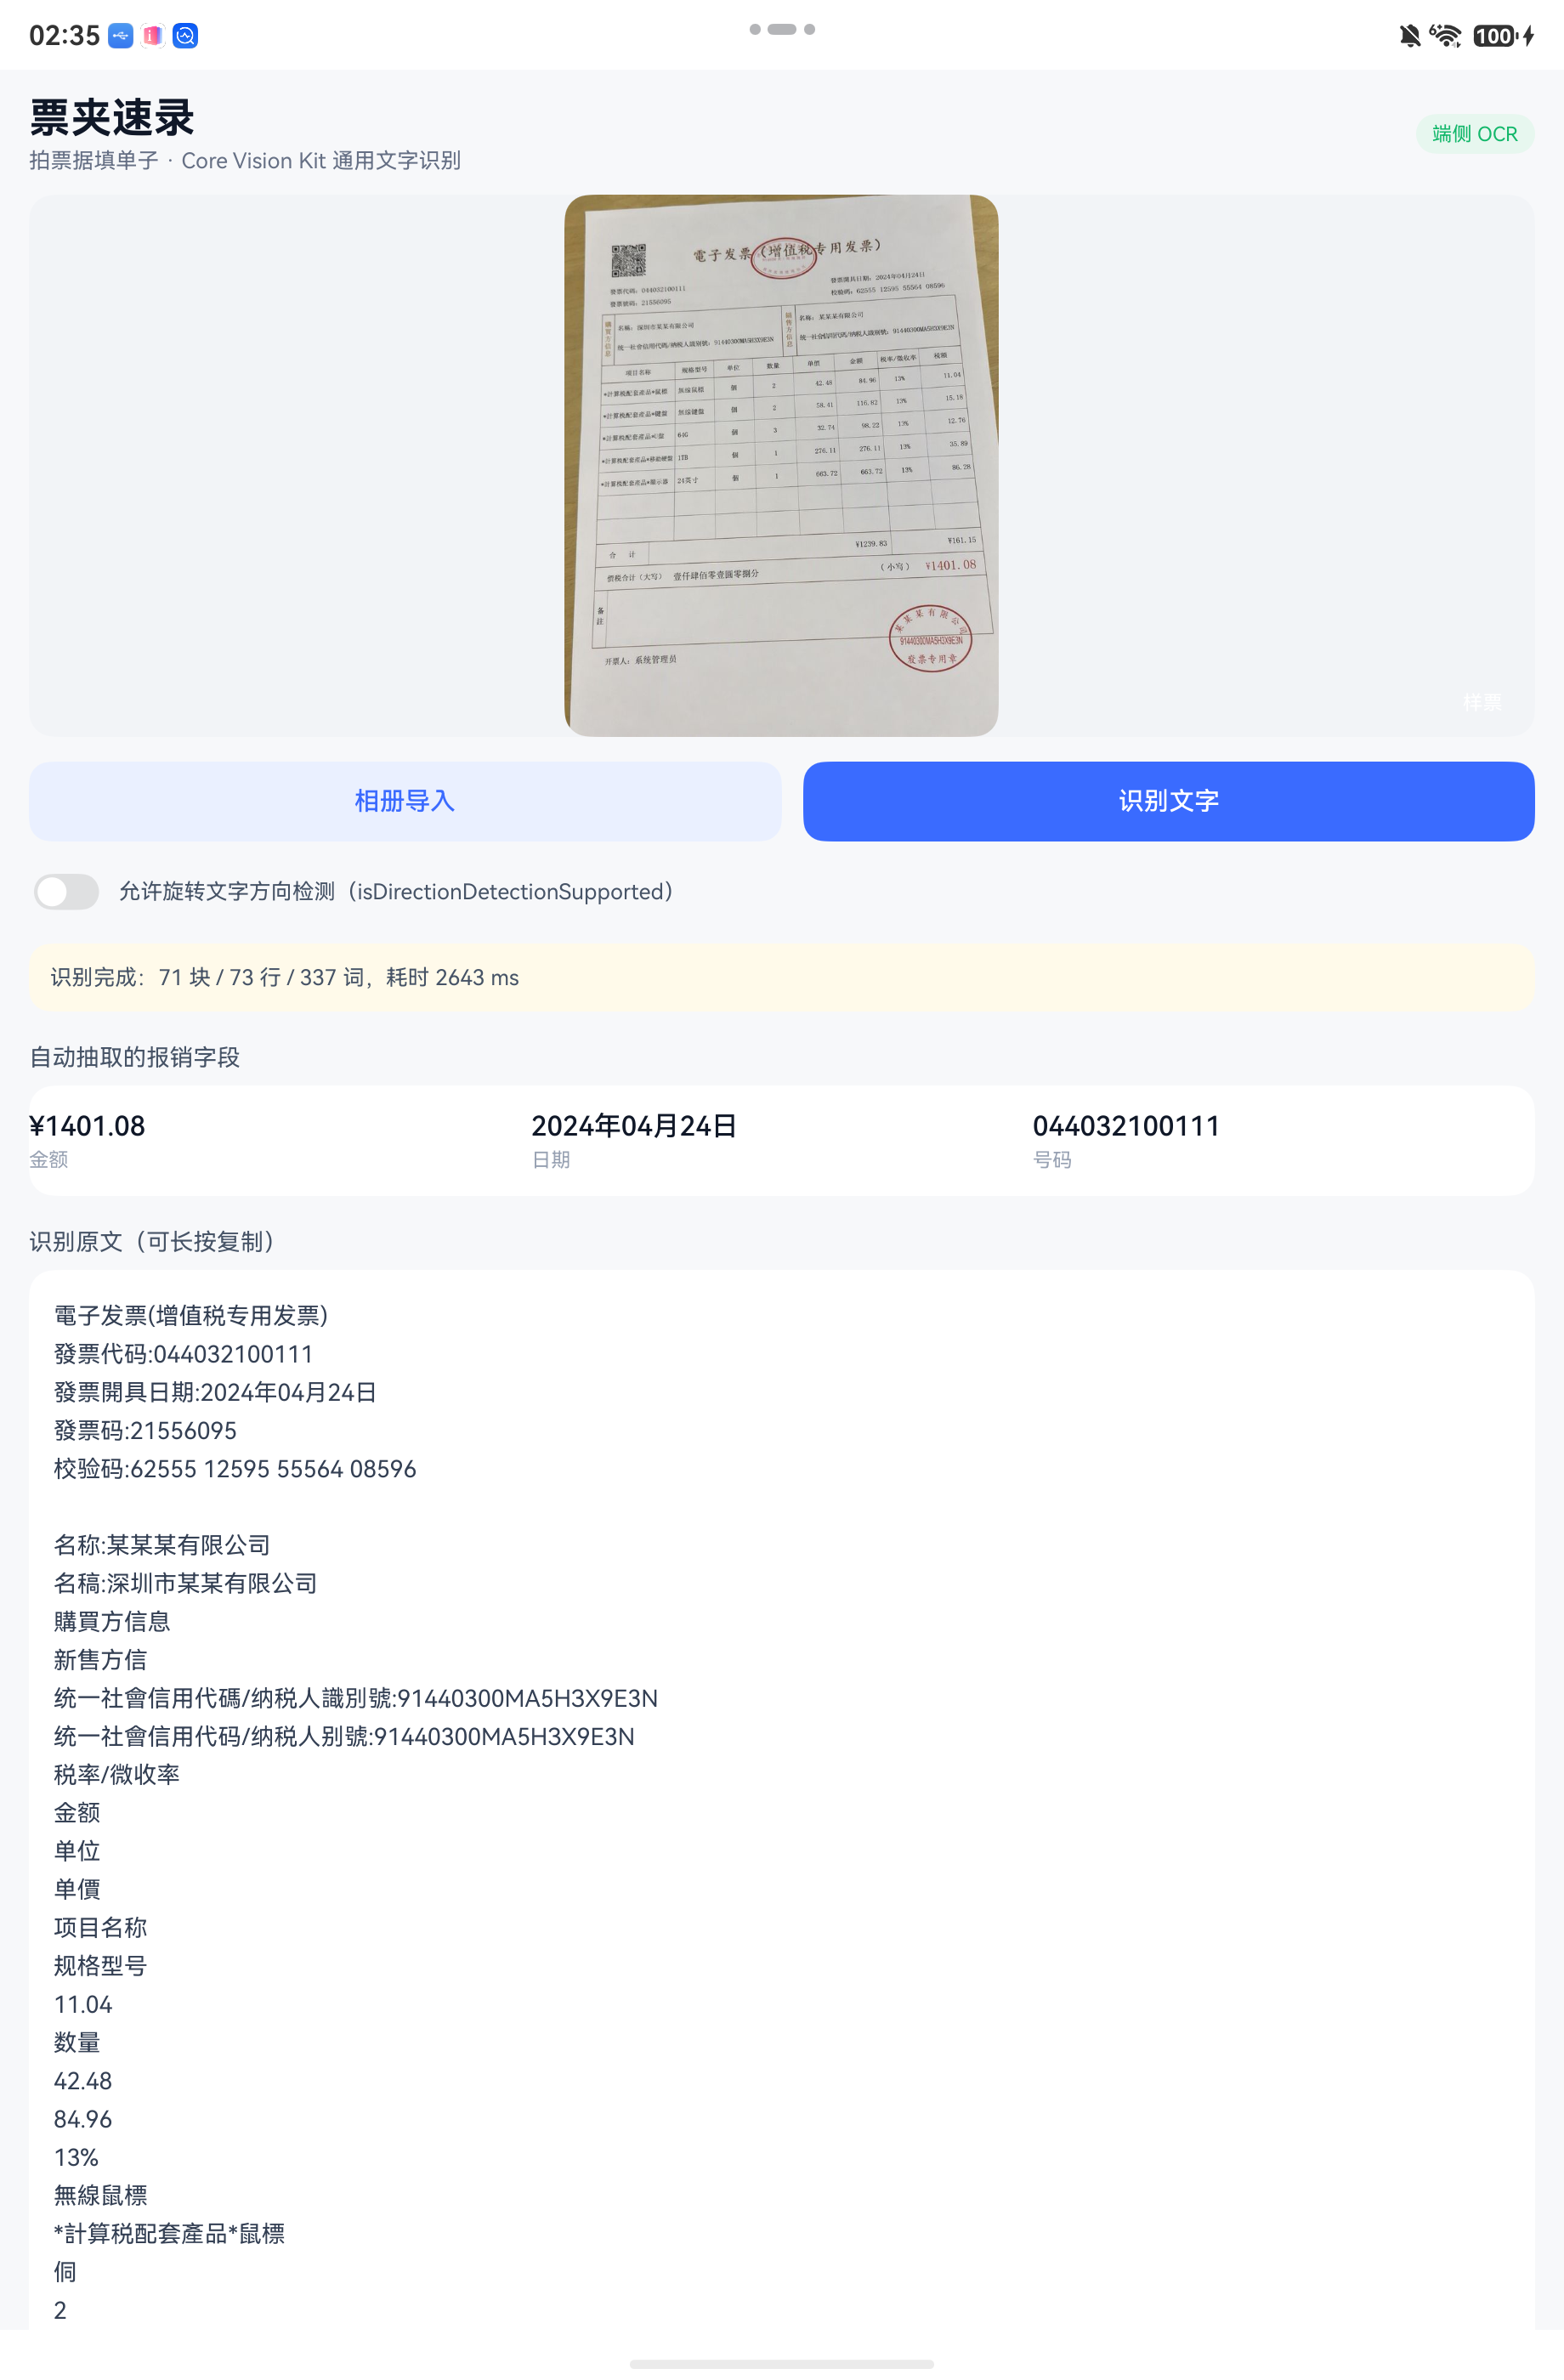
自动抽取的三个字段:
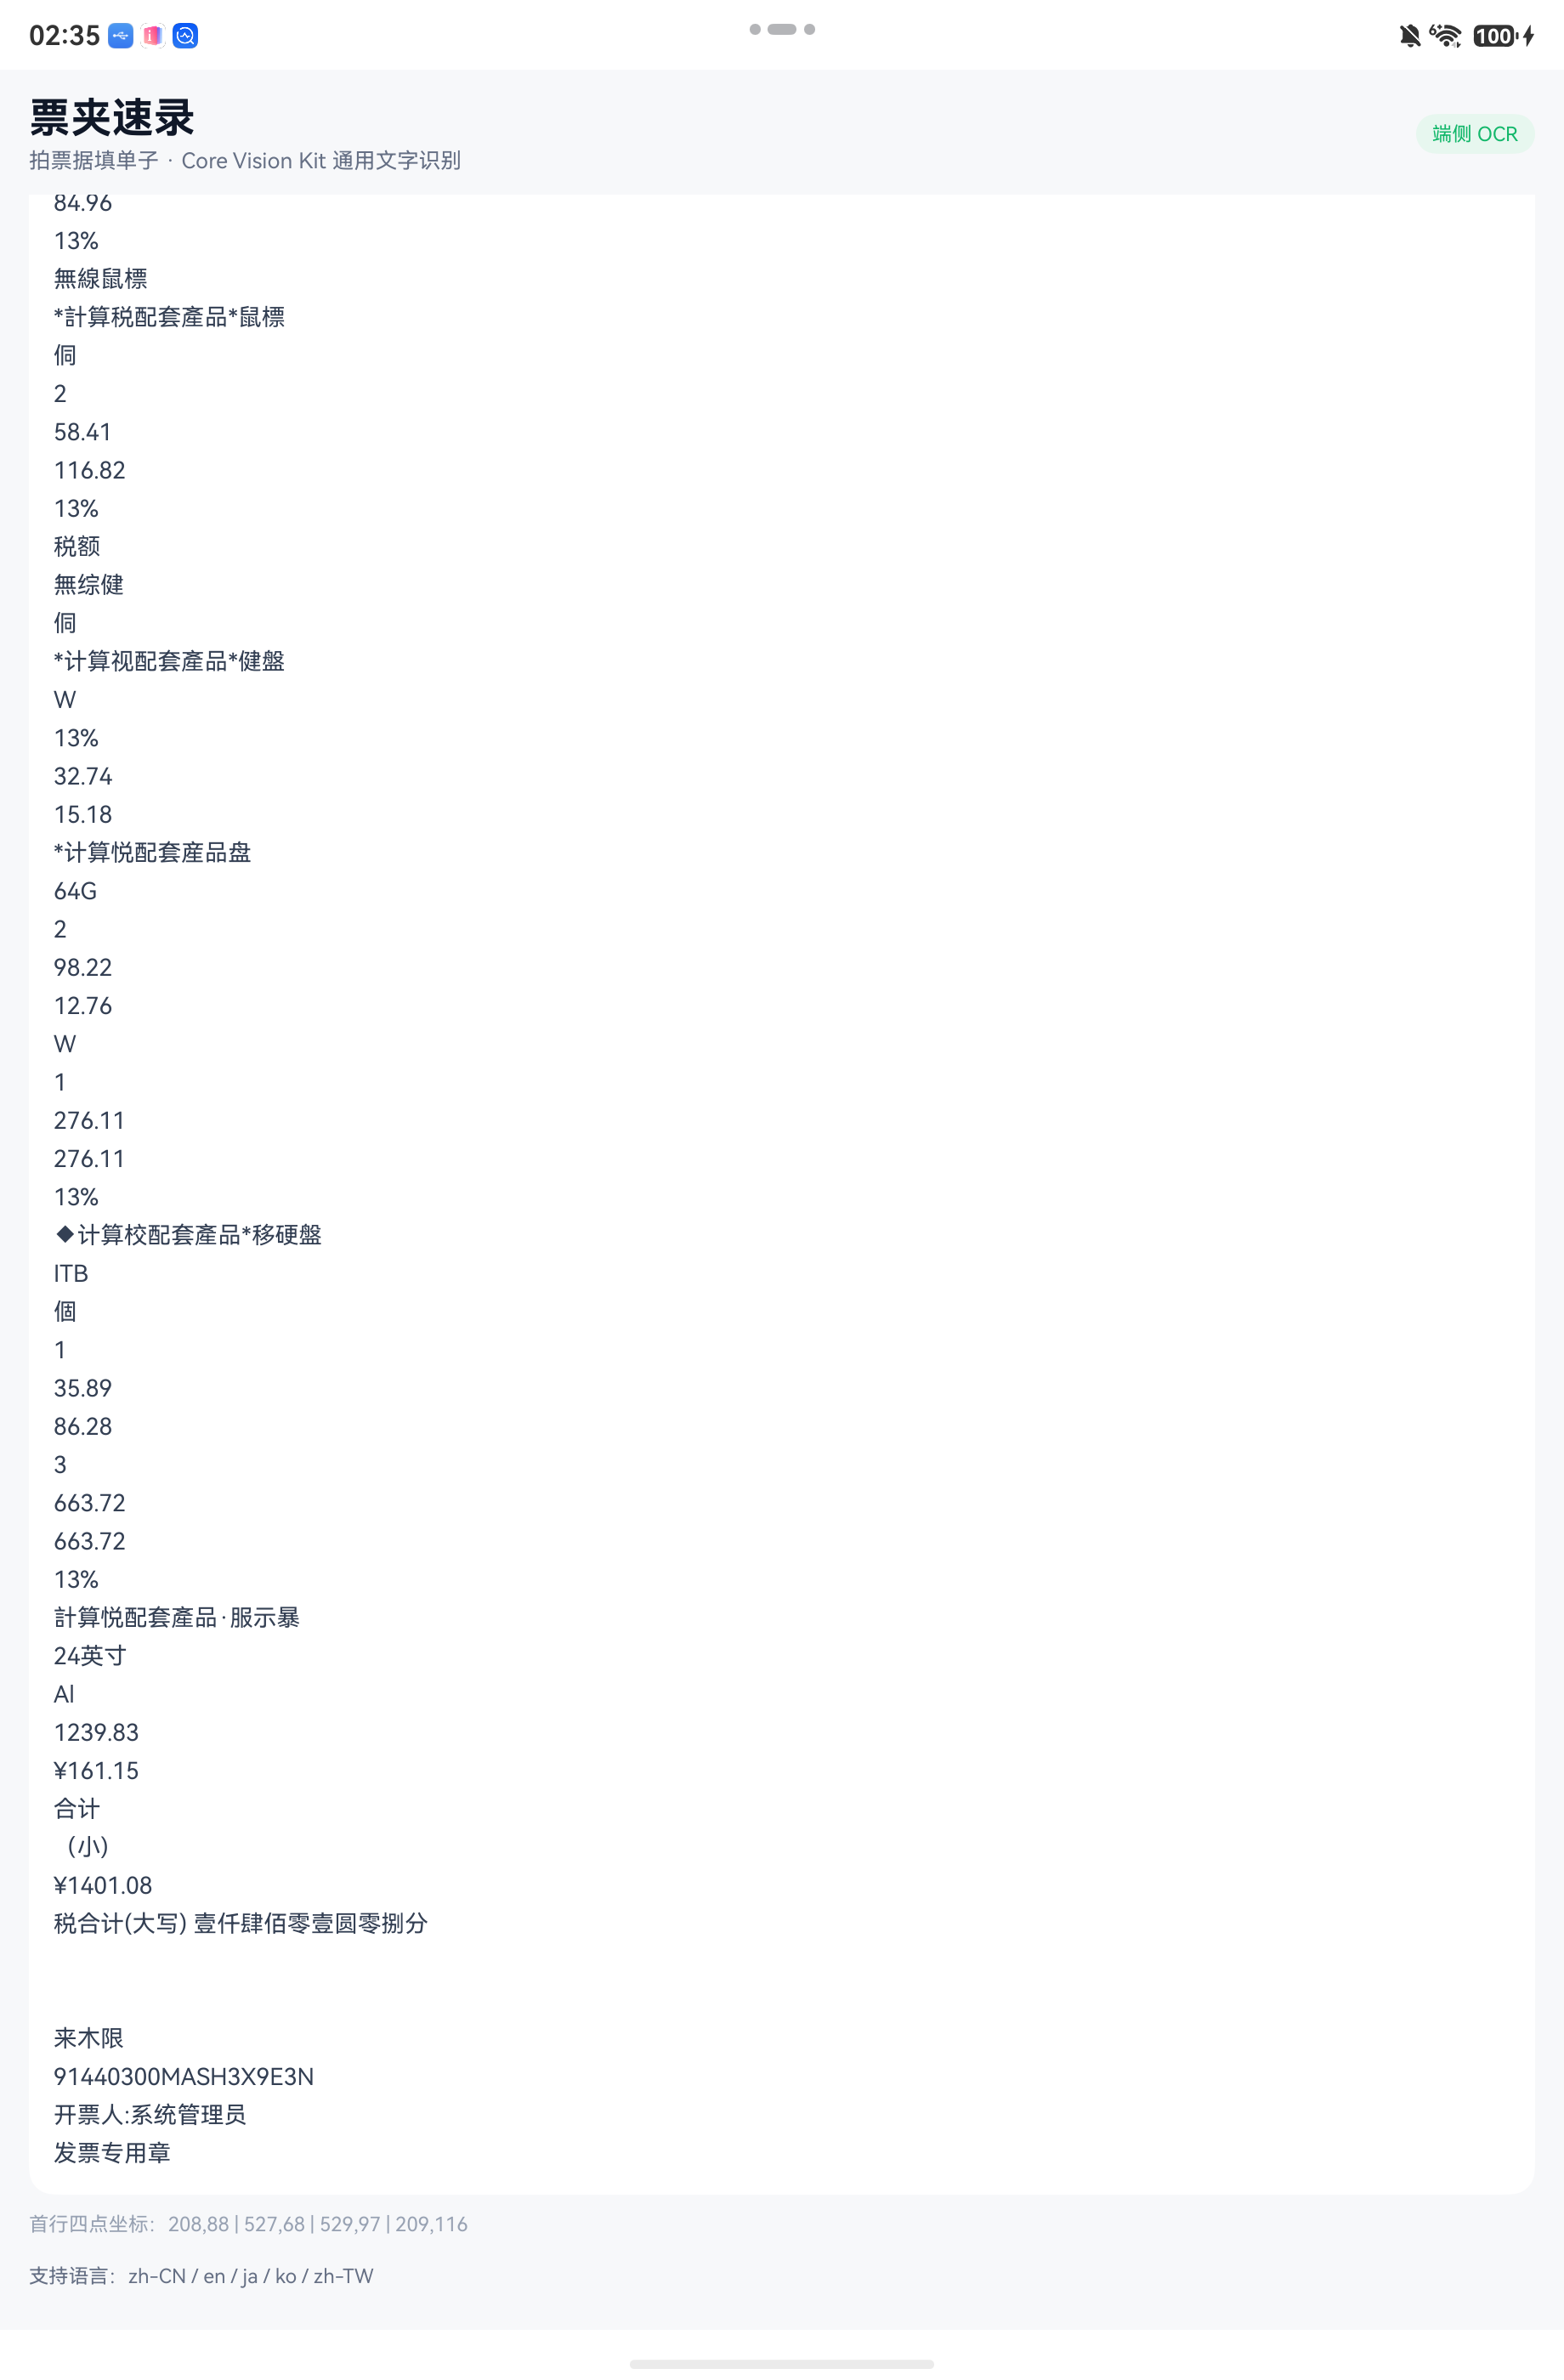
实测产出 71 块 / 73 行 / 337 词 / 539 字,耗时 3330 ms。
三个必须知道的结论
结论一:耗时不低,必须给进度反馈。
三秒多不是"点一下就出来"的体验,是"必须转圈并允许取消"的体验。而且耗时和文字量强相关,一张密密麻麻的行程单会更久。
结论二:OCR 忠实反映源图质量,不做语义纠错。
我们这张样票本身就有字形瑕疵,识别结果原样保留了:
显示器被识别成服示暴1TB被识别成ITB键盘被识别成健盤- 整张票简繁混排:
電子发票、發票代码、納税人識別號、统一社會信用代碼
这不是 OCR 的 bug,恰恰说明它工作得很诚实:图里长什么样,它就读成什么样。
所以做产品时,"识别准确率"这个指标其实是由拍照质量决定的,不是你决定的。你能决定的是——给用户提供"识别结果可编辑",以及把置信度低的字段标出来让人复核。
顺带一句:正因为简繁混排,我们的正则必须同时兼容简繁两种写法,否则繁体那半边的标签根本匹配不上。
结论三:别只拿 value 做正则。
res.blocks[i].lines[j] 是模型已经帮你切好的"行"。发票这种强结构文档,按行匹配(比如"找到含合计的那一行,再在行内取金额")比在整段文本里捞数字可靠得多。我们的 pickAmount 之所以能用"取最大值"这种土办法,是因为价税合计恰好是票面最大金额——换一个票种就不成立了。
往生产走还差什么
- 字段校验:金额要能对上"大写金额"(票面有
壹仟肆佰零壹圆零捌分),对不上就标红让人复核。 - 多图批量:串行跑,别并发;一张 3.3 秒,十张 33 秒,进度条必须有。
- 失败兜底:
init()失败、识别返回空文本,都要有明确提示,不能静默。 - 隐私声明:虽然全程端侧,仍建议在界面上写一句"票据数据不会离开本机",这是用户真正关心的。
总结
什么场景值得用它:报销、巡检、归档这类"拍张单据填表"的活。端侧 OCR 把字认全,简繁中英日韩都在能力范围内,票据数据不出设备。
不适合:指望它直接给你结构化数据。它交出来的是文本,字段还得自己抽,而且要预留抽错被人工复核的兜底。
💡 一句话:OCR 认字很靠谱,认业务不靠谱——那个被当成报销金额的
11.04就是教训。
参考文献
- Core Vision Kit 开发指南 · 通用文字识别:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-text-recognition
- Core Vision Kit API 参考 · textRecognition(文字识别):https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-text-recognition-api
- Core Vision Kit 错误码:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/errorcode-core-vision