前言
群里转发的长截图,第一眼看是清楚的,双指放大以后字是糊的。
我的第一反应是:信息被压缩掉了。既然是被压缩掉的,那就是可恢复性问题,端侧超分(imageSuperResolution)正好干这个。于是准备写一段"先超分再放大"的救图逻辑。
这段代码写完之前,我先做了一件事——给"糊"找个客观判据。结果被打脸了,而且打得很干净。
这篇是排障手记,按当时的顺序记:现象、假设、造现场、跑数据、被推翻、修正结论。中间有一次判据本身出问题,也一并写进来,因为那部分对以后排查同类问题是省时间的地方。
假设
一条转发链路大概是这样:原图 → 降采样 → 高压缩 JPEG → 对端解码 → 显示时再放大。
按这个模型,"糊"的原因是高频细节在降采样时被丢掉了,放大只是把糊放大,所以超分应该能重建出笔画。
要验证它,得能回答一个问题:这张图里的字,机器还认得出来吗?
人眼说"糊"不作数,得让机器打分。
造现场:一张已知答案的糊图
用脚本合成一张 1080×1920 的聊天截图,12 条已知文案(每条 10~11 字,字号 34px),标准答案我自己知道。然后模拟二次传播:缩到 432×768、JPEG 质量 38,成品 18KB。
判据用同一套 Core Vision Kit 里的通用文字识别:把图喂给 OCR,看返回文本里能完整找回 12 条中的几条(子串精确匹配)。
四条路径:
| 路径 | 处理 | 送进 OCR 的尺寸 |
|---|---|---|
| A | 原始截图 | 1080×1920 |
| B | 转发后的糊图,不动 | 432×768 |
| C | 糊图解码时直接拉大 4× | 1728×3072 |
| D | 糊图过端侧超分 4× | 1728×3072 |
结果:四条路径全跑一遍
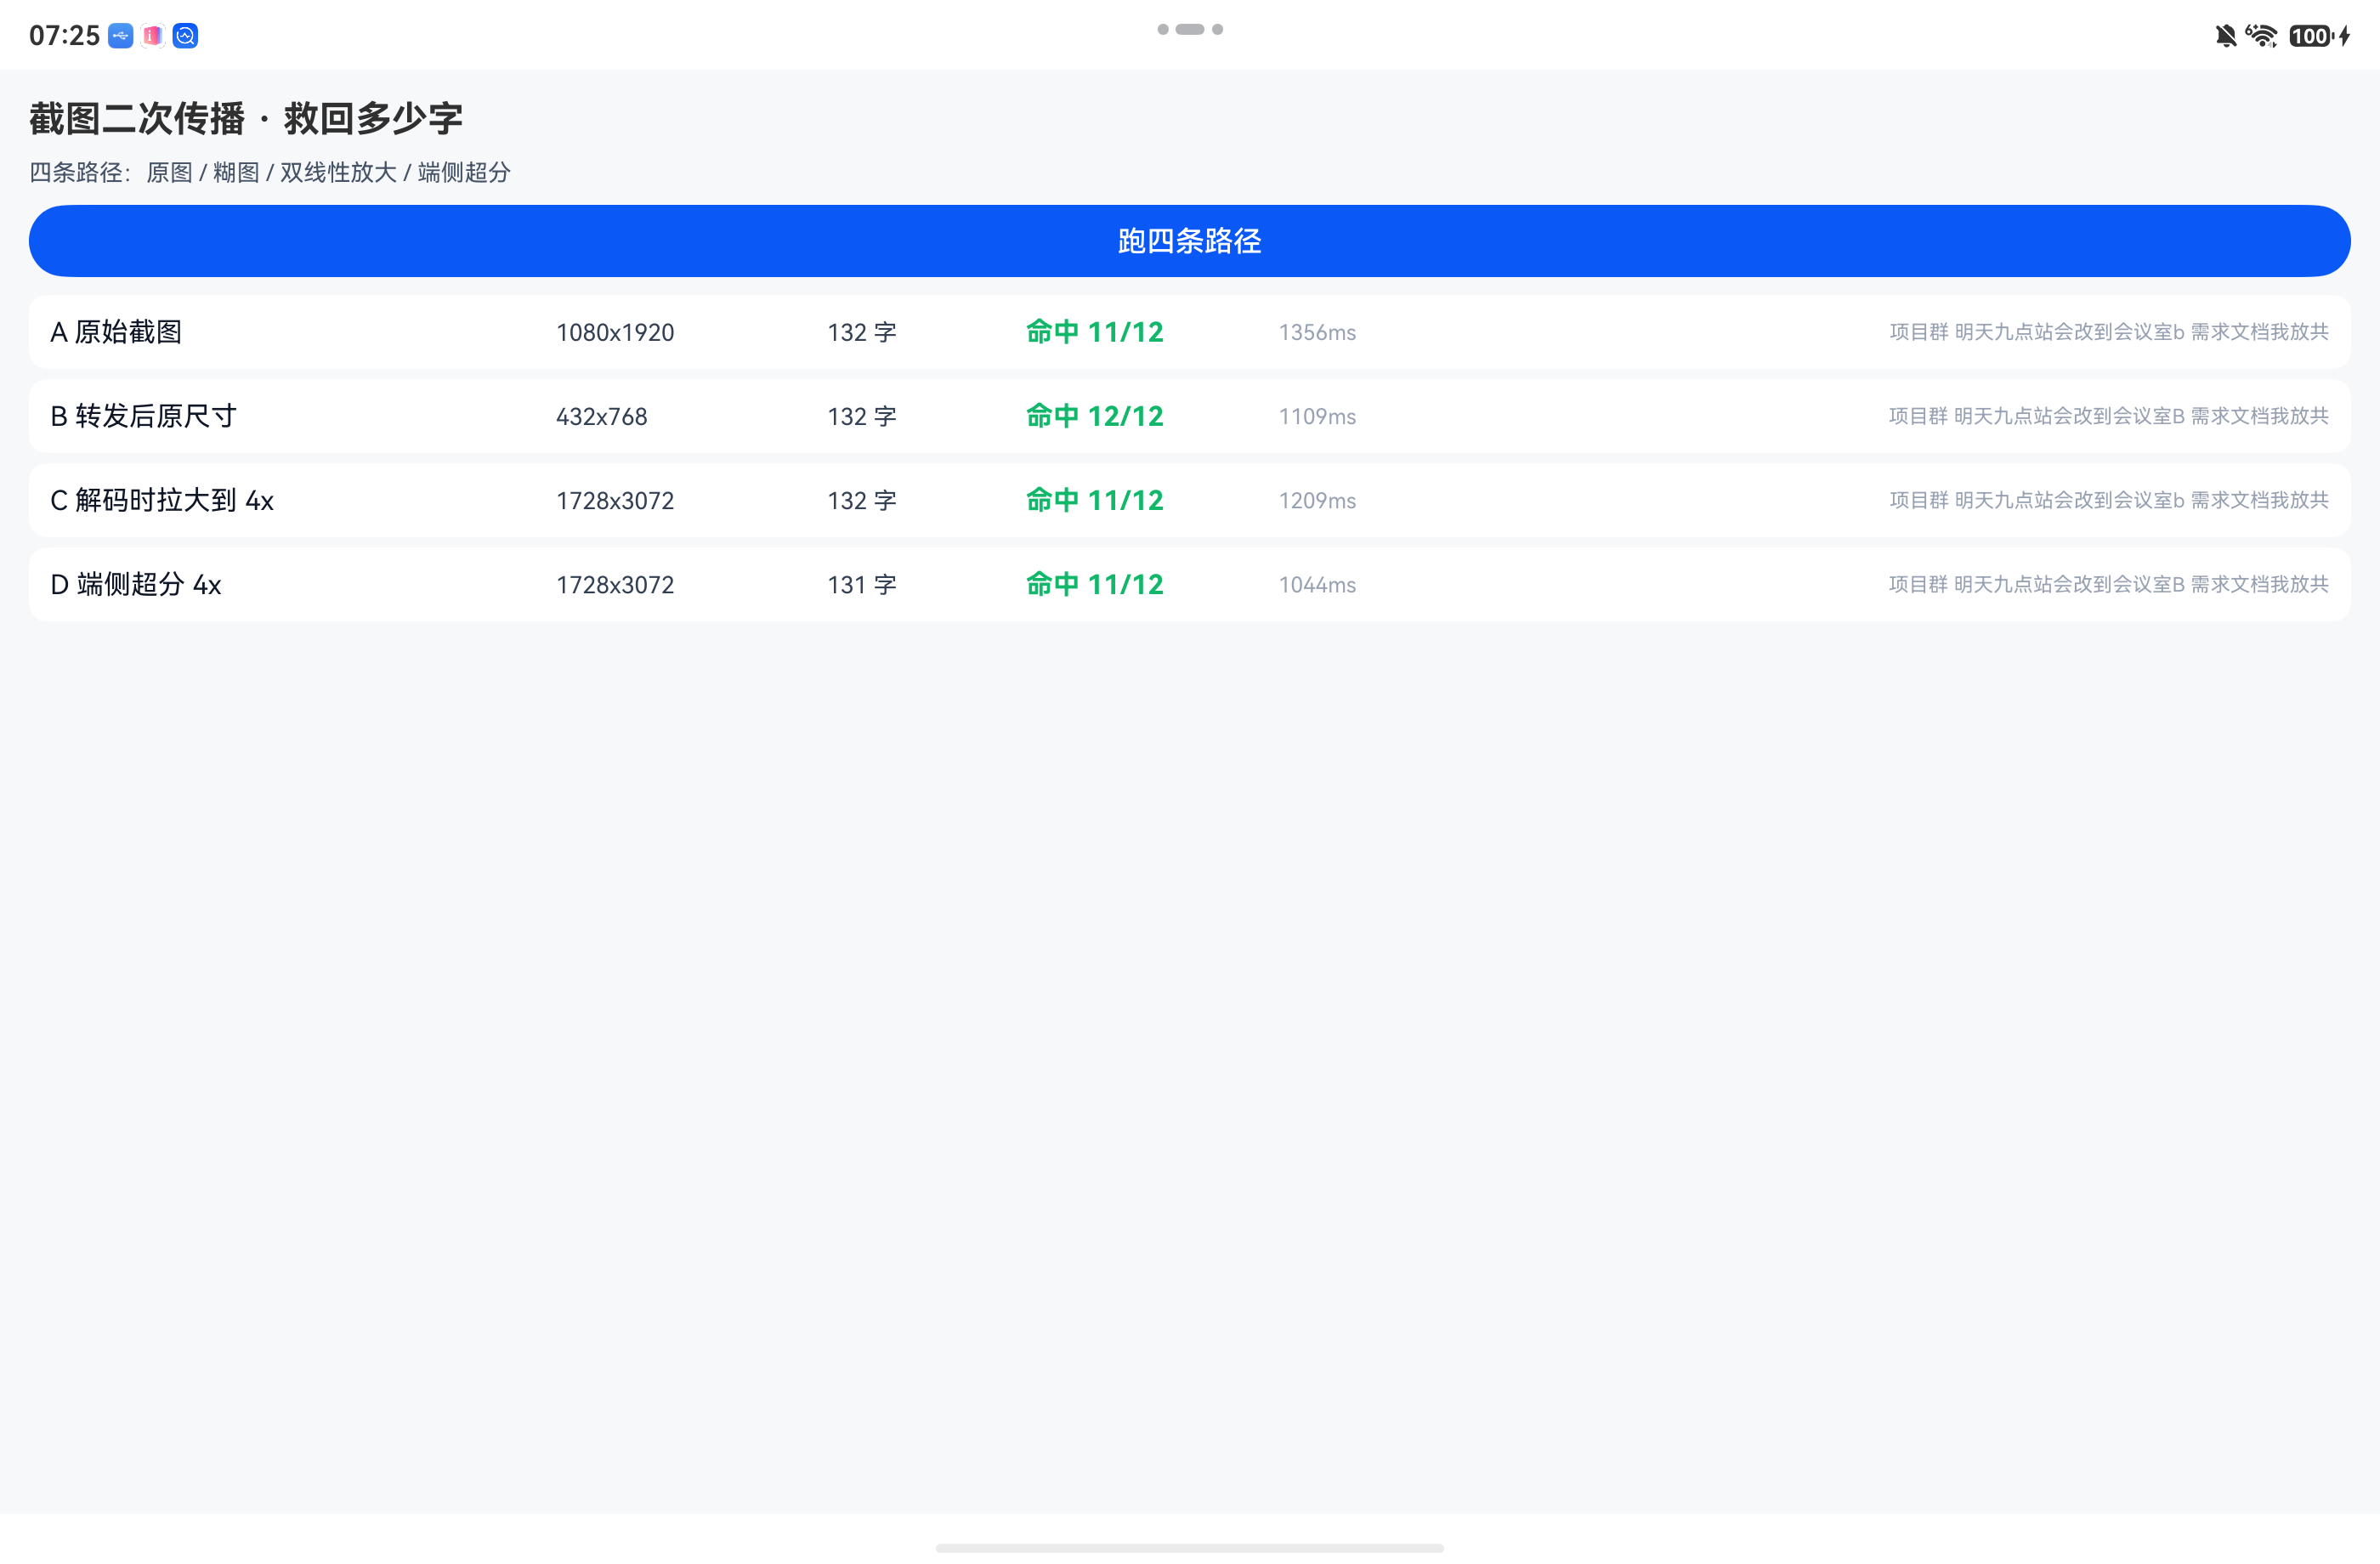
MatePad Pro(HarmonyOS 7 / API 26)实测:
| 路径 | 尺寸 | OCR 字符数 | 命中 | 识别耗时 | 额外成本 |
|---|---|---|---|---|---|
| A 原始截图 | 1080×1920 | 132 | 11/12 | 1356ms | — |
| B 糊图原尺寸 | 432×768 | 132 | 12/12 | 1109ms | — |
| C 双线性拉大 4× | 1728×3072 | 132 | 11/12 | 1209ms | 无 |
| D 端侧超分 4× | 1728×3072 | 131 | 11/12 | 1044ms | 超分 3574ms |
三个结论,全和预期相反:
- 糊图按原尺寸喂进去,成绩最好,12 条全中,比原始截图还多一条。
- 放大没有帮忙。双线性放大后掉到 11/12。
- 超分也没有帮忙。同样是 11/12,还多花 3.6 秒。
也就是说,"糊"是真的糊,但丢的不是信息,是观感。
为什么会这样:人眼和机器的分辨率不是一回事
算一下字高就明白了。原图字号 34px,缩到 432 宽是 0.4 倍,落到 13.6px。
13~14px 的汉字,对端侧 OCR 来说已经够认了——它看的是结构,不是锐度。但对人眼,在 1840×2800 的平板上放大看,13.6px 的字就是糊的,因为显示层把这几个像素又插值放大了一遍。
所以"看着糊"和"读不出来"之间隔着一整个数量级。人眼要 24px 以上才觉得舒服,机器 14px 就够用。 我们平时想救的,其实是那 10 个像素的观感差距,而机器的读取结果根本不在这个区间里。
打脸之后,还有一层:我的判据也不干净
三条 11/12 的路径,掉的到底是不是同一条?把 OCR 原文前 24 字打出来看:
A 原始截图    项目群 明天九点站会改到会议室b 需求文档我放共…
B 糊图原尺寸  项目群 明天九点站会改到会议室B 需求文档我放共…
C 拉大 4x     项目群 明天九点站会改到会议室b 需求文档我放共…
D 端侧超分    项目群 明天九点站会改到会议室B 需求文档我放共…
A 和 C 少的那一条是同一个:"会议室B" 被认成了小写 "b"。而原始清晰截图也认错了——这个字母的错跟压缩无关,是 OCR 对单个大写拉丁字母的偏好。
这暴露了我判据里的一个问题:子串精确匹配是大小写敏感的。如果做大小写归一化,A 和 C 大概率也会变成 12/12,那结论会更硬:四条路径对机器几乎完全等价。这一步我这次没重跑,留给下一次。
顺带一条:如果生产代码里真的用"识别出的文本"去做精确匹配(比如按单号查截图),大小写、O/0、B/8、1/l 这几对是必须先归一化的,否则你的搜索会稳定地漏掉某一类图。这类漏检最难查,因为它不是偶发的——同一张图每次都会错在同一个字符上,看起来像 bug,其实是判据写错了。
那超分到底什么时候该用
这次实验否定的不是超分,是"用超分去救机器读图"这条路。
该用的场景是给人看:老照片、翻拍的图纸、要放大的商品主图。这些场景里"观感"就是产品本身,多花 3 秒换一眼能看清,值得。
不该用的场景是给机器读:OCR、文搜图、人脸。这些场景先把原尺寸图喂进去测一轮,拿到分数,再决定要不要加预处理。我们这次要是没测,就会带着一个 3.6 秒的延迟上线,而收益是零。
真机数据
| 项目 | 实测值 |
|---|---|
| 合成原图 | 1080×1920,205KB,12 条文案 |
| 模拟转发图 | 432×768,18KB(缩放 0.4 + JPEG q38) |
| 端侧超分 | 432×768 → 1728×3072,3574ms |
| OCR 单张耗时 | 1044 ~ 1356ms |
| 命中(满分 12) | 原图 11 · 糊图 12 · 双线性 11 · 超分 11 |

总结
这个排查流程可以复用到任何"图看不清"的需求上:先定义一个机器能打分的判据,再决定要不要做图像预处理。
顺序反过来的话,很容易做出一个"看起来更清楚了、但没人因此受益"的功能——多花 3.6 秒,掉一条命中。
💡 一句话:图糊不糊,先问 OCR 再问眼睛——给机器读的图,直接按原尺寸喂进去测一轮,多半不需要超分。
参考文献
- 图像超分(开发指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-image-super-resolution
- imageSuperResolution API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-image-super-resolution-api
- 通用文字识别(开发指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-text-recognition
- textRecognition API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-text-recognition-api