前言
FAST Kit 在 API 26 新增了智能序列预测(mathPrediction.predictIndex),官方描述只有一句话:
接收一组包含索引和时间戳的采样点数组,基于 FAST Kit 内置算法预测下一个时刻的索引值。
"内置算法"是什么算法,文档没说。
这就很难受——你要么当黑盒用,要么自己摸清楚。我做了一组实验把它摸出来了,结论是:
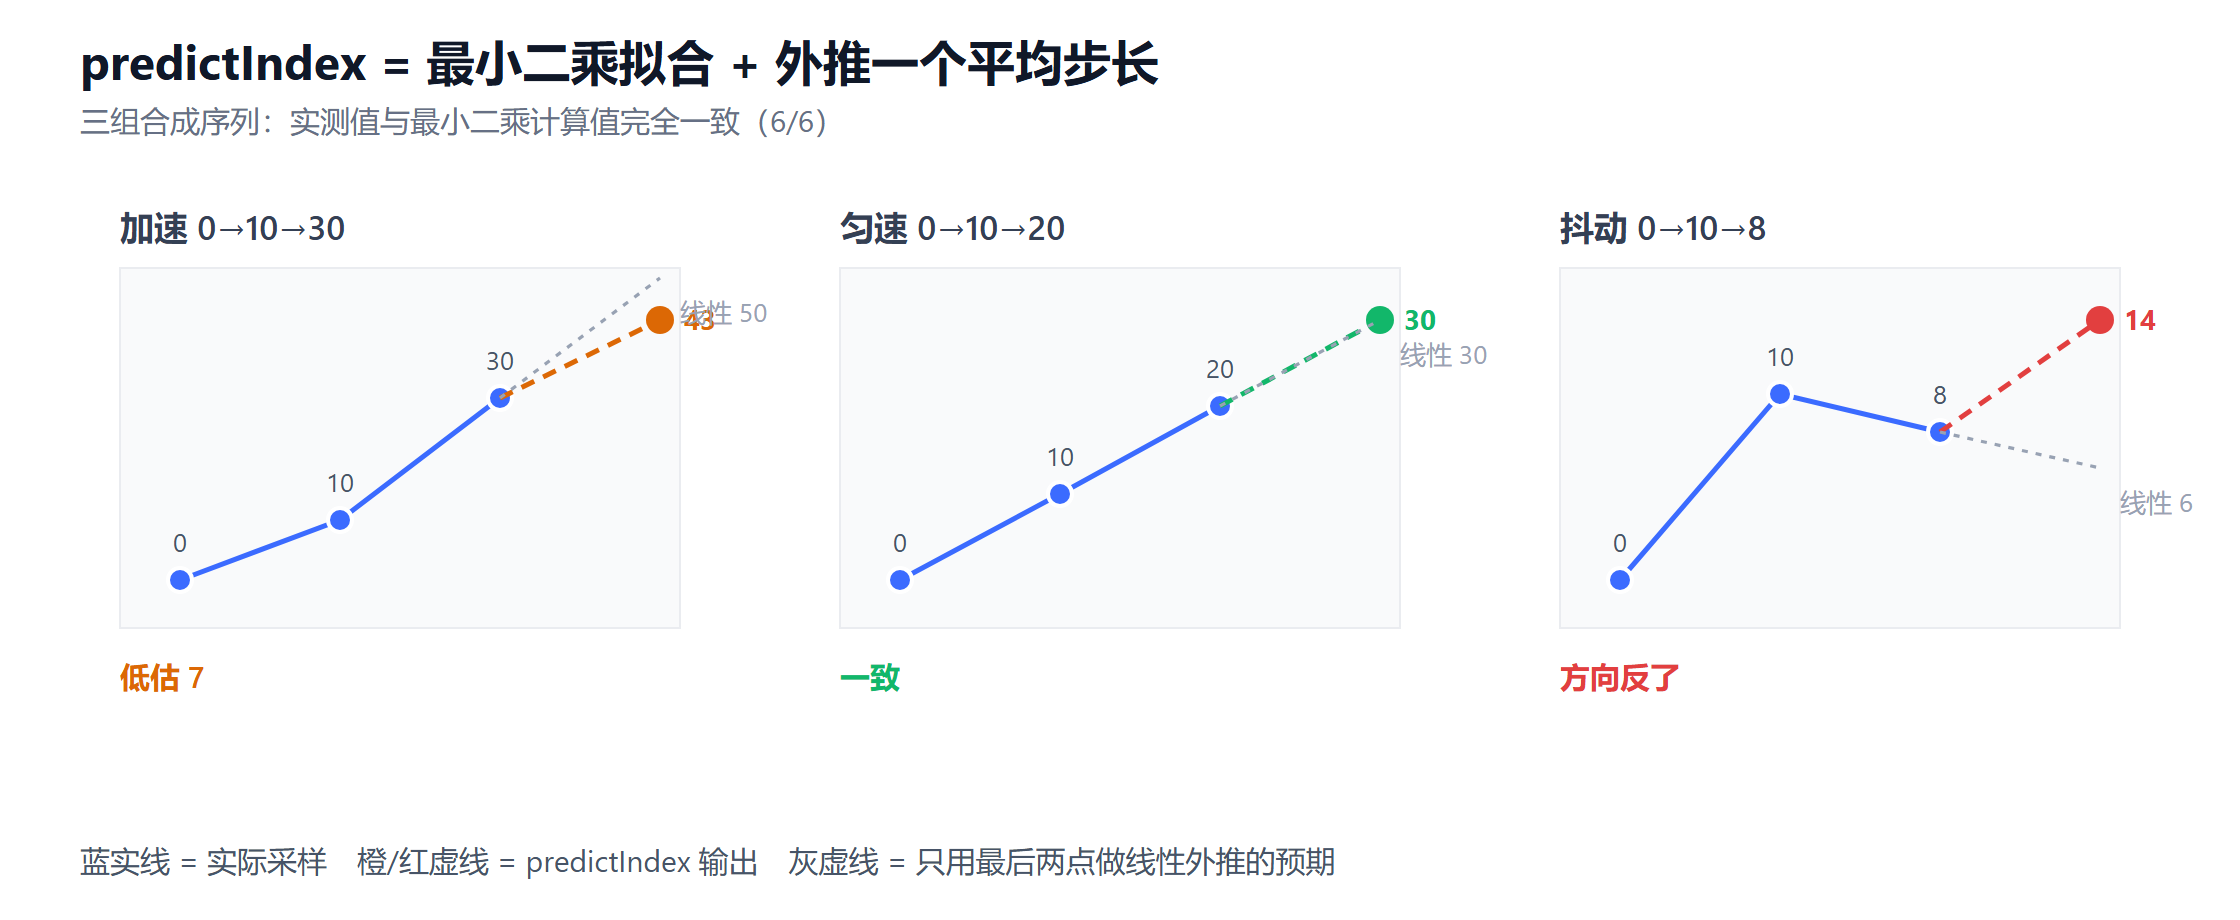
它是对全部采样点做最小二乘线性拟合,再外推一个平均时间步长。 这个结论在 6/6 的合成用例上与手算完全一致。
由此能推出三条工程约束,其中一条会让预加载方向完全搞反。这篇就是实验记录。
它能做什么
官方列了四个场景:
| 场景 | 官方描述 |
|---|---|
| 手势跟踪 | 根据历史触摸点位置与时间,预测下一帧触摸点索引,减少跟随延迟 |
| 动画曲线预测 | 基于已有关键帧的索引-时间采样,预测后续帧变化趋势 |
| 运动轨迹预估 | 根据物体历史轨迹采样预测后续位置,提升响应速度 |
| 滚动惯性预测 | 根据历史滚动偏移量采样,预测减速阶段最终停止位置 |
这四个场景的共同点是:输入是一串带时间戳的序列值,输出是下一个值。所以它的适用范围不限于列表预加载,触摸点补偿、关键帧补间都能用。
但要注意,它不是一个通用预测模型。下面的数据会说明,它对"趋势突变"的响应方式非常朴素,用错场景会适得其反。
接口与约束
import { mathPrediction } from '@kit.FASTKit';

interface IndexSample { index: number; timestamp: number; }
function predictIndex(samples: IndexSample[]): number;
- FAST Kit:算法加速服务,HarmonyOS 提供的以理论计算机科学为基础的高性能算法库集合。
- 序列预测:用历史采样点外推下一个时刻的序列值,这里输入是 (index, timestamp) 对。
- 最小二乘拟合:让所有采样点到一条直线的误差平方和最小的直线,常用于趋势外推。
约束(官方声明):起始版本 26.0.0;samples 至少 2 个采样点;时间戳应单调递增,否则预测不准。
顺便交代一下 FAST Kit 的全貌,因为它容易被误解。它一共 7 个功能域,但开放给 ArkTS 的只有 2 个:
| 功能域 | 能力 | 接口层 |
|---|---|---|
| 高阶数据结构 | 线段表、并发哈希表 | C/C++ |
| 规划求解 | 矩形划分求解器、多项式零点求解器 | C/C++ |
| 数字信号处理 | 向量运算、FFT、二阶 IIR 滤波 | C/C++ |
| 容器 | 高性能哈希表 | C/C++ |
| 算法 | 通用排序、自然语言字符串排序 | C/C++ |
| 数理预测 | 智能序列预测 predictIndex |
ArkTS / C |
| 系统性能优化 | perfHint 场景调度提示 |
ArkTS / C/C++ |
也就是说,"排序加速""FFT""并发哈希表"这些听起来最像"算法加速"的能力,目前都要走 native。纯 ArkTS 项目能直接吃到的是 mathPrediction 和 schedulingOptimization 两个。
实验怎么设计
第一步:合成探针
要反推算法,必须用已知规律的输入。我构造了 6 组,覆盖"匀速 / 加速 / 减速 / 反向抖动 / 两点 / 长窗口":
const probes: Probe[] = [
  { name: '匀速 0/10/20', samples: [{ index: 0, timestamp: 0 }, { index: 10, timestamp: 100 }, { index: 20, timestamp: 200 }] },
  { name: '加速 0/10/30', samples: [{ index: 0, timestamp: 0 }, { index: 10, timestamp: 100 }, { index: 30, timestamp: 200 }] },
  { name: '减速 0/30/50', samples: [{ index: 0, timestamp: 0 }, { index: 30, timestamp: 100 }, { index: 50, timestamp: 200 }] },
  { name: '抖动 0/10/8',  samples: [{ index: 0, timestamp: 0 }, { index: 10, timestamp: 100 }, { index: 8,  timestamp: 200 }] },
  { name: '两点 0/20',    samples: [{ index: 0, timestamp: 0 }, { index: 20, timestamp: 100 }] },
  { name: '密集 0..40',   samples: [/* 5 点,步长 50ms */] }
];
for (let i = 0; i < probes.length; i++) {
  try {
    hilog.info(0x0000, TAG, 'probe %{public}s got=%{public}d',
      probes[i].name, mathPrediction.predictIndex(probes[i].samples));
  } catch (err) {
    const e = err as BusinessError;
    hilog.error(0x0000, TAG, 'probe failed %{public}d', e.code);
  }
}
对照组取"只用最后两点做线性外推"的结果,即 last + (last - prev)。
第二步:真实滚动采样
400 项列表,用 onScrollIndex 抓首个可见索引作为序列值:
feed(index: number, ts: number): number {
  this.win.push({ index: index, timestamp: ts });
  if (this.win.length > 6) {
    this.win.shift();          // 滑动窗口,只喂最近 6 个点
  }
  if (this.win.length < 2) {
    return -1;                 // 少于 2 点直接跳过,不要调 API
  }
  return mathPrediction.predictIndex(this.win);
}
停稳判定用 300ms 防抖,到点后把"最后一次预测值"与"实际停止索引"对比:
settle(actual: number): string {
  const err: number = Math.abs(this.lastPred - actual);
  return `预测 ${this.lastPred} / 实际 ${actual} / 误差 ${err}${err <= 1 ? '(命中)' : ''}`;
}实验数据
测试机:HUAWEI MatePad Pro(MRDI-W00),HarmonyOS 7.0.0.107,API 26。
合成序列
| 输入序列(index @ timestamp) | 线性外推预期 | predictIndex 实测 | 最小二乘手算 | 是否吻合 |
|---|---|---|---|---|
| 0@0, 10@100, 20@200 | 30 | 30 | 30.00 | ✓ |
| 0@0, 10@100, 30@200 | 50 | 43 | 43.33 | ✓ |
| 0@0, 30@100, 50@200 | 70 | 77 | 76.67 | ✓ |
| 0@0, 10@100, 8@200 | 6 | 14 | 14.00 | ✓ |
| 0@0, 20@100 | 40 | 40 | 40.00 | ✓ |
| 0@0,10@50,20@100,30@150,40@200 | 50 | 50 | 50.00 | ✓ |
6 组全部与最小二乘拟合值一致,且其中 3 组与"最后两点线性外推"明显不同。 结论可以写成一行:
predictIndex(samples) =
    对全部 samples 做 (timestamp → index) 的最小二乘直线拟合,
    再外推到  t_next = t_last + (t_last - t_first) / (n - 1)
即"外推一个平均时间步长",不是"复制最后一个增量"。
真实滚动
连续 6 次 uitest uiInput fling,每次等停稳后结算:
| 次序 | 预测索引 | 实际停止 | 误差 |
|---|---|---|---|
| 1 | 73 | 72 | 1 |
| 2 | 146 | 145 | 1 |
| 3 | 219 | 218 | 1 |
| 4 | 292 | 291 | 1 |
| 5 | 365 | 364 | 1 |
| 6 | 381 | 381 | 0 |
按 ±1 容差计,6/6 命中。
注意 1–5 次预测值恒比实际大 1——因为预测发生在最后一个滚动事件上,而列表随后还有极小残余位移;到列表末尾(第 6 次)残余消失,误差归零。这说明在可达边界处它的偏差会消失,中段则系统性偏乐观 1 项左右。
界面与结算记录:
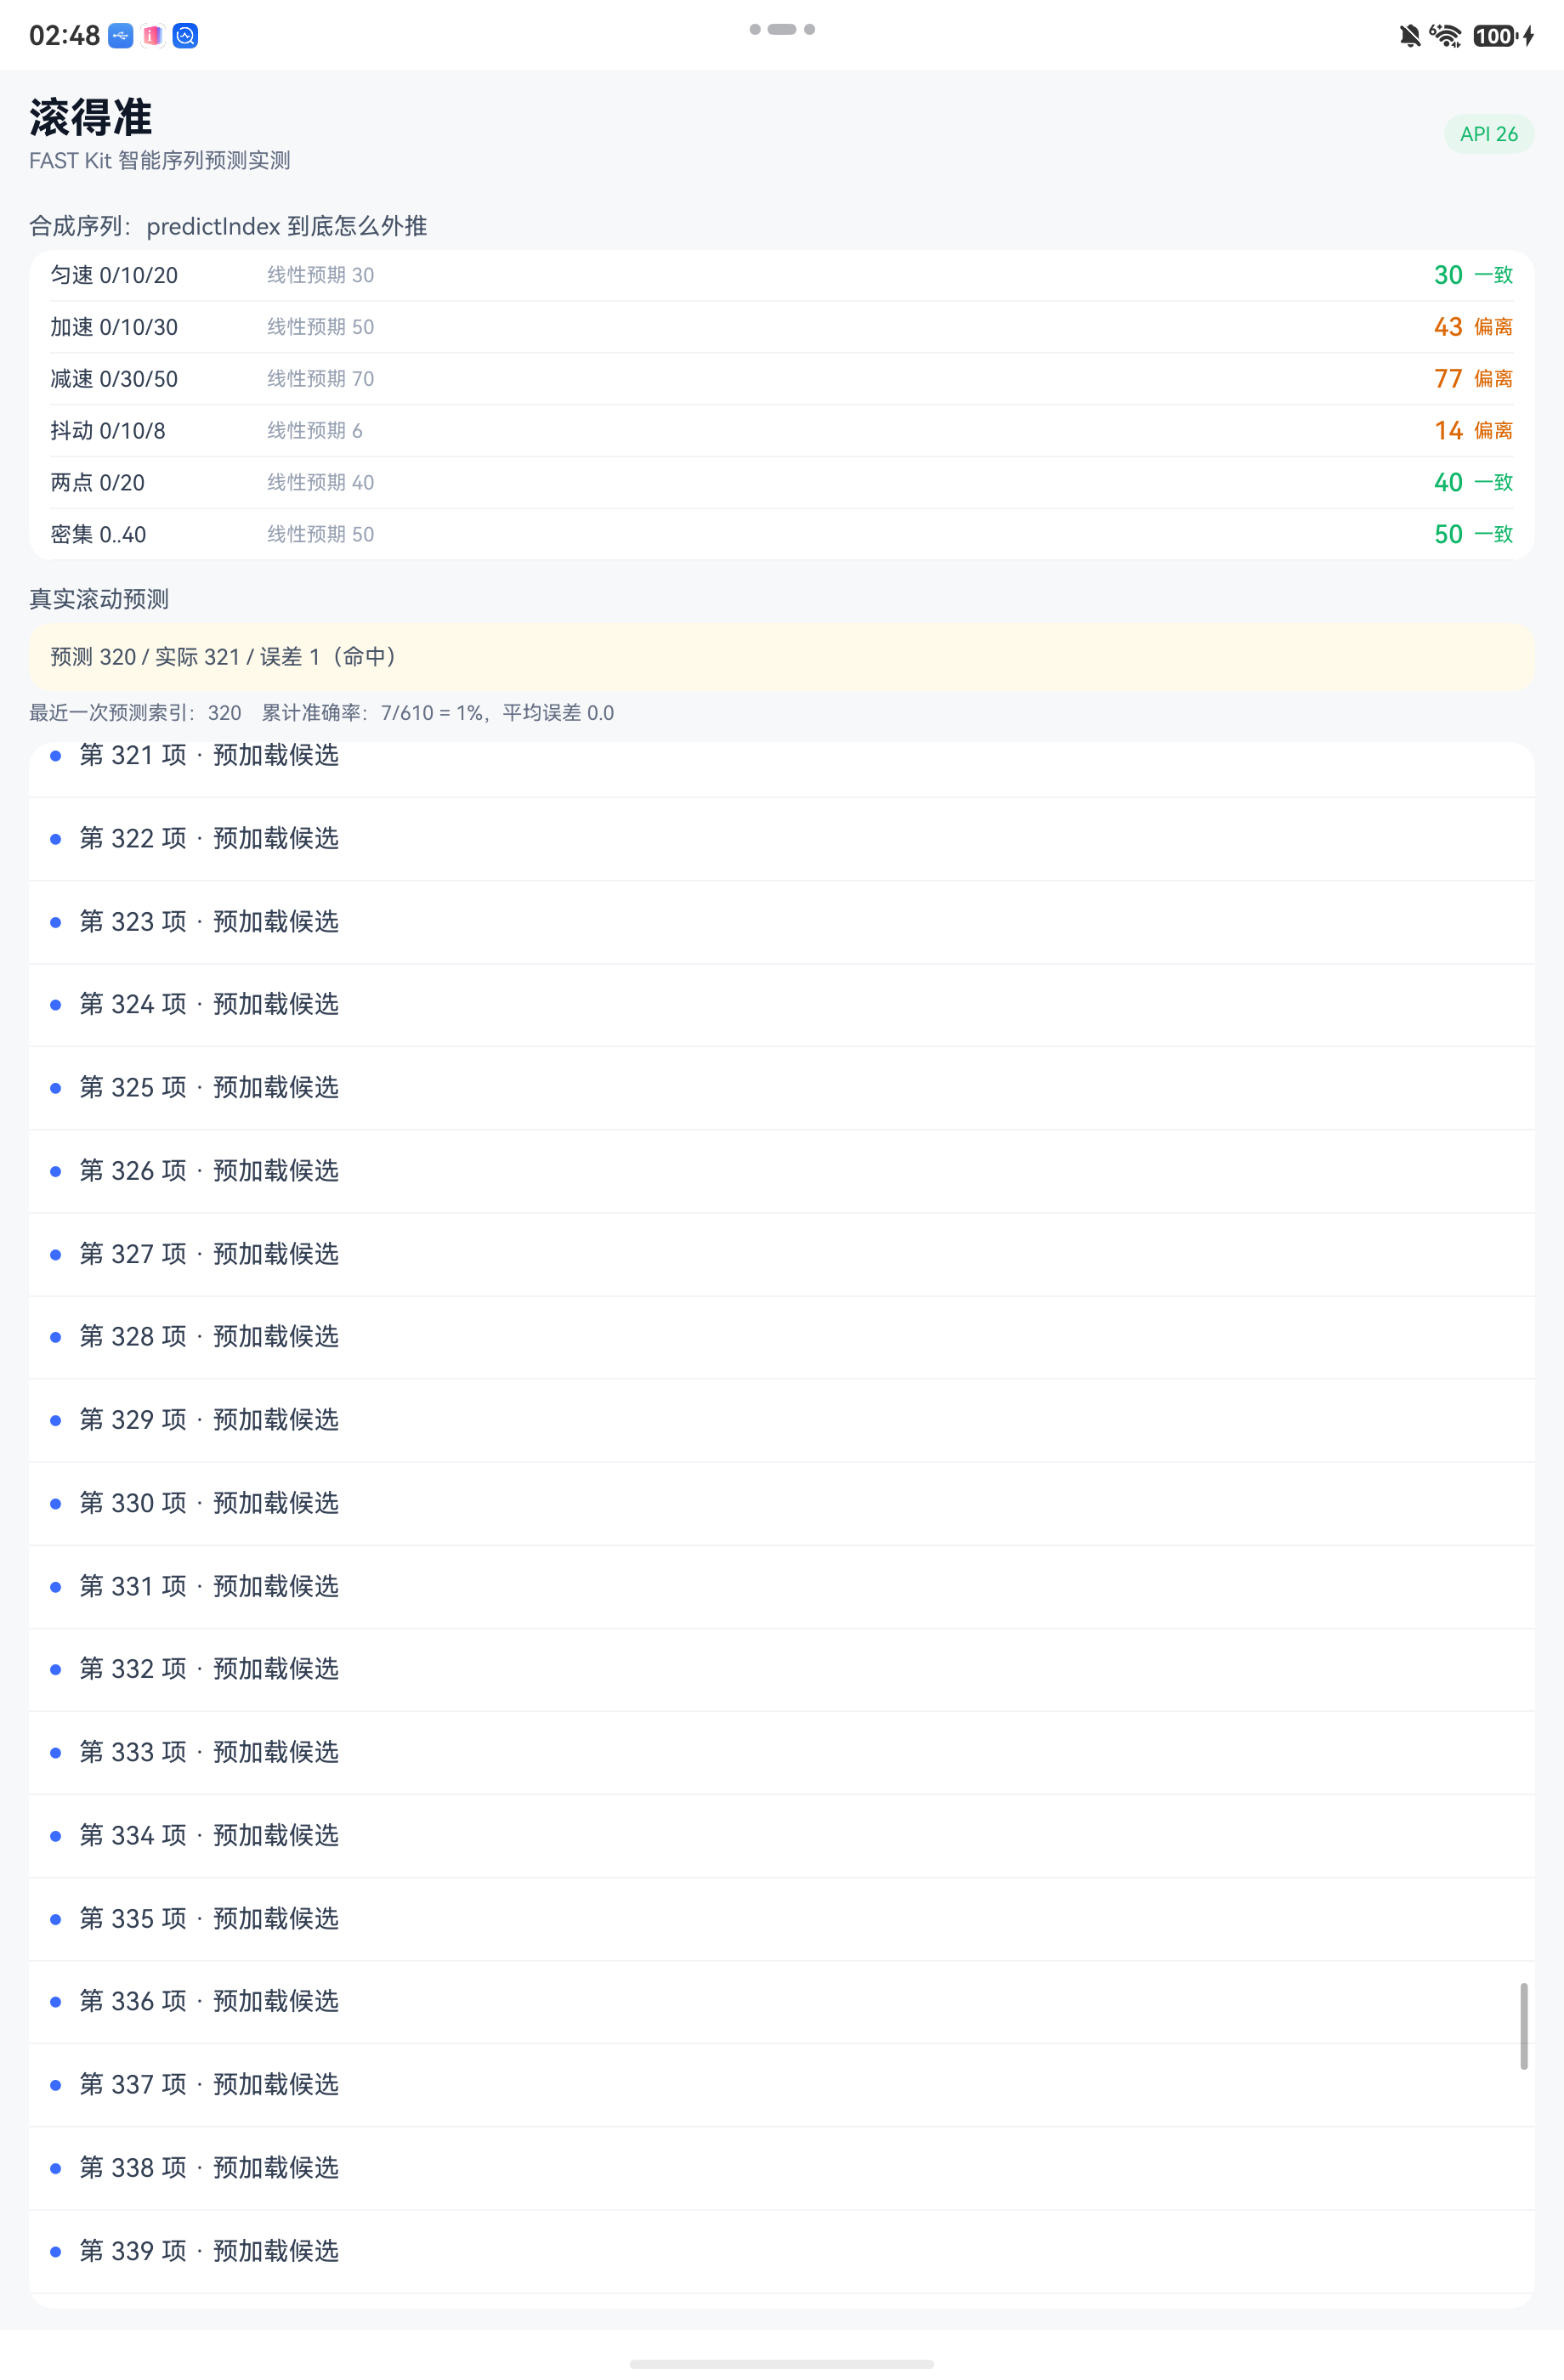
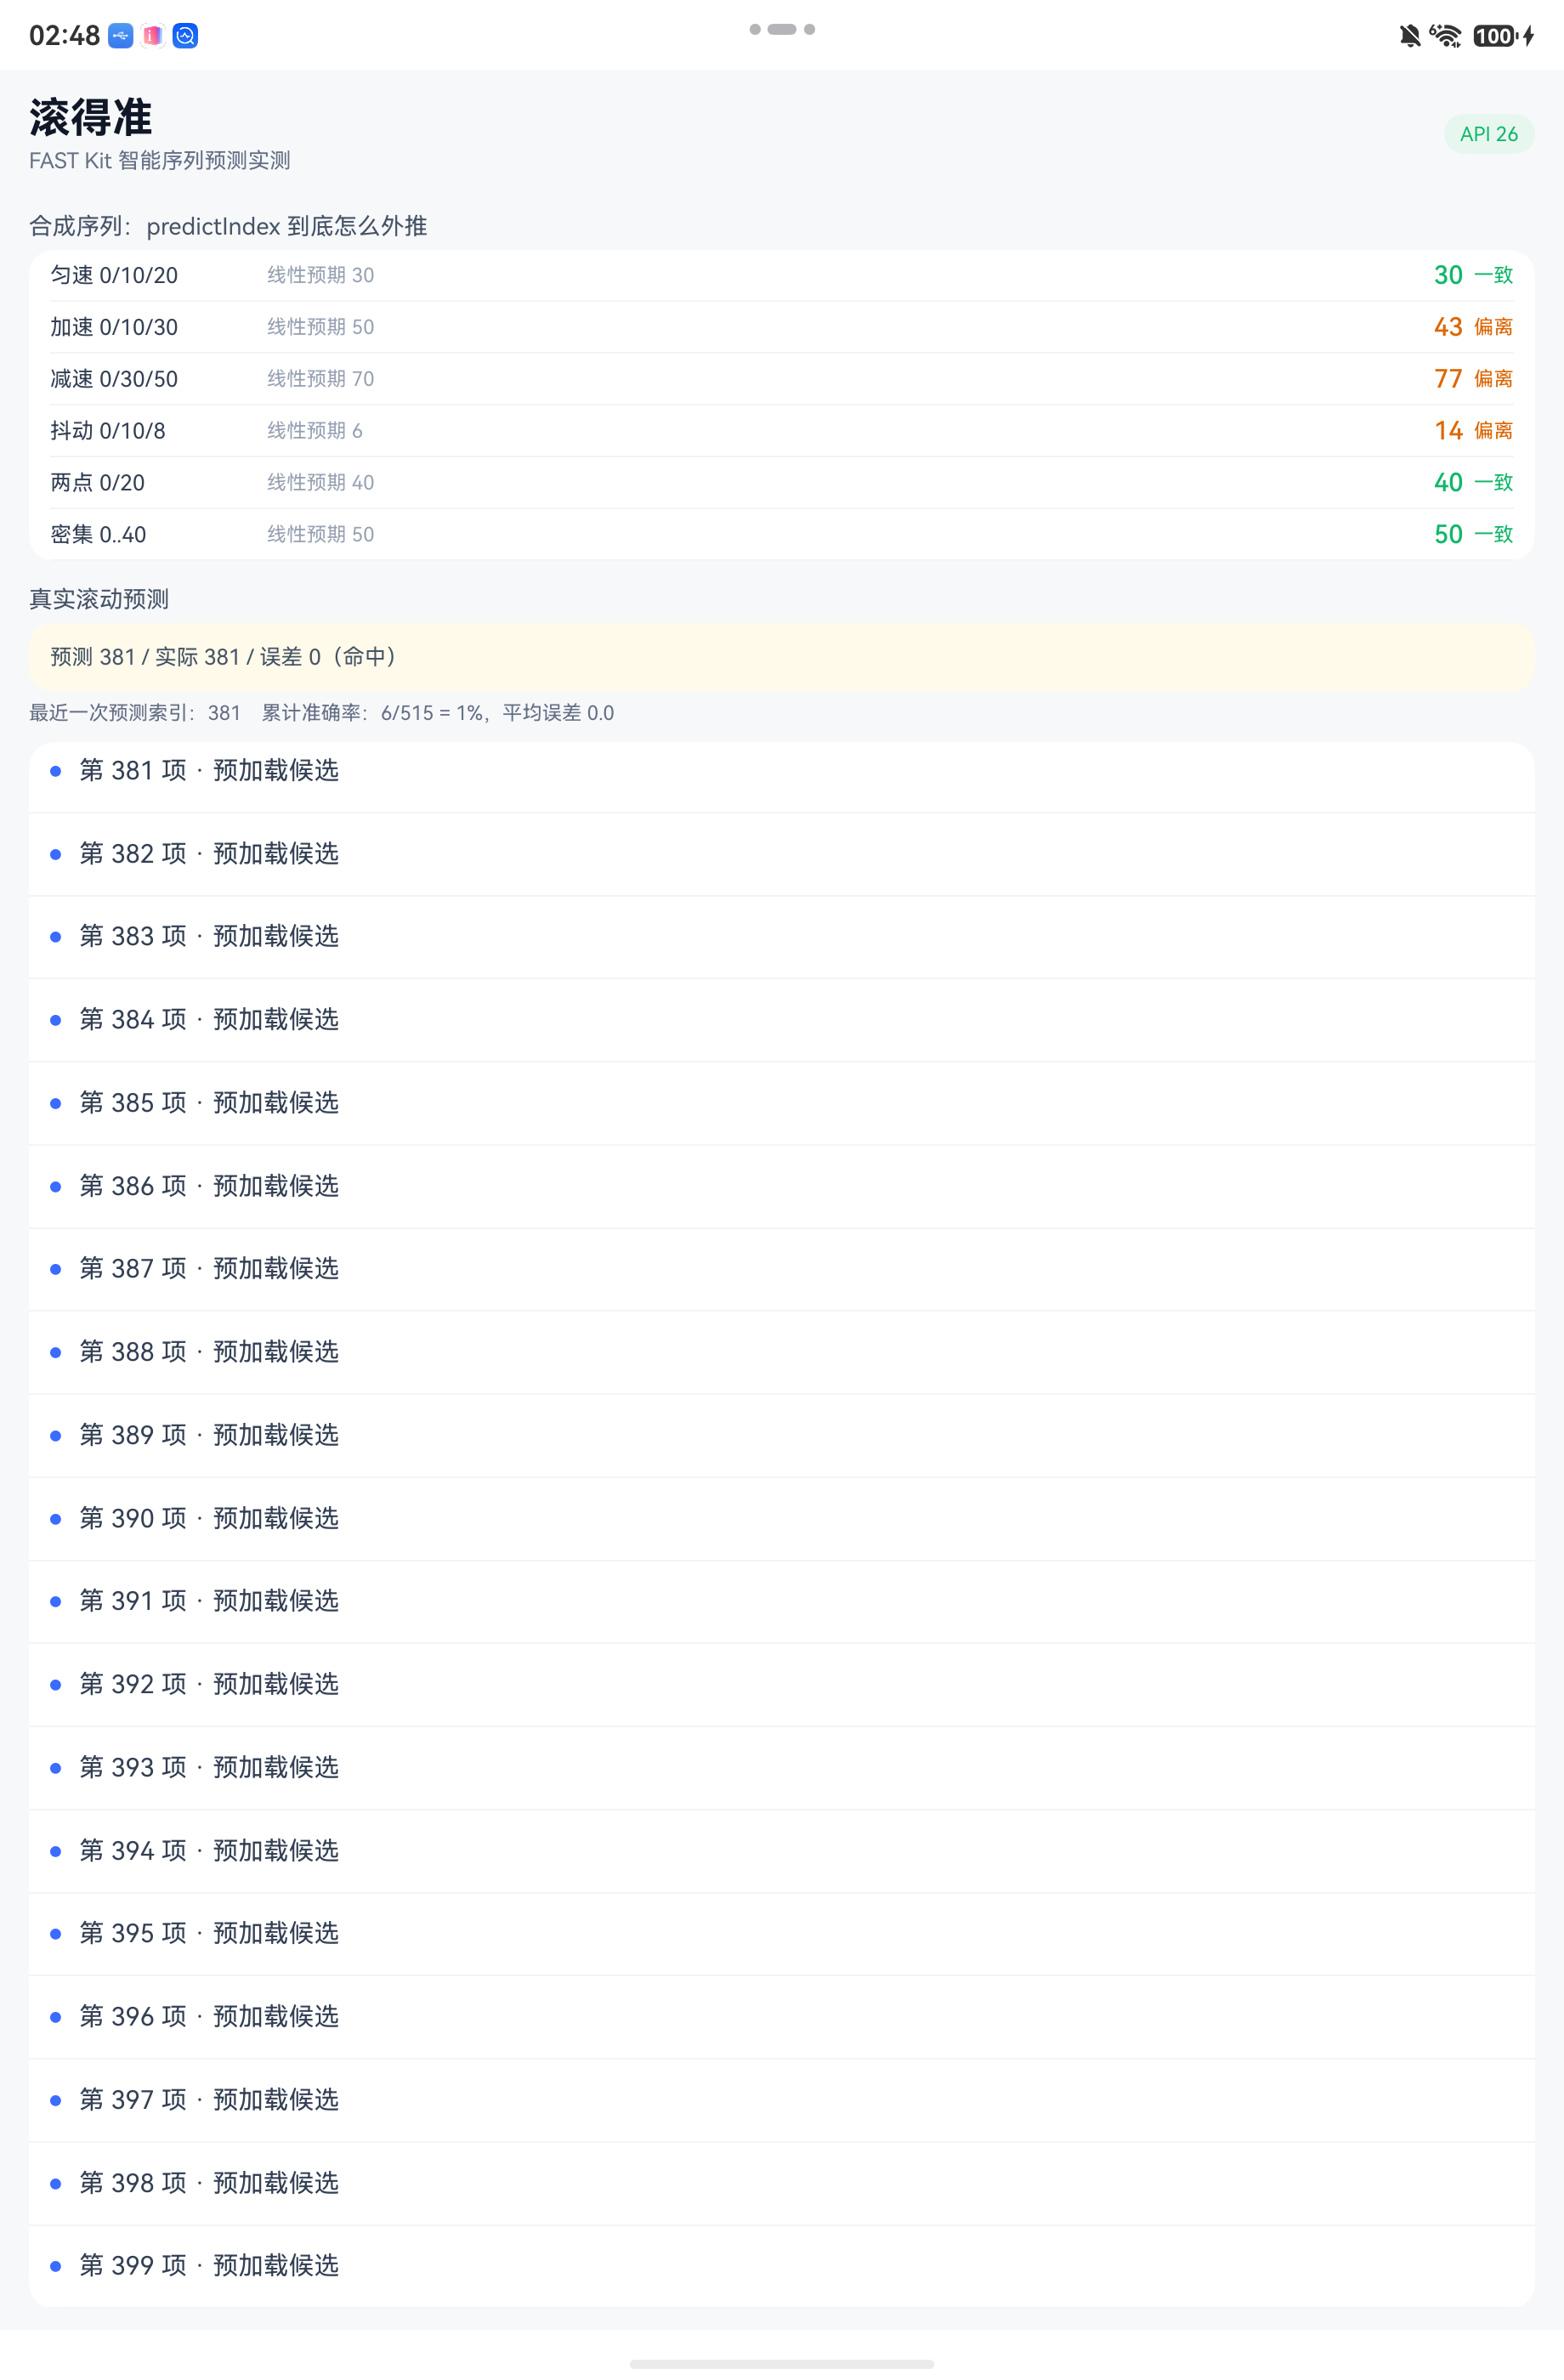
由算法本质推出的三条约束
约束一:加速场景必然低估,预加载会不够。
0→10→30 真实下一步是 50,它给 43。用户越滑越快时,预测值落后于实际位置。若你按预测值做预加载,快速滑动时会先看到占位图。
对策:把预加载窗口设为 预测值 + k,k 按业务容忍度取。本文加速用例的缺口是 7,所以 k≥8 能覆盖。
约束二:减速场景必然高估,会白加载。
0→30→50 真实下一步 70,它给 77。用户正在减速停下时,它仍按较高速度外推,导致加载一批永远看不到的项。
对策:预测值与实际索引之差持续为正时,收缩预加载量。
约束三(最严重):反向运动时预测方向是错的。
0→10→8 最后一步已经在回退(10→8),线性外推应得 6,而它给出 14——继续向前。原因是最小二乘对整窗口拟合,前两个点的强正斜率没有被最后一个负增量抵消。
工程含义很直接:如果你的交互允许用户反向拖动(列表回滑、时间轴来回拖、地图平移),predictIndex 在方向切换的头几帧会给出反向的预测。 用它做预加载会加载错方向,用它做触摸补偿会让光标朝错误方向偏。
使用前必须自己加一层判断:末段增量的符号与拟合斜率相反时,放弃本次预测。
const lastDelta: number = win[win.length - 1].index - win[win.length - 2].index;
const trend: number = win[win.length - 1].index - win[0].index;
if (lastDelta * trend < 0) {
  return -1;   // 方向正在反转,预测不可信
}一个我承认的实验缺陷
界面里我同时显示了"命中率",初版算出来是 1%。
原因是分母取错了:predictCount 在每次 onScrollIndex 回调都自增(一次 fling 约 85 次回调),而"命中"只在每次 fling 停稳时结算一次。6 次 fling 共 515 次预测调用,于是 6/515 ≈ 1%。
正确口径是按滚动会话统计,即 6/6。
这个错误本身值得记一笔:序列预测类 API 的调用频率天然远高于其结果的消费频率,任何"命中率/准确率"埋点都必须先明确分母是调用次数还是会话次数,否则数据会误导你自己。
局限
- 样本量小:合成 6 组、真实 6 次。结论方向可靠,但具体偏差数值(比如"+1 项")不宜外推到其它设备或别的列表项高。
- 未覆盖非单调时间戳:官方只说"可能导致预测不准确",本文没验证具体表现。
- 未验证
perfHint与predictIndex配合使用时的相互影响。
总结
什么场景值得用它:趋势比较平滑的序列外推——列表滚动预加载、触摸点补偿、关键帧补间。
不适合:方向会频繁反转的交互(列表回滑、时间轴来回拖、地图平移),切换后的头几帧它会给出反向预测。
💡 一句话:它是个最小二乘外推器,匀速近乎完美,变速系统性偏差,反向时会判错方向——用之前先加一层符号校验。
参考文献
- FAST Kit 开发指南 · 使用 mathPrediction 进行数理预测:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/fast-math-prediction
- FAST Kit 开发指南 · FAST Kit 简介:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/fast-introduction
- FAST Kit 开发指南 · perfHint 系统性能优化:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/fast-scheduling-optimization
- HarmonyOS 7(API 26) 官方新能力解读 & 开发者实战开发案例合集:https://developer.huawei.com/consumer/cn/forum/topic/0208224160644765091