前言
会议纪要这件事,最贵的不是写,是抄。白板上一整面,散会时有人拍一张发群里,然后第二天三个人对着这张图敲字,敲出来的还不一样。
端侧文字识别(textRecognition)能不能把这张照片直接变成文本?这个问题用一句话回答没意义,得给数字。所以我搭了一个可控实验:已知内容的白板图 × 5 种拍摄条件 × 方向检测开关两态 = 10 次识别,每次算字符级指标。
这篇文章就是这 10 组数字,以及它推翻的三个直觉。
实验设计
真值:8 行中文,去掉空格后共 101 字符。内容是一次会议的真实产出(目标、瓶颈、两个方案、负责人、时间、风险、结论)。
拍摄条件(全部由脚本从同一张母图派生,所以差异只来自条件本身):
| 条件 | 做法 | 成品尺寸 |
|---|---|---|
| 正拍 | 无 | 1600×900 |
| 透视倾斜 | 四角各偏移 2%~6% 的 QUAD 变换 | 1600×900 |
| 旋转 90° | 整图逆时针转 90° | 900×1600 |
| 旋转 180° | 倒置 | 1600×900 |
| 暗光+糊+小图 | 缩到 0.5、亮度 45%、高斯模糊 1.2 | 800×450 |
指标(三个一起看,只看一个必然得出错误结论):
chars:识别出的字符数(去空格)lines:8 行里有多少行完整无损地出现在结果中dist:与真值的 Levenshtein 编辑距离,字符正确率 =(101 - dist) / 101
10 组数据
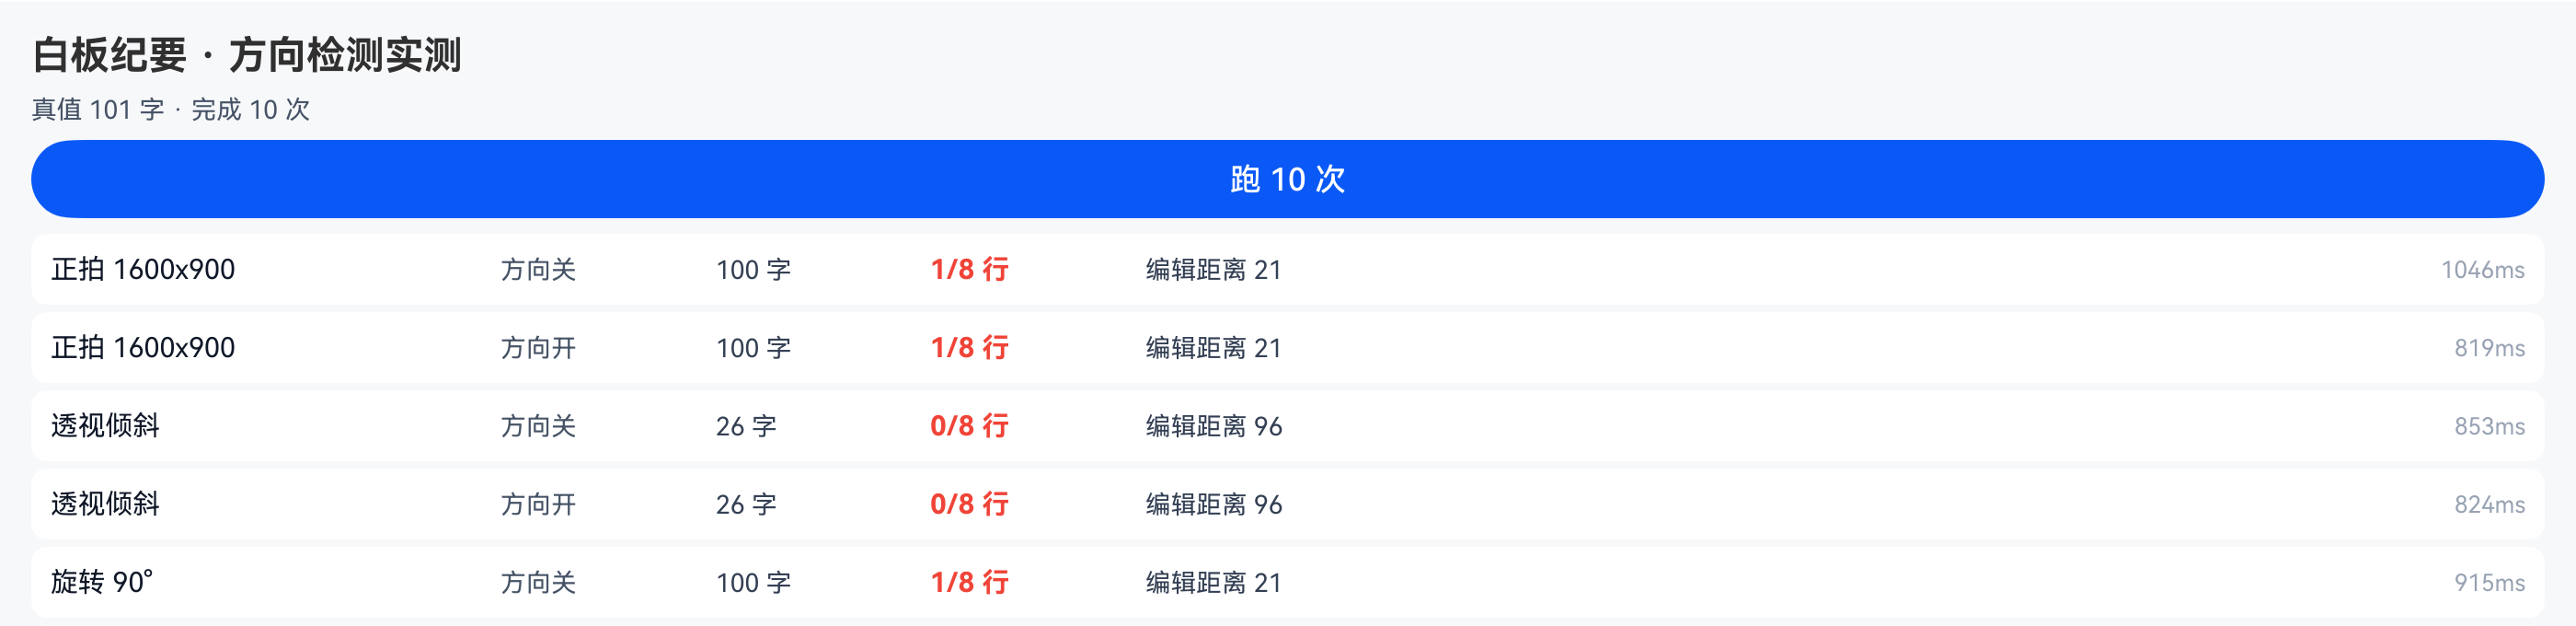
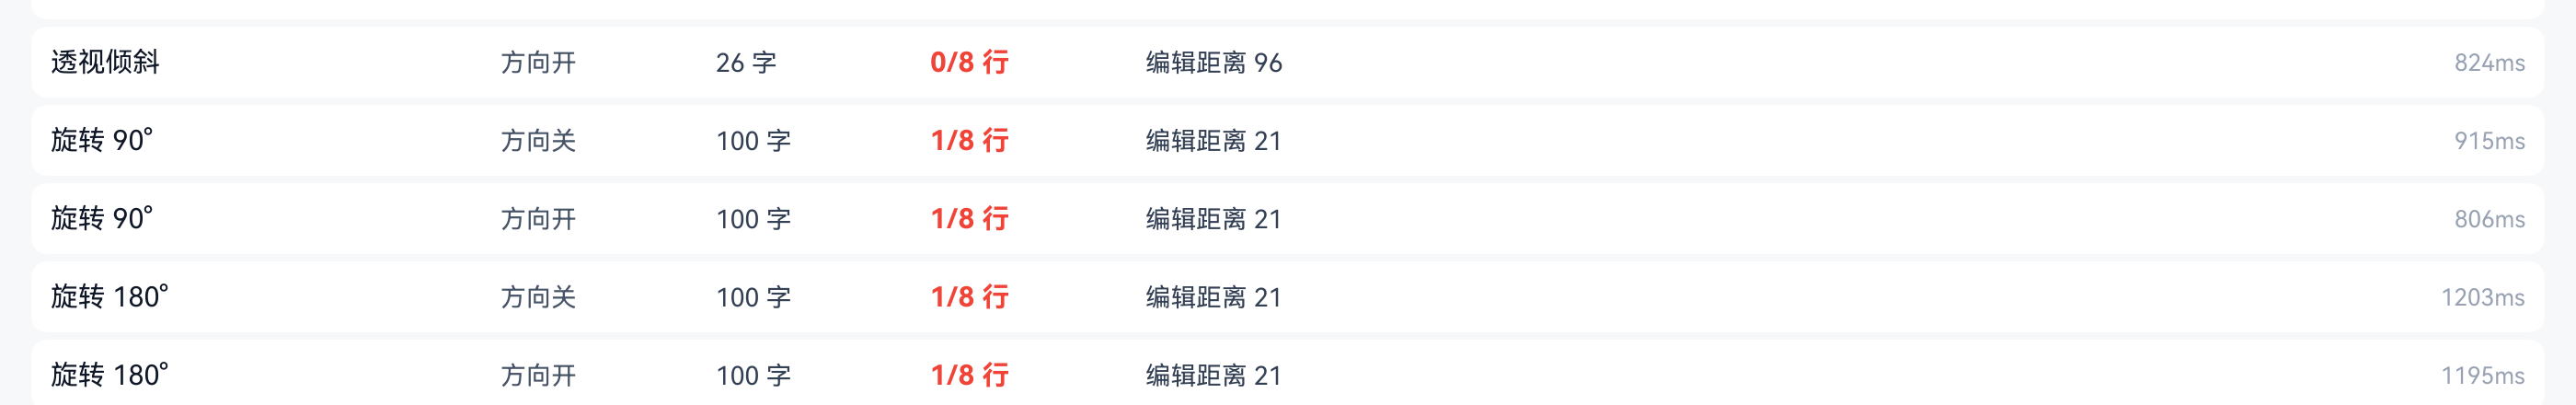
| 条件 | 方向检测 | chars | lines | dist | 字符正确率 | 耗时 |
|---|---|---|---|---|---|---|
| 正拍 | 关 | 100 | 1/8 | 21 | 79.2% | 1047ms |
| 正拍 | 开 | 100 | 1/8 | 21 | 79.2% | 820ms |
| 透视倾斜 | 关 | 26 | 0/8 | 96 | 4.9% | 853ms |
| 透视倾斜 | 开 | 26 | 0/8 | 96 | 4.9% | 825ms |
| 旋转 90° | 关 | 100 | 1/8 | 21 | 79.2% | 916ms |
| 旋转 90° | 开 | 100 | 1/8 | 21 | 79.2% | 807ms |
| 旋转 180° | 关 | 100 | 1/8 | 21 | 79.2% | 1204ms |
| 旋转 180° | 开 | 100 | 1/8 | 21 | 79.2% | 1196ms |
| 暗光+糊+小图 | 关 | 100 | 1/8 | 21 | 79.2% | 816ms |
| 暗光+糊+小图 | 开 | 100 | 1/8 | 21 | 79.2% | 918ms |
三个观察点,每个都反直觉。
观察一:指标选错,结论能差 6 倍
同一批结果,lines 说的是"8 行只对 1 行,命中率 12.5%",字符正确率说的是"79.2%"。
差在哪:lines 要求整行一字不差。而错误是散落的——一个标点、一个"百分之十"变成"10%"、一个空格——每行都可能中一两个字符,于是 8 行里 7 行被判废。
这不是理论问题。如果我们的验收标准写成"整行匹配率 ≥ 90%",这个项目会被判定为不可用;写成"字符正确率 ≥ 75%",它就是可用的。同一个模型、同一份数据,两种结论。
所以定验收口径时我的做法是:主指标用编辑距离,lines 只作为辅助(它高说明结构完整,低不代表不可用)。
观察二:方向检测开关,十组数据里测不出任何差异
isDirectionDetectionSupported 这个参数,字面理解是"支持方向检测",直觉上应该在旋转 90°/180° 时起决定性作用。
实测:10 组里,同一条件的两态在 chars、lines、dist 上完全相同,一个字符都不差。倒置 180° 的图,关掉开关照样读出 79.2%。
耗时上两态互有高低(820 vs 1047、807 vs 916、1196 vs 1204、918 vs 816),是噪声,不是差异。
这条我不敢下强结论,因为有两种解释都能对上数据:
- 识别器本身对旋转免疫,这个开关是历史遗留或给别的模式用的;
- 这个参数在当前版本上根本没生效。
区分两者需要一个正对照——一张只有开了方向检测才能读出来的图。我构造不出来,因为随手旋转的三种角度全都读得出来。所以结论只能写成:在当前测试范围内,这个开关可以忽略;但不要把它当成"我做了方向适配"的依据。
观察三:真正的杀手是拍歪,不是转倒
透视倾斜那一组,字符正确率从 79.2% 掉到 4.9%,识别出的内容只剩 26 个字符。
而这个形变有多小?四个角各偏移 2%~6%,肉眼看就是一张"没正对白板拍的"照片。
对比一下五种条件的破坏力排序:
旋转 180°   → 无影响
旋转 90°    → 无影响
缩一半+暗+糊 → 无影响
轻微透视 → 几乎全废这个排序很反直觉:我们通常担心"拍倒了""拍糊了""像素不够",而实测里唯一致命的是透视。原因是旋转只改变朝向,字符的笔画结构不变;透视会把笔画做非均匀拉伸,同一个字在画面上下两端的形变还不一样,识别器学到的分布直接失配。
对产品来说,这是一句能直接写进引导文案的话:"请正对白板拍摄"比"请拿稳、光线充足"重要得多。 前者防的是唯一会归零的失败模式。
顺带一条:字高才是分辨率的度量
"暗光+糊+小图"这一组缩到 800×450 仍然 79.2%,看着像是"分辨率不重要"。但把它和另一批数据放在一起就不是了。
同一台设备上做快递面单实验时:300×395 的面单能完整识别运单号,200×263 就开始丢字符、把 D 认成 O。
两批数据的共同点是:决定成败的不是图片像素,是单个字的高度像素。
| 样本 | 原图字高 | 缩放后字高 | 结果 |
|---|---|---|---|
| 白板 46px → 0.5 | 46px | 23px | 正常 |
| 面单 62px → 0.39 | 62px | 24px | 正常 |
| 面单 62px → 0.26 | 62px | 16px | 崩 |
两个"正常"都在 23~24px,唯一"崩"的是 16px。所以我的经验线是 20px:字高低于 20px 就别指望端侧 OCR。
但这是三个数据点拟合出来的假设,不是结论。要拿它做产品决策,得在 16~24px 之间补测一批,并且覆盖中文、数字、英文三种字型——它们的笔画密度差别不小。
真机数据
| 项目 | 实测值 |
|---|---|
| 设备 | MatePad Pro(HarmonyOS 7 / API 26,序列号略) |
| 真值长度 | 101 字符(8 行,去空格) |
| 正常条件字符正确率 | 79.2%(4 种条件完全一致) |
| 透视倾斜字符正确率 | 4.9% |
| 整行无损命中 | 1/8 |
| 单次识别耗时 | 807 ~ 1204ms |
| 10 次总耗时 | 约 9.4s |
总结
拍白板这件事,端侧识别的产出是"能直接编辑的文本",不是"排版还原"。79.2% 的字符正确率意味着你要人工过一遍,但比从头敲快得多——尤其是数字、人名、百分比这类不能错的内容,识别出来的是"候选",人只做校对。
不适合指望它做结构化归档(自动分派任务、自动提取结论)。整行匹配 1/8 就是原因:小错散落,任何按行做的规则抽取都会大面积失效。
💡 一句话:白板拍照最大的敌人不是拿不稳、不是光线暗,是没正对——轻微透视能把 79% 直接打到 5%。
参考文献
- 通用文字识别(开发指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-text-recognition
- textRecognition(通用文字识别)API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-text-recognition-api
- Core Vision Kit 错误码:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/errorcode-core-vision
- Core Vision Kit 目录:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-kit-guide