前言
行政提的需求很朴素:门口放台平板,员工路过刷一下就算签到,不想再排队按指纹。
选型时我们排掉了云端人脸服务,两个理由:一是员工生物特征出内网要走合规评审,二是按次计费,一个 300 人厂区一年下来不是小数目。鸿蒙 7 的 Core Vision Kit 里 faceComparator 是纯端侧的,两个 PixelMap 进、一个相似度出,看起来正好。
两周后我们把 demo 做完了,今天把这个项目复盘一次。结论是能力够用,但接口给的那个布尔值不能直接用——而且它错的方向,恰好是签到场景里最贵的那一种。
结论先行
- 同一张脸,在七种图像扰动下相似度全部 ≥ 0.974,模型本身很稳。
- 十组比对里,SDK 的
isSamePerson判错两组,两组都是把陌生人判成同一个人(误识,不是拒识)。 - 正确的用法是自己拿
similarity定阈值。按这一批数据,阈值取 0.8 可以十组全对。
下面按我们实际做的顺序展开。
数据怎么造的
人脸比对的测试集不能拿网图凑,因为你不知道标准答案。所以我们自己控制:三张底片(A 男、B 女、C 戴眼镜男),A 做扰动生成正样本,跨人组合做负样本。
正样本(A vs A 的变体):自己、旋转 12°、亮度压到 45%、高斯模糊 3.0、
                        缩到 160px 再放回 640、紧裁到脸占满、水平镜像
负样本:A vs B、A vs C、B vs C
这样每一组的期望值是先验确定的,测出来的偏差只能来自模型和阈值。
接口只有三个调用
await faceComparator.init();
const v1: faceComparator.VisionInfo = { pixelMap: pm1 };
const v2: faceComparator.VisionInfo = { pixelMap: pm2 };
const r: faceComparator.FaceCompareResult = await faceComparator.compareFaces(v1, v2);
// r.similarity: 0~1,r.isSamePerson: 布尔
await faceComparator.release();
约束记两条:PixelMap 必须是 RGBA_8888;init() 有状态,整个批量过程只做一次,别每次比对都 init/release。
真正需要注意的是 isSamePerson 这个字段——它是 SDK 用它自己的阈值算出来的,而文档里没写那个阈值是多少。这就是后面所有问题的来源。
实测结果
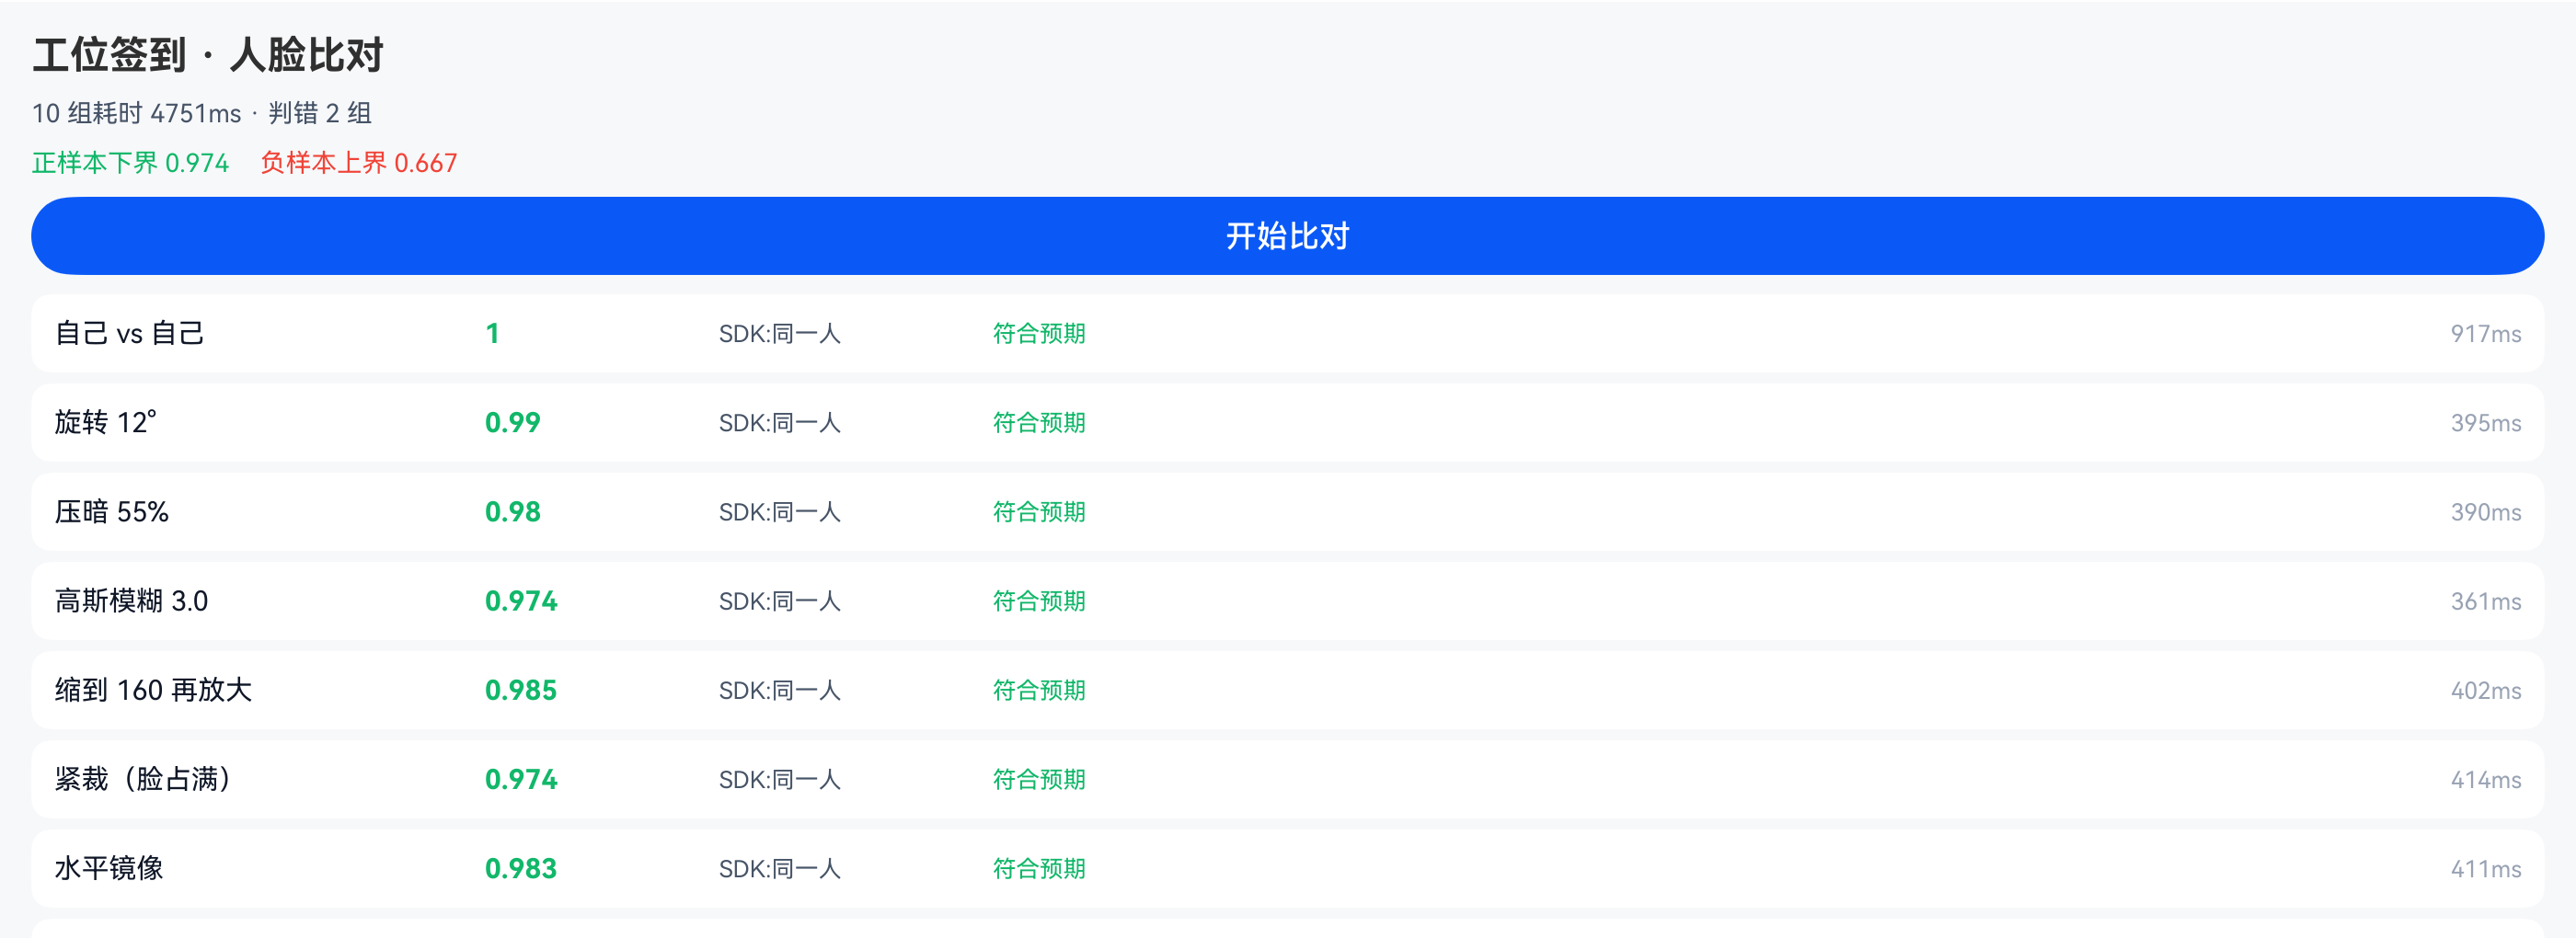
MatePad Pro(HarmonyOS 7 / API 26),一次跑完十组:
| 组 | 期望 | similarity | SDK 判定 | 结论 | 耗时 |
|---|---|---|---|---|---|
| 自己 vs 自己 | 同人 | 1.000 | 同一人 | 对 | 918ms |
| 旋转 12° | 同人 | 0.990 | 同一人 | 对 | 396ms |
| 亮度压到 45% | 同人 | 0.980 | 同一人 | 对 | 391ms |
| 高斯模糊 3.0 | 同人 | 0.974 | 同一人 | 对 | 361ms |
| 缩到 160 再放大 | 同人 | 0.985 | 同一人 | 对 | 402ms |
| 紧裁(脸占满) | 同人 | 0.974 | 同一人 | 对 | 415ms |
| 水平镜像 | 同人 | 0.983 | 同一人 | 对 | 411ms |
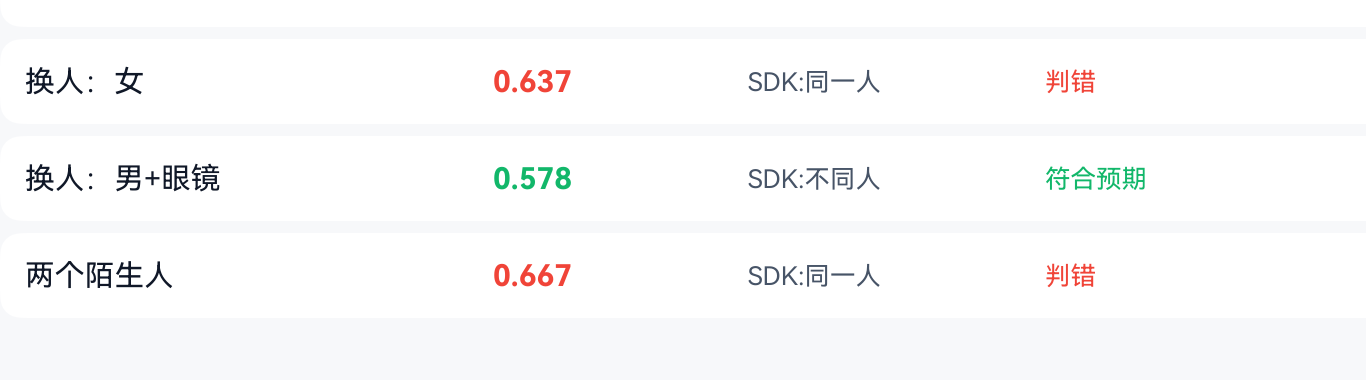
| 换人:女 | 不同人 | 0.637 | 同一人 | 判错 | 389ms |
| 换人:男+眼镜 | 不同人 | 0.578 | 不同人 | 对 | 417ms |
| 两个陌生人 | 不同人 | 0.667 | 同一人 | 判错 | 411ms |
十组合计 4751ms。首组 918ms 是模型预热,之后稳定在 360~420ms。
这次做对了什么
把正负样本的分布跑出来,而不是只跑"能不能用"。 正样本下界 0.974、负样本上界 0.667,中间隔着 0.31 的空档。这说明模型的区分度其实非常好——问题完全不在识别上。
一旦看清这一点,修法就 trivial:不要用 isSamePerson,用 similarity > 0.8 自己判。这一批数据下十组全对,而且 0.8 距离两侧都有余量,不是勉强挑出来的边界值。
顺手排掉了两个常见的担心。 水平镜像 0.983,说明前置摄像头镜像出来的照片不需要特殊处理;紧裁 0.974,说明人脸在画面里的占比变化不敏感——这两条如果靠猜,上线前总要专门测一轮。
这次踩的坑
坑只有一个,但值得单独一节:SDK 的内置阈值太低,而且不写在文档里。
从数据反推,判定线落在 0.578 与 0.637 之间(0.578 判不同、0.637 判相同),大概率是 0.6。这个值放在"图库照片分类"里没问题,放在"签到"里就是事故:两个陌生同事只要相似度摸到 0.6,就能互相代打卡。
复盘时我们争论过要不要保留 isSamePerson。最后决定:**接口返回值只看 similarity,isSamePerson 当它不存在。**理由是阈值必须是产品参数,不能是黑盒常量——行政以后要调松紧,你总不能再发一版。
可信度评估
这份数据能支撑什么结论,不能支撑什么结论,得说清楚。
能支撑:端侧比对对图像质量扰动不敏感;isSamePerson 的默认判定线明显低于本场景可接受的水平。
不能支撑:负样本只有三组,而且三张底片出自同一个图像模型、同一套 prompt 模板、同一种灰底棚拍。这种"同族"人脸天然比真人更像,0.637 / 0.667 很可能是被高估的。真人之间的相似度分布我们没有测,所以 0.8 这个阈值目前只能算起点,不能算结论。
最大的遗留风险不是阈值,是活体。 faceComparator 只比像素,不判断镜头前是脸还是一张打印照片、一部正在放视频的手机。签到场景里,这是比误识严重得多的问题,而我们这一轮完全没碰。
另外没测的还有:戴口罩、侧脸超过 30°、逆光与强光、双人同时入镜时取哪张脸。
下一步
- 真人重测:20 人 × 每人 3 张(不同时间、不同光线),跑出正负两条分布,再定阈值,并且做成后台可配 + 灰度。
- 补活体:要么走动作指令(眨眼/转头),要么只上在有结构光的机型上。这一步不做,前面所有优化都是给一个能被照片骗过的系统调参。
- 把"比对"和"识别"拆开:现在是一对一验证(本人 + 工号),如果以后要做"走过就签到"的一对 N,得先看 N 大了以后误识率怎么变。
真机数据
| 项目 | 实测值 |
|---|---|
| 正样本 similarity 区间 | 0.974 ~ 1.000(7 组) |
| 负样本 similarity 区间 | 0.578 ~ 0.667(3 组) |
| SDK 判错 | 2/10,全部是误识方向 |
| 反推内置阈值 | 落在 (0.578, 0.637],文档未给出 |
| 首组耗时 | 918ms(含预热) |
| 稳定耗时 | 360 ~ 420ms / 组 |
| 十组总耗时 | 4751ms |
总结
端侧人脸比对适合"一对一验证"这种受控场景:本人主动出示、已知工号、只比一张底库照片。行政签到、门禁复核、设备共享时的身份确认,都在这个范围内。
不适合"走过就打卡"式的一对 N,也不适合在没有活体检测的前提下谈安全。这次真正的收获不是"接口能不能用",而是接口替你做的那个决定(阈值)恰好是你最不该交给它的那个。
💡 一句话:
faceComparator只看similarity,把isSamePerson当它不存在——阈值必须是你的产品参数,不是黑盒常量。
参考文献
- 人脸比对(开发指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-face-comparator
- faceComparator(人脸比对)API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-facecomparator-api
- Core Vision Kit 错误码:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/errorcode-core-vision
- Core Vision Kit 目录:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-kit-guide