前言
上周产品在同一条消息里 @ 了我两次:「首页下滑有点糊,鸿蒙 7 不是有个性能提示的接口吗,加上试试。」
她指的是 schedulingOptimization.perfHint,鸿蒙 7(API 26.0.0)随 FAST Kit 放出来的那个。
这个需求我没法直接接。"糊"可能是掉帧,可能是高刷屏没抬到高档位,也可能是图片加载慢——三种原因对应三种改法,只有第一种和 perfHint 有关,而且关系还很弱。所以我没先加接口,先搭了一个和她说的首页长得一样的信息流,把帧率直接显示在页面上,量了一遍。
量完的结果比"加不加"更有意思:这个页面在滑动时本来就不掉帧;等我真的把掉帧造出来之后,perfHint 一点忙都没帮上。 下面按接口、怎么量、六组数据、结论的顺序写。
perfHint 能做什么
它做的事情只有一件:在你预感到"接下来这一小段要抢资源"之前,把这段预期告诉系统,让调度器提前把 CPU、GPU 的频率和优先级准备好。
官方文档里有一句要放在前面读:perfHint 只是应用向系统发送的性能优化提示,系统会综合考量整机 CPU 负载、温度等因素决策,不保证一定进行性能提升。
需要注意的是,这句话不是免责模板,是实测结论。我们这次所有带提示的组,都没测出提升。
它适合的位置是那些"开始时刻明确、时长有限"的过程:应用启动、页面切换、首屏绘制、动效播放、编解码起播。不适合的位置,是把它当成"滑动不流畅"的通用开关——滑动本身是一个持续的、由你每帧干了什么决定的过程,提示改变不了你占住主线程的那几十毫秒。
- 场景类型(sceneType):告诉系统这一段在干什么的枚举值,共 9 种,见下表。
- BEGIN / END:一次提示的起止配对,只发 BEGIN 不发 END 会被系统按最大时长回收。
接口与约束
调用只有一个:
import { schedulingOptimization } from '@kit.FASTKit';

const cfg: schedulingOptimization.PerfHintConfig = {
  sceneType: schedulingOptimization.SceneType.ANIMATION,
  sceneState: schedulingOptimization.SceneState.BEGIN,
  durationType: schedulingOptimization.DurationType.MEDIUM,
  tids: []
};
await schedulingOptimization.perfHint(cfg);
PerfHintConfig 四个字段的取值域:
| 字段 | 取值 |
|---|---|
sceneType |
1 APP_LAUNCH、2 PAGE_TRANSITION、3 PAGE_LOAD、4 NETWORK_FILE_PROCESSING、5 LOCAL_FILE_PROCESSING、6 PAGE_DRAWING、7 ANIMATION、8 MEDIA_PLAYBACK、9 MEDIA_ENCODING_AND_DECODING |
sceneState |
1 BEGIN、0 END |
durationType |
1 SHORT(单次 ≤1s,两次间隔 >3s)、2 MEDIUM(≤10s,>30s)、3 LONG(≤60s,>180s) |
tids |
线程 ID 数组,可同时提示多个线程,留空表示主线程 |
三个硬约束:仅前台生效;不要和 QoS API 混用;每一档都有最小间隔要求。
失败时的错误码是一份很好的诊断表:
| 错误码 | 含义 |
|---|---|
| 1027700001 | 系统负载高 |
| 1027700002 | 省电模式 |
| 1027700003 | 低电量模式 |
| 1027700004 | 非前台调用 |
| 1027700005 | 间隔不满足要求 |
| 1027700006 | 调度优化执行失败 |
也就是说"加了没生效"这件事,有一部分情况系统是明确告诉你的——前提是你把 Promise 的 reject 打出来,而不是 await 完就往下走。我们第一版就是没打,白跑了半天。
我们一步一步写
第 1 步:先把帧率挂到页面上
判断滑动有没有变好,得有帧数据。ArkUI 给的是 displaySync:
import displaySync from '@ohos.graphics.displaySync';

private consumer: displaySync.DisplaySync = displaySync.create();

aboutToAppear(): void {
  this.consumer.on('frame', (info: displaySync.IntervalInfo) => {
    const now: number = info.timestamp / 1000000;   // 纳秒转毫秒
    if (this.prev > 0) {
      const gap: number = now - this.prev;
      // gap 就是一帧的间隔,采样期里累计均值 / 最大值 / 超阈值次数
    }
    this.prev = now;
  });
  this.consumer.start();      // ← 少了这一行,永远收不到回调
}这里有一个足够坑到任何人的细节:on('frame') 之后必须调用 start()。我们第一版没调,跑出来 frames=0,看起来像"这台设备不支持",实际上只是没订阅成功,而且它不报错。
指标定义成三个,都能一眼看懂:
- 均帧:采样窗口内收到的 vsync 帧数 ÷ 实际时长
- 最差帧:单帧最大间隔(毫秒)
- 掉帧次数:间隔 > 20ms 的帧数
阈值取 20ms 是刻意宽松的——144Hz 一帧 6.9ms,20ms 意味着这一帧已经慢到肉眼可见。
第 2 步:造一个像样的信息流
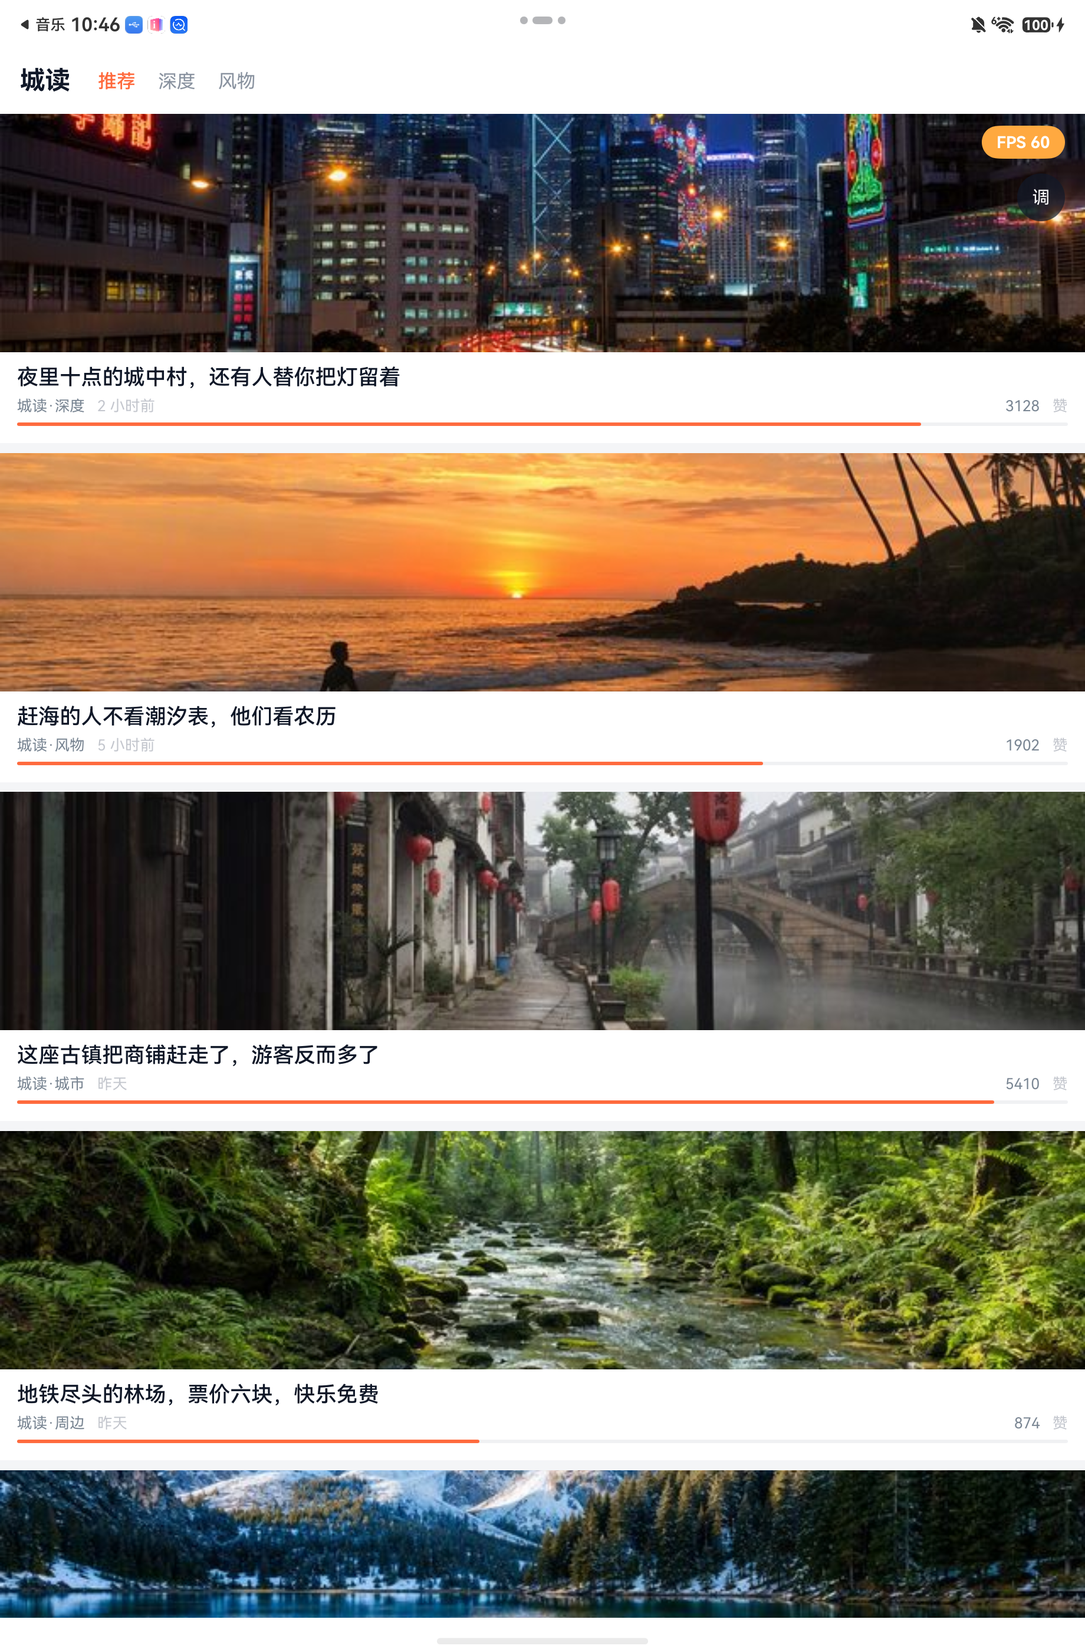
这一步的目的不是测接口,是先有一个能替产品回答"糊在哪"的页面。48 张卡片(8 篇内容循环 6 遍),每张是 640×480 的封面图 + 标题 + 来源 + 时间 + 点赞数 + 热度条,List 配 cachedCount(2)。页面上浮两个东西:右上角一个实时帧率徽标,绿色 ≥100、橙色 ≥60、红色更低;右下角一个「调」字圆点,点开是调试面板。
徽标直接用上面的 gap 换算,Text 的底色由 @State fps 决定,所以它是活的,不是截图时凑数的。
第 3 步:给"掉帧"找一个真实来源
空跑的结果是满帧,perfHint 无事可做。要判断它到底有没有用,得先有一个真实存在的掉帧原因,而不是随手写个死循环。
信息流里最常见的一种真实反模式是:卡片进入可视区时,顺手在主线程上把这张卡片的高清原图解码出来,准备用户点开就能看。后台原图直出、没接缩略图 CDN 的项目,代码形态基本就是这样。
复现它只要三行,挂在 onScrollIndex 上:
List({ scroller: this.sc }) { /* ... */ }
  .onScrollIndex((first: number, last: number) => {
    this.onVisible(first, last);      // 每个新进入可视区的下标解码一次
  })

// 同步版:读文件 + 解码,全在主线程
const buf: Uint8Array = cxt.resourceManager.getRawFileContentSync(CARDS[idx].big);
const src: image.ImageSource = image.createImageSource(copy);
const pm: image.PixelMap = src.createPixelMapSync();
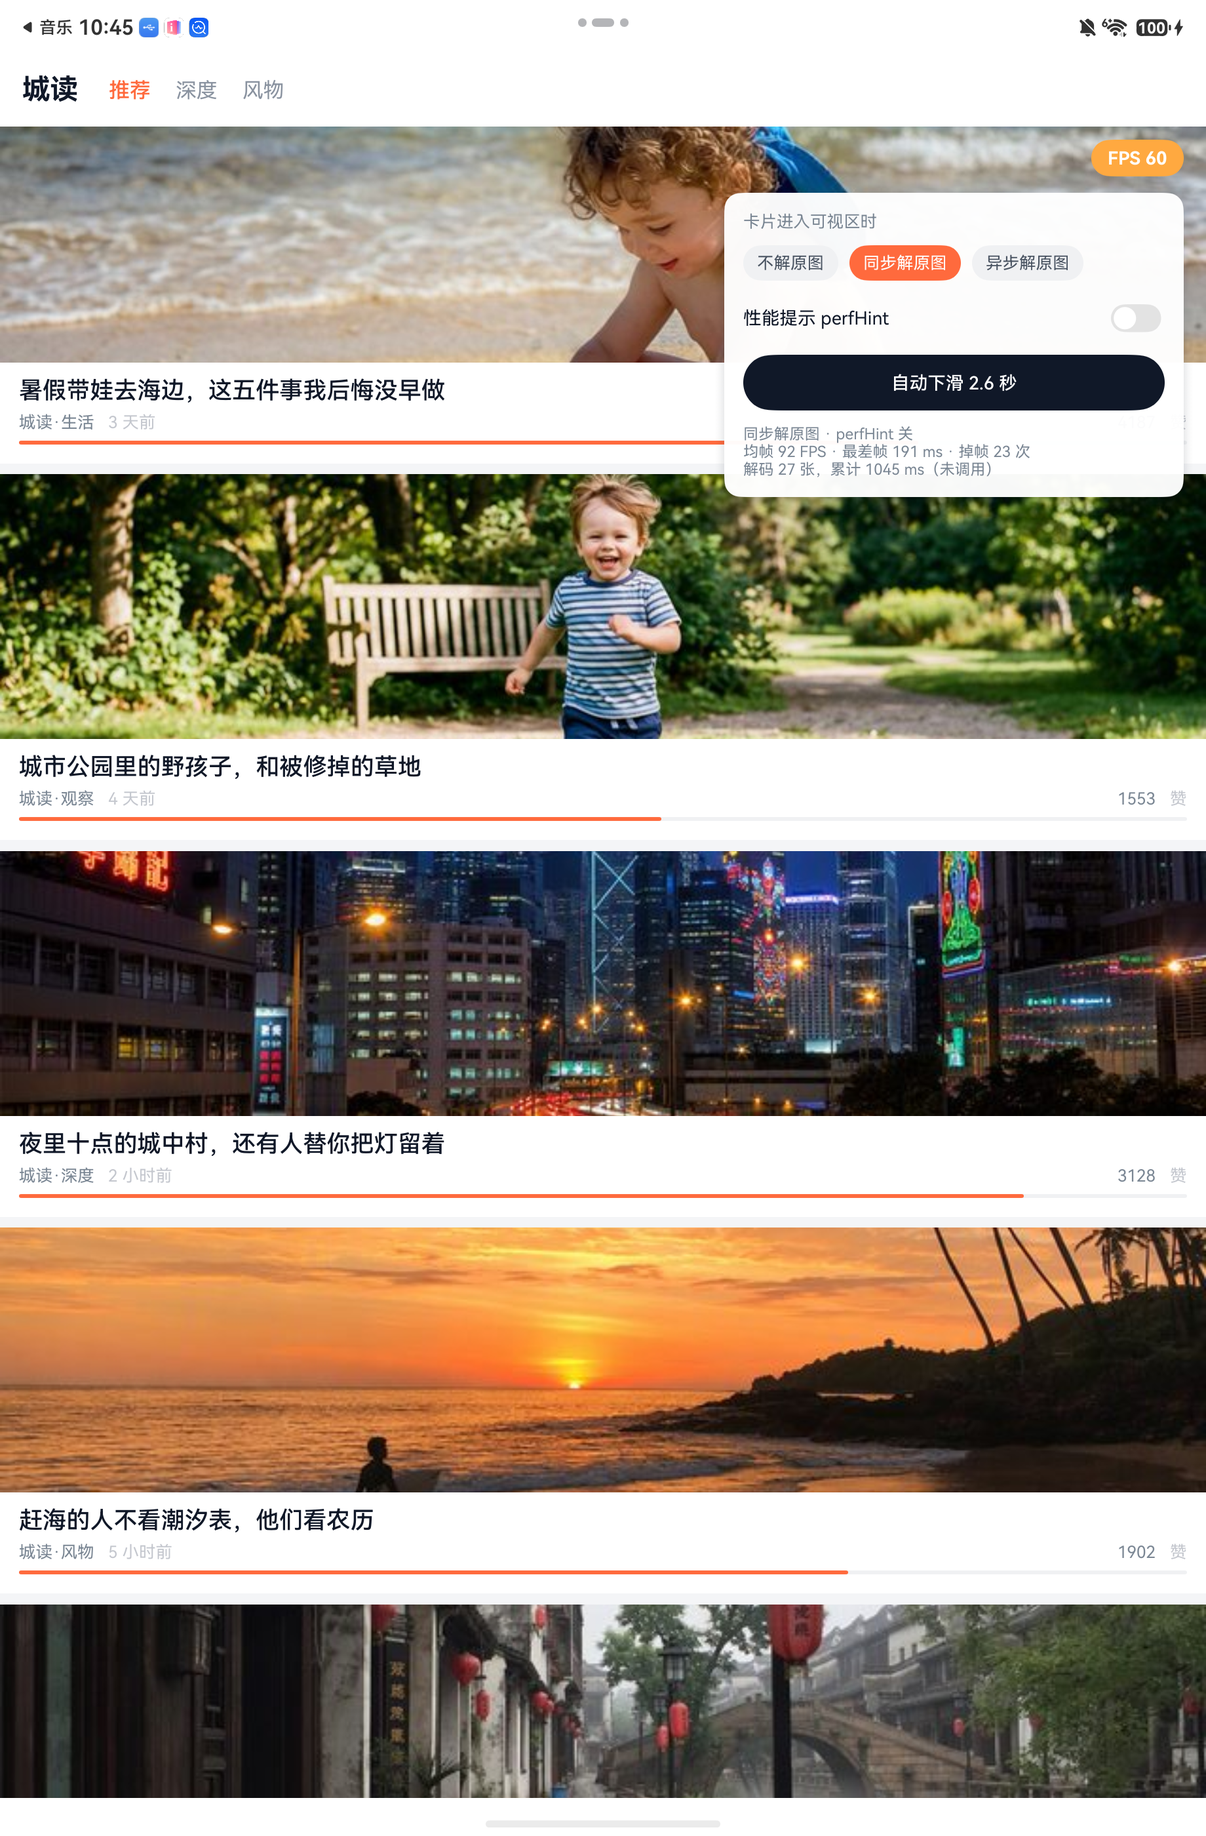
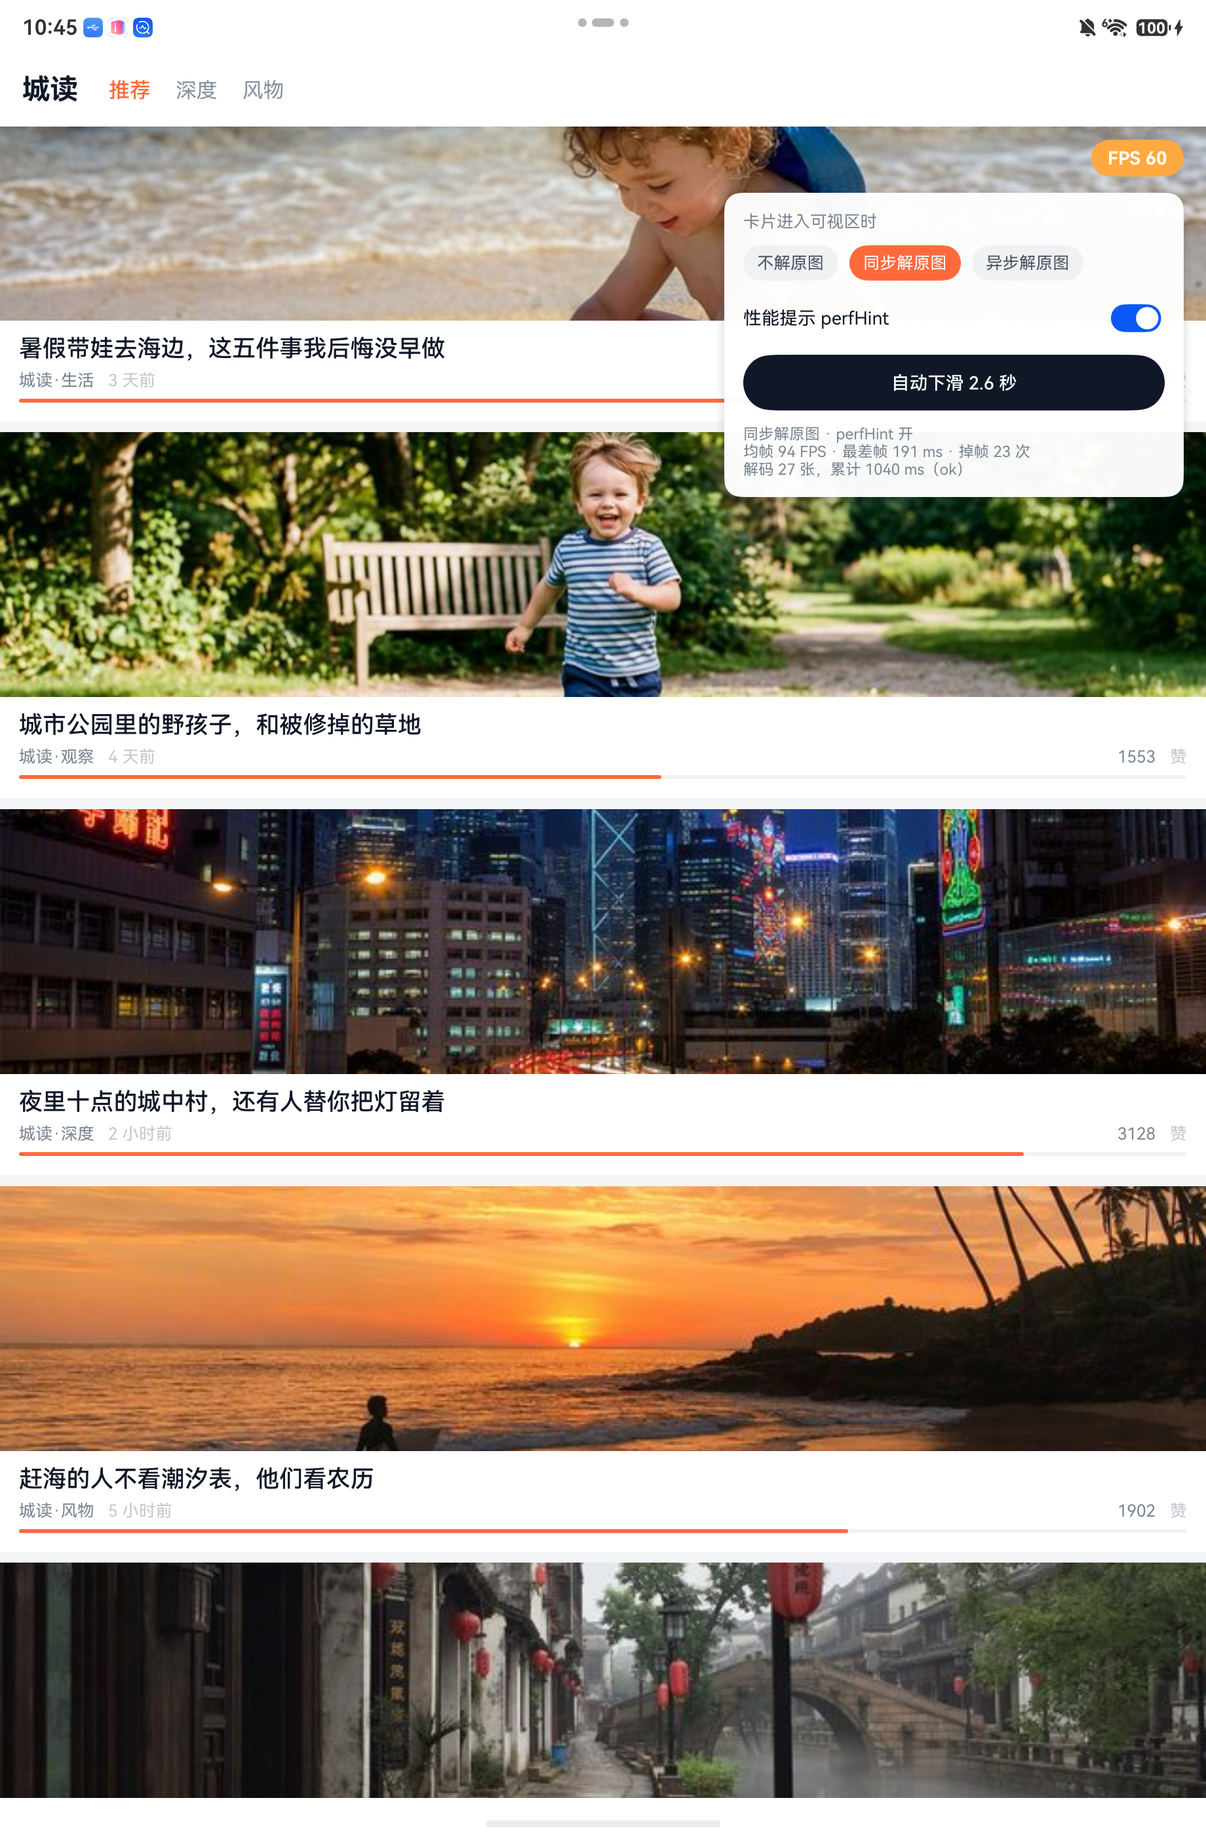
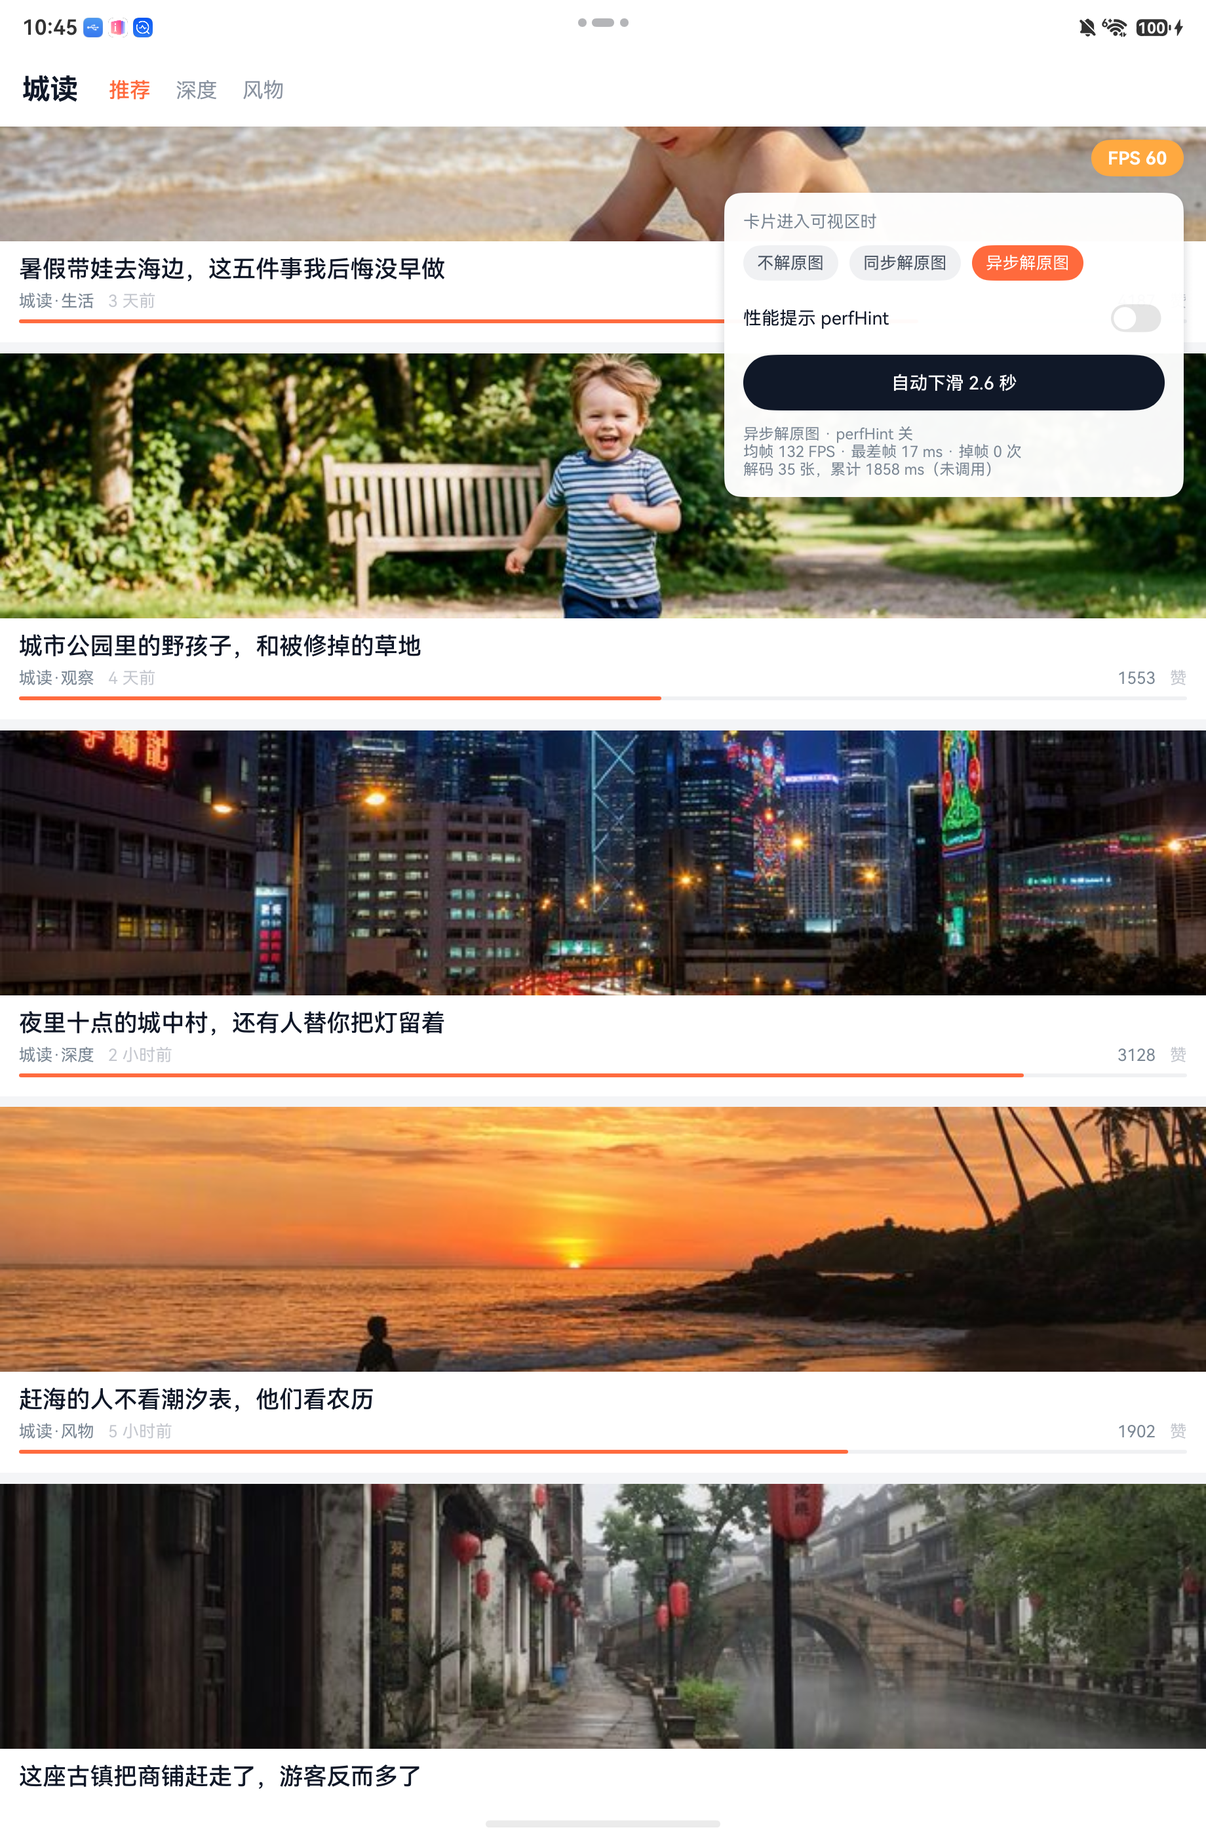
调试面板里做成三个胶囊:不解原图 / 同步解原图 / 异步解原图,外加一个 perfHint 开关和一个「自动下滑 2.6 秒」按钮。自动下滑是 scrollBy(0, 30) 加 sleep(8) 的循环——顺带说一句,sc.fling(9000) 在这个 List 上完全不生效,试了两轮才换掉。
第 4 步:跑对照
同一份代码、同一台设备、每次跑之前都从第 0 张重新下滑,六组结果:
| 卡片进入可视区时 | perfHint | 均帧 | 最差帧 | 掉帧次数 | 解码 |
|---|---|---|---|---|---|
| 不解原图 | 关 | 132 FPS | 9 ms | 0 | — |
| 同步解原图 | 关 | 91 FPS | 199 ms | 23 | 27 张 / 1043 ms |
| 同步解原图 | 开 | 94 FPS | 190 ms | 23 | 27 张 / 1035 ms |
| 同步解原图 | 关(复测) | 92 FPS | 191 ms | 23 | 27 张 / 1045 ms |
| 异步解原图 | 关 | 132 FPS | 9 ms | 0 | 35 张 / 1945 ms |
| 异步解原图 | 开 | 131 FPS | 17 ms | 0 | 35 张 / 1891 ms |
同步解原图那三行是复现出来的"糊":单张解码 30–45ms,正好一帧半到六帧没了,最差帧 199ms 意味着手指还在动、画面已经停了五分之一秒。
开不开 perfHint,91 / 94 / 92 三行落在同一个噪声带里,掉帧次数三次都是 23 次,一次不差。
第 5 步:把重活挪出主线程
同一批图、同一个解码量,只把同步 API 换成 Promise:
cxt.resourceManager.getRawFileContent(CARDS[idx].big).then((buf: Uint8Array) => {
  const src: image.ImageSource = image.createImageSource(copy);
  return src.createPixelMap().then((pm: image.PixelMap) => {
    pm.release();
    src.release();
  });
});
均帧回到 132,最差帧 9ms,掉帧 0 次。
这里有一处反直觉,值得单独指出:异步版的累计解码耗时是 1945ms,比同步版的 1043ms 更高。因为 35 张排在别的线程上排队,每张从发起到拿到 PixelMap 的墙钟时间被拉长了。但滑动帧率是满的——总耗时变差、体验变好,这正是"主线程每帧干了什么"和"总共花了多少 CPU"是两件事的意思。
中途差点得出的错误结论
第一轮实验不是这么设计的。当时是另一个写法:400 行列表,每行构建时做一次约 90 万轮位运算,然后先连跑三次不带提示、再连跑三次带提示。
| 组 | 帧数 | 平均间隔 | 卡顿数 |
|---|---|---|---|
| 不带提示 #1/#2/#3 | 97 / 132 / 157 | 17.53 / 12.59 / 10.58 ms | 18 / 11 / 7 |
| 带提示 #1/#2/#3 | 175 / 185 / 194 | 9.77 / 9.15 / 8.85 ms | 5 / 3 / 2 |
卡顿从 18 降到 2,看起来"效果显著"。但第二列自己就在从 97 涨到 157——让曲线下降的变量可能不是提示,是"跑得越来越多"。
改成交错跑(off、on、off、on……)之后:
| 次序 | 组 | 帧数 | 平均间隔 | 卡顿数 |
|---|---|---|---|---|
| 1 | 不带 | 97 | 17.71 ms | 18 |
| 2 | 带 | 135 | 12.50 ms | 11 |
| 3 | 不带 | 162 | 10.51 ms | 7 |
| 4 | 带 | 180 | 9.40 ms | 4 |
| 5 | 不带 | 187 | 8.87 ms | 2 |
| 6 | 带 | 194 | 8.59 ms | 1 |
第 3 次(不带提示,162 帧)比第 2 次(带提示,135 帧)更好。用"第几次跑"预测结果,比用"哪一组"准得多。
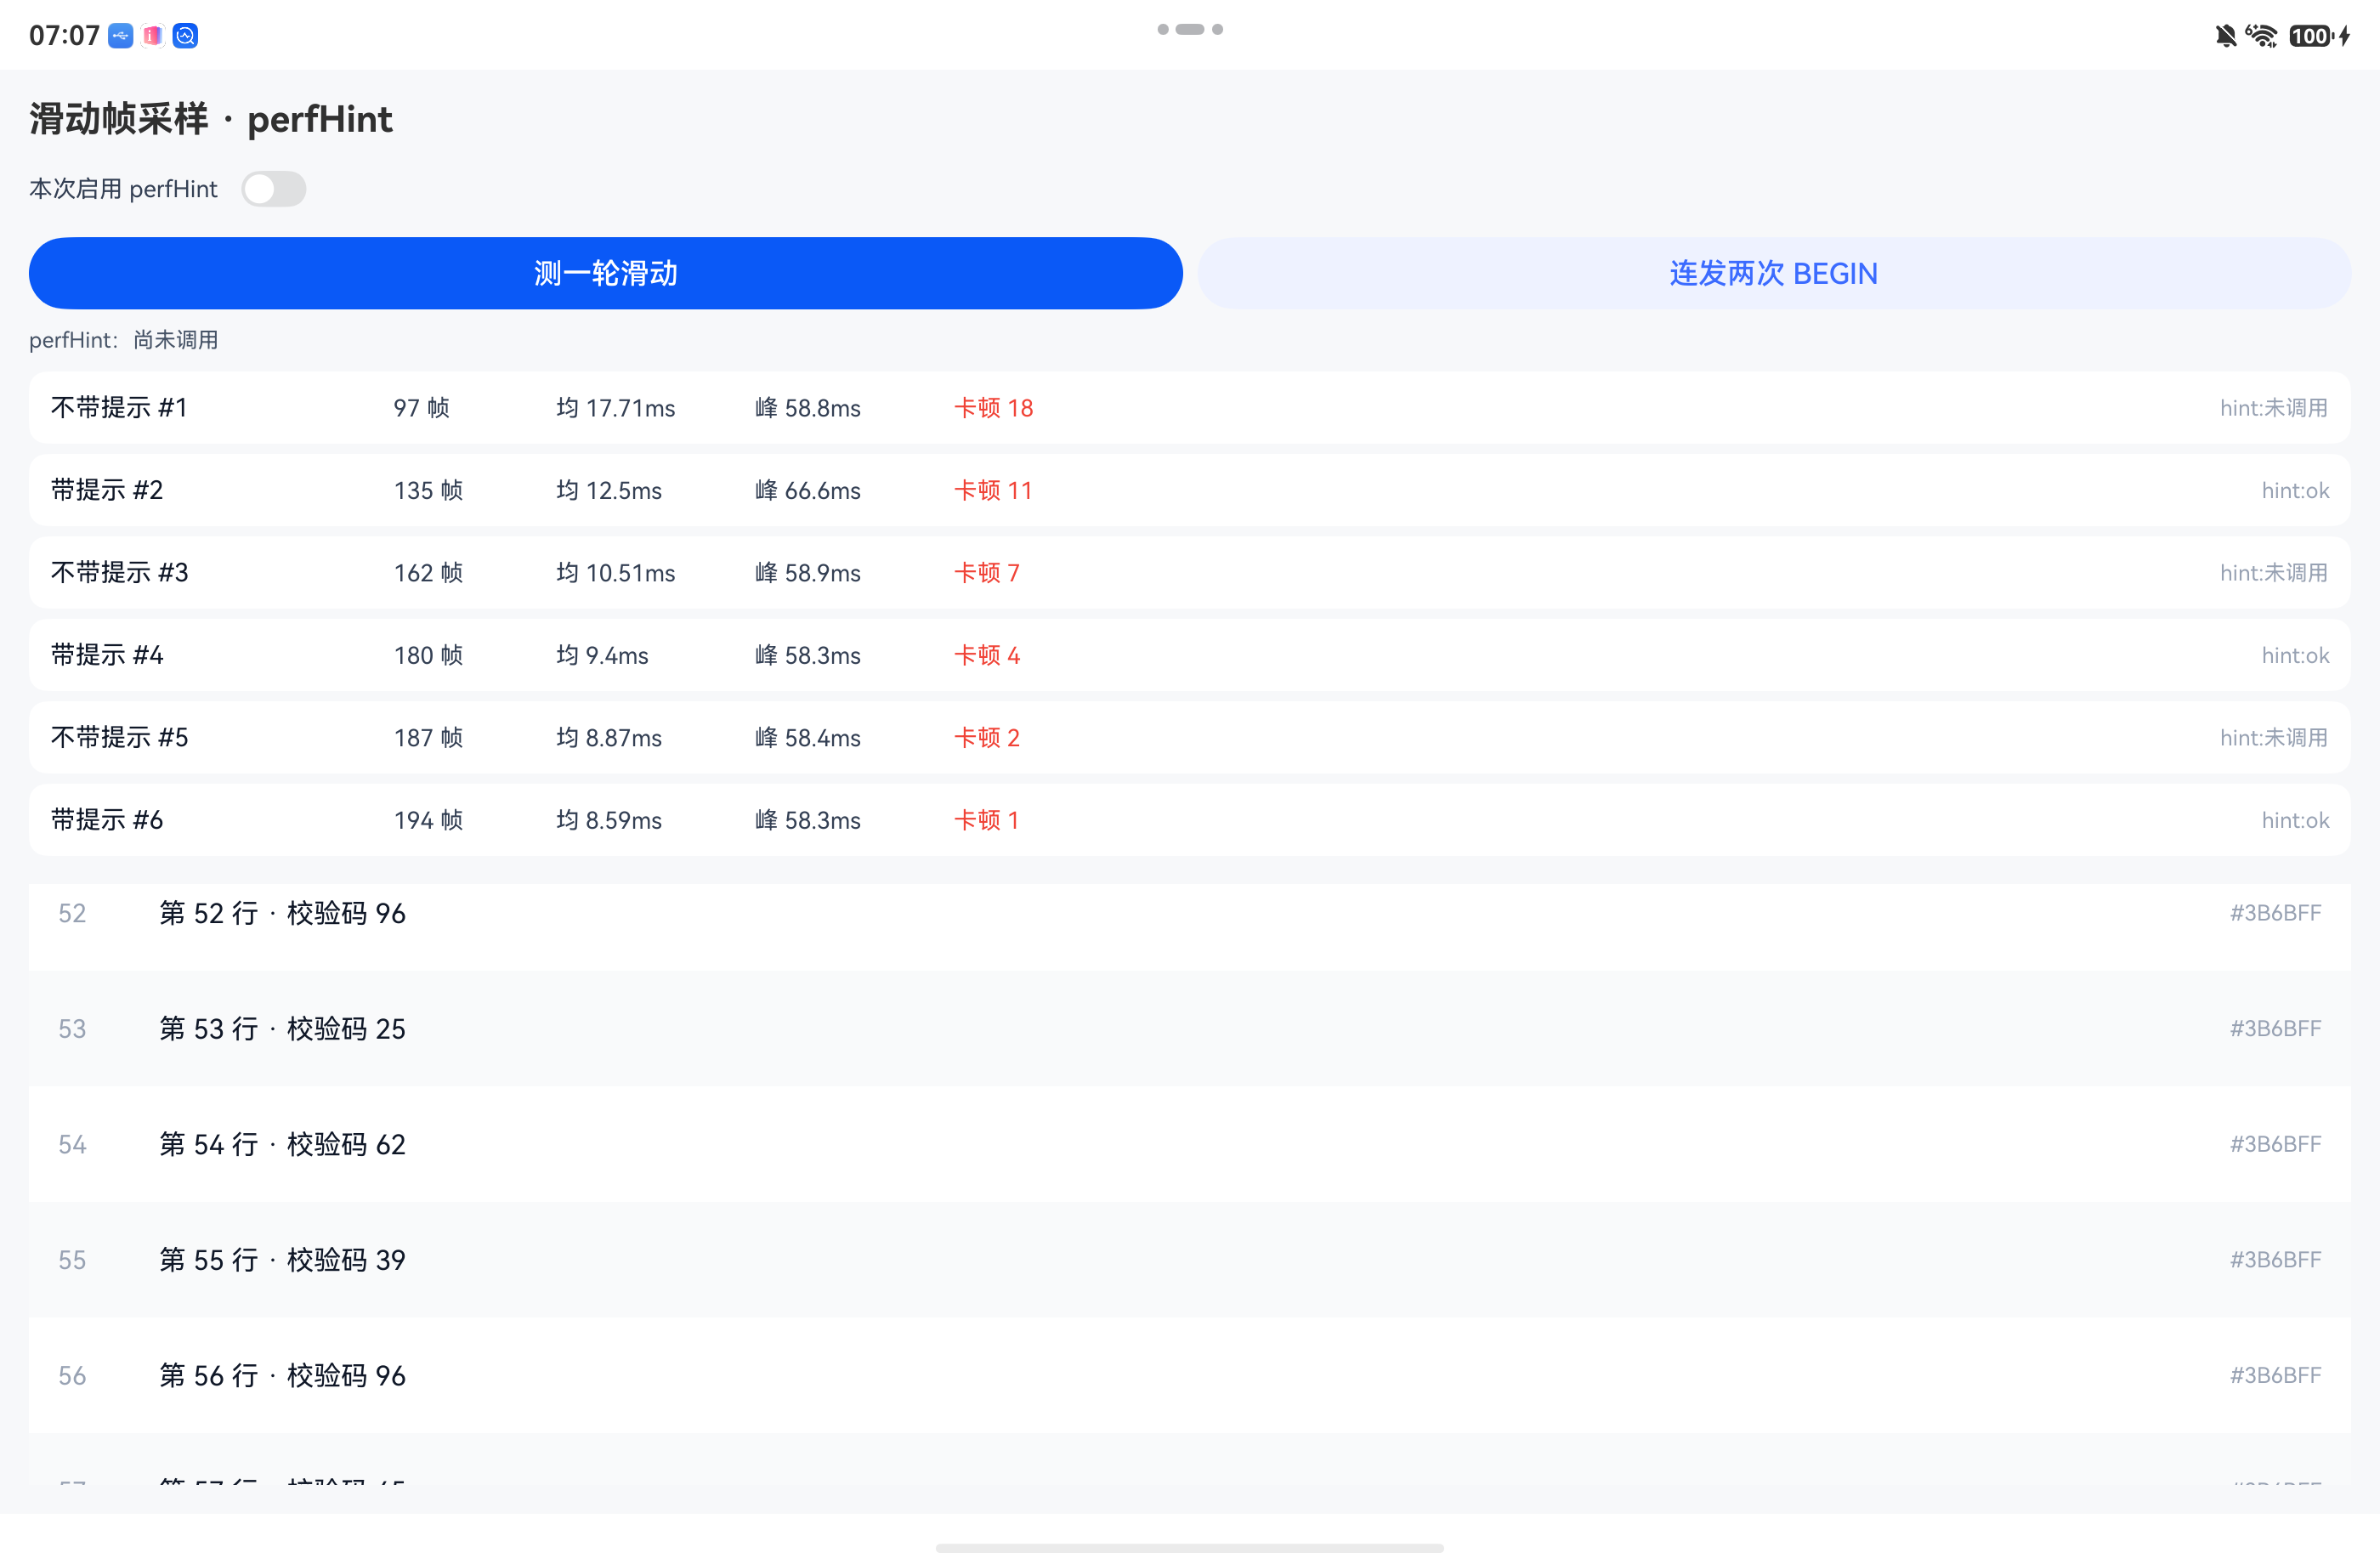
实验一的"效果"是预热:JIT、布局缓存、图片解码缓存这些一次性成本摊薄之后,任何指标都会自己变好。
真机数据
| 项目 | 实测值 |
|---|---|
| 设备 | HUAWEI MatePad Pro(型号 MRDI-W00,序列号略) |
| 系统 | OpenHarmony-7.0.0.105 / API 26 |
| 屏幕 | 2800×1840,hidumper -s RenderService -a screen 显示支持 60 / 120 / 144Hz 三档,空闲时 activeMode 为 60 |
| 滑动时 | 均帧 132 FPS,最差帧 9 ms,掉帧 0 次(不解原图) |
| 同步解码 | 单张 30–45 ms,27 张累计 1043 ms,最差帧 199 ms |
| perfHint 收益 | 91 → 94 FPS,掉帧 23 → 23 次,无收益 |
| 异步解码 | 35 张累计 1945 ms,最差帧 9 ms,掉帧 0 次 |
| BEGIN 连发 | 第二次即 1027700005,END 之后立刻 BEGIN 同样被拒 |
| displaySync 未调 start() | frames=0,无任何报错 |
六条实测结论
一、先确认掉帧存在,再讨论要不要提频。 现象:一个正常写的 48 卡信息流,滑动时 132 FPS、最差帧 9ms、掉帧 0。原因:主线程每帧只做布局和一次 scrollBy,本来就够快。对策:任何"卡顿优化"之前,先把帧间隔打印出来,别拿体感当依据。
二、perfHint 救不了主线程被占住的情况。 现象:同一份同步解码负载,开关前后 91 / 94 / 92 FPS,掉帧次数三次都是 23。原因:提频能改变的是资源分配优先级,解码那 40ms 是主线程上一件串行做完的事,频率再高也得占着这一帧。对策:先定位并拆掉主线程的活,再考虑提示。
三、同步改异步的收益是量级上的。 现象:132 FPS / 0 掉帧,且代码只改了四行。原因:解码被挪到框架的工作线程,主线程每帧只剩布局。对策:getRawFileContentSync + createPixelMapSync 这一对同步 API 不要出现在任何滚动路径上。
四、累计耗时和体验可以反向。 现象:异步版总耗时 1945ms,比同步版 1043ms 高 86%,帧率却从 91 涨到 132。原因:并行排队拉长了单张的墙钟时间,但把它从关键路径上摘了下来。对策:评估优化时同时看"总开销"和"每帧开销",只看一个会得出反的结论。
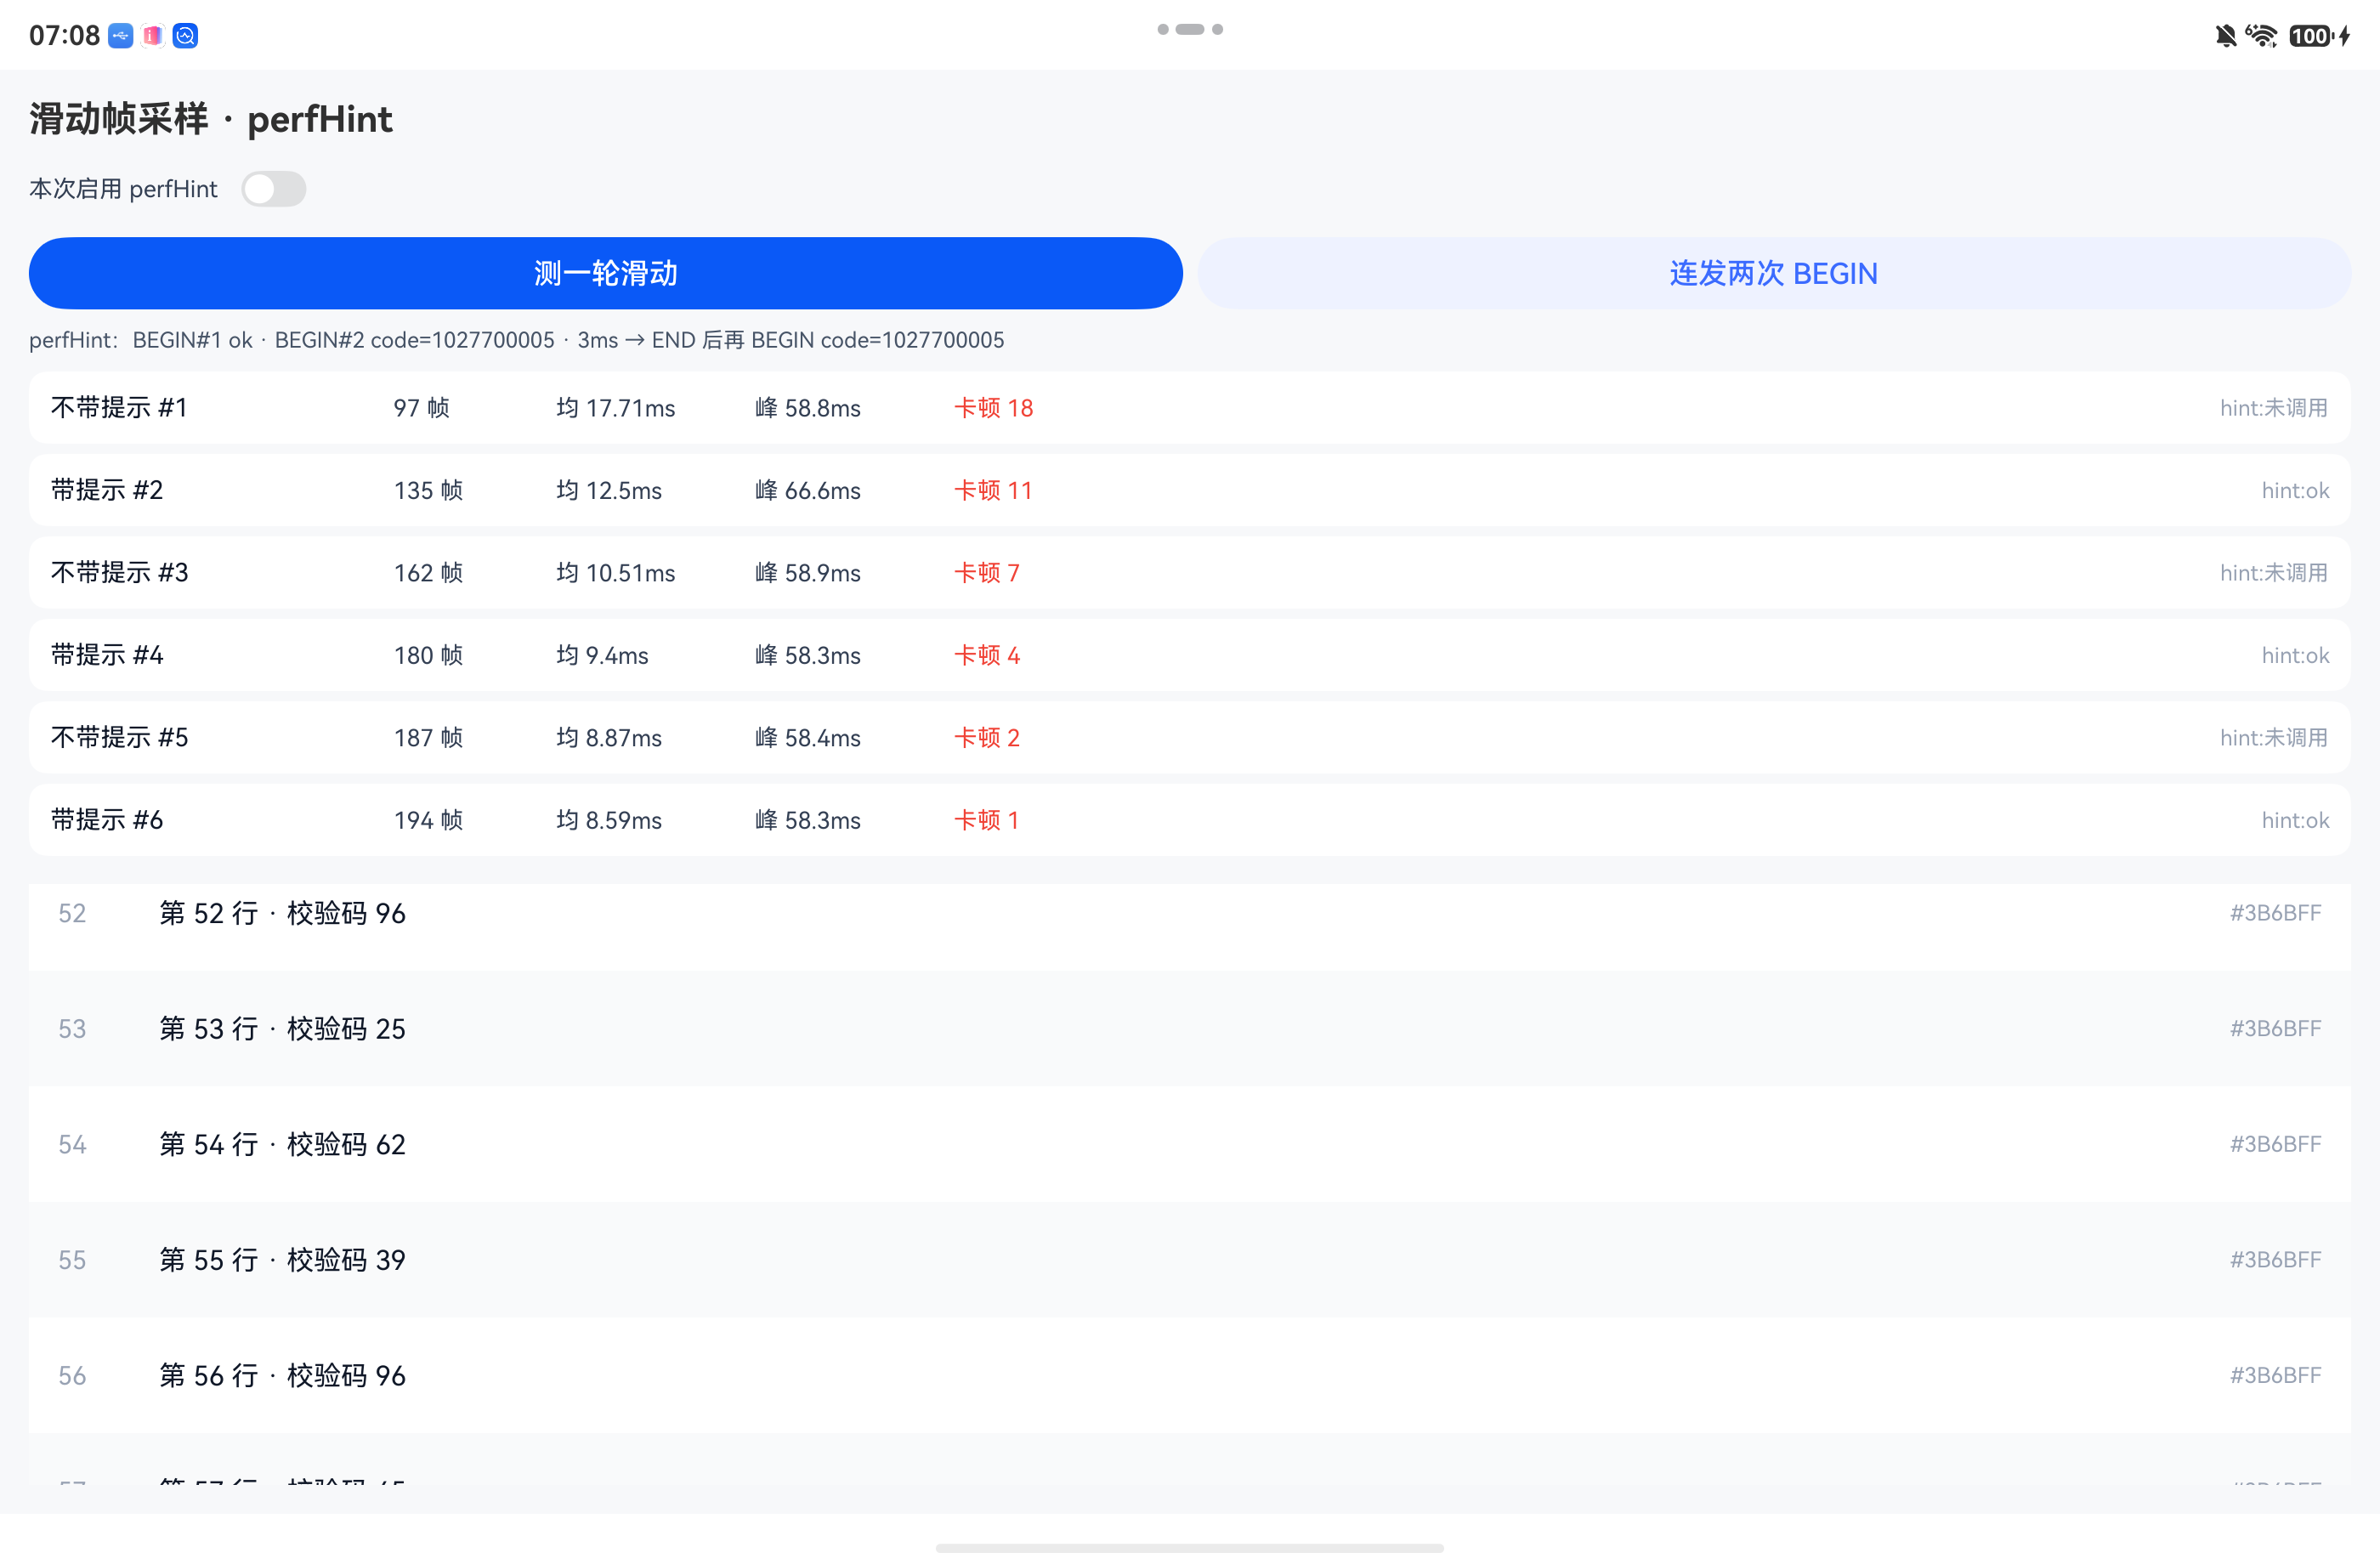
五、BEGIN 的间隔是从 BEGIN 起算的,END 不解锁。 现象:BEGIN#1 ok · BEGIN#2 code=1027700005 · 中间发过 END,再 BEGIN 仍是 1027700005。原因:最小间隔按档位(SHORT >3s、MEDIUM >30s)从上一次 BEGIN 计时。对策:高频触发点(比如每次 onScrollIndex)不适合直接调 perfHint,要么降频,要么选对档位并真的等够。
六、displaySync 不调 start() 是静默失败。 现象:回调一次都不进,frames=0,不报错不抛异常。原因:on('frame') 只是注册消费者,start() 才真正订阅 vsync。对策:帧统计代码写完,第一件事是确认空跑也能拿到非零帧数。
顺带记一个 ArkUI 坑:统计表格用 ForEach(this.stats, ..., (s: Stat) => s.name),而 name 只有"带提示/不带提示"两种值,结果六次实验只显示两行。key 重复时后面的项不会新增。改成 (s, idx) => ${s.name}-${idx}`` 就正常了。跟性能无关,但足以让人误判一整轮实验。
总结
这篇测的接口,结论是"在我们造出来的那个掉帧场景里,它没有可测量的收益"。如果一定要说什么时候值得接:应用启动、页面切换、首屏绘制这类有明确起点和终点、且瓶颈确实在调度而不在你自己代码里的过程,可以试,试之前先按第 1 步把帧率挂到页面上。
不适合的位置很明确——把它当"滑动优化开关"往滚动回调里塞。一是主线程被自己的活占住时提频无效,二是 onScrollIndex 这种频率根本过不了 BEGIN 的最小间隔,只会拿到一串 1027700005。
给产品的那句回复是:首页不糊,糊的是新卡片进屏时在主线程解原图,这个已经改掉了;perfHint 这次没加。
💡 一句话:perfHint 是"提前借资源",不是"把活变少"——主线程上那几十毫秒,只有你自己能还。
参考文献
- 使用 perfHint 系统性能优化(ArkTS):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/fast-scheduling-optimization_arkts
- schedulingOptimization(系统性能优化)API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/fast-kit-scheduling-optimization
- FAST Kit 简介:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/fast-introduction
- FAST Kit 目录:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/fast-kit-guide