前言
需求听起来特别自然:打开冰箱拍一张,App 告诉你"香蕉剩两根、鸡蛋还有六个、牛奶喝完了"。
听起来就是一个目标检测嘛。鸿蒙有现成的端侧能力:多目标识别(objectDetection),归属 @kit.CoreVisionKit,不联网、不要权限。我们兴冲冲接上,跑了一张冰箱照片。
结果是这样:
分类汇总:文本×12 食物×2 植物×2十六个目标里,十二个是"文本"——冰箱里的价签、牛奶盒上的字、酱料瓶的标签。真正跟"食材"有关的只有四个框,而且其中两个是同一颗西兰花,一个被标成"食物"、一个被标成"植物"。
至于香蕉、鸡蛋、牛奶分别在哪?它一个都没说。
这篇就讲这件事:objectDetection 到底能干什么、我们怎么验证的、以及当你发现它不够用时该往哪走。
先认识这个能力给了什么
接口
import { objectDetection, visionBase } from '@kit.CoreVisionKit';

const detector = await objectDetection.ObjectDetector.create();
const response = await detector.process({ inputData: { pixelMap: pm } });
const objects: objectDetection.VisionObject[] = await response.objects;
await detector.destroy();
结构和图像超分是同一套 visionBase.Analyzer 家族:create() / process() / destroy()。所以你已经知道的规律都适用——create() 别放点击回调、process() 要串行、新 API 具名导入在旧设备会直接崩。
返回的每个对象长这样
interface VisionObject {
  boundingBox: visionBase.BoundingBox;   // { left, top, width, height }
  score: number;                         // (0,1)
  labels: Array<number>;                 // 数字标签
  id: number;                            // 从 0 递增
}
- 目标检测(Object Detection):在图中定位并识别多个目标,输出类别与边框。
- 置信度 score:模型对该检测结果的确信程度,取值 (0,1)。
- 端侧推理:识别在设备本地完成,图片不外传。
这里有个新手一定会卡住的地方:labels 是数字数组,d.ts 里没有任何说明。 你在类型定义文件里翻不到 7 是什么、11 是什么。
词表藏在 API 参考文档里,不在代码里。完整的一共 15 个:
| 编号 | 含义 | 编号 | 含义 |
|---|---|---|---|
| 0 | 风景 | 10 | 狗头 |
| 1 | 动物 | 11 | 食物 |
| 2 | 植物 | 12 | 汽车 |
| 3 | 建筑 | 13 | 人体 |
| 5 | 人脸 | 21 | 文档 |
| 6 | 表格 | 22 | 卡证 |
| 7 | 文本 | ||
| 8 | 人头 | ||
| 9 | 猫头 |
请注意两件事:
- 只有 15 类。 编号 4、14~20 是空缺的,不是漏抄。
- 没有"香蕉""鸡蛋""牛奶"这一层。 它给的是"食物"这个大类。
所以"冰箱清点"这个需求,从能力定义上就不在这个 API 的射程里。我们能拿到的最细粒度就是"这里有个食物"。
那它适合做什么
看完词表反而清楚了。它的 15 类里有几类是很好用的版面/内容分类器,而不是物体检测器:
| 类别 | 实用场景 |
|---|---|
| 文本(7)、文档(21)、卡证(22)、表格(6) | 拍照自动分类:扫描件、身份证、报销单据、表格打印页——文档管理 App 的核心诉求 |
| 人脸(5)、人头(8)、人体(13) | 隐私打码的粗筛,比逐帧跑人脸检测便宜 |
| 猫头(9)、狗头(10) | 宠物相册自动归类,单独给了宠物类,比笼统的"动物"实用 |
| 风景(0)、建筑(3) | 相册按拍摄主题分册 |
换句话说:把它当"15 类图片内容粗分器"用是对的,当"通用物体识别器"用是错的。
我们是怎么验证的
第一步:把标签词表写进代码
既然 d.ts 里没有,就自己维护一份,并且一定要留未知分支,因为编号可能随模型版本扩充:
export const LABELS: Map<number, string> = new Map<number, string>([
  [0, '风景'], [1, '动物'], [2, '植物'], [3, '建筑'], [5, '人脸'], [6, '表格'], [7, '文本'],
  [8, '人头'], [9, '猫头'], [10, '狗头'], [11, '食物'], [12, '汽车'], [13, '人体'],
  [21, '文档'], [22, '卡证']
]);

labelName: LABELS.get(lid) || `未知(${lid})`第二步:一定要自己加置信度过滤
接口没有提供阈值参数,process() 把所有检出的框都吐给你。实测一张图返回 18 个,其中大量是 24×5 像素的小框——这种基本可以确定是纹理误检。
const items: Detected[] = [];
for (let i = 0; i < res.objects.length; i++) {
  const o: objectDetection.VisionObject = res.objects[i];
  if (o.score < minScore) {
    continue;                       // 阈值自己定
  }
  // ...
}
我们最后用了两道过滤,缺一不可:
const bigEnough: boolean = o.boundingBox.width >= imgW * 0.05
  && o.boundingBox.height >= imgH * 0.05;
只按 score 过滤会留下一堆高置信度的小框;只按尺寸过滤会留下低置信度的大框。
第三步:把 labels 数组当成"可能多个"来处理
实测每个对象 labels 长度都是 1(日志里是 rawLabels=[7] 这样)。但类型是数组,就意味着同一区域可能给多个标签——事实上真的发生了,见下一节。所以别写死 labels[0],至少留个兜底:
const lid: number = o.labels.length > 0 ? o.labels[0] : -1;真机数据
测试机:HUAWEI MatePad Pro(MRDI-W00),HarmonyOS 7.0.0.107,API 26。
输入是一张 720×540 的冰箱内部照片,画面里有鸡蛋、香蕉、番茄、牛奶、酸奶、西兰花、酱料瓶、几个保鲜盒。
阈值 0.30 时的结果:
total=18 kept=16 cost=679ms
分类汇总:文本×12  食物×2  植物×2
明细里几个关键项:
| id | label | 置信度 | 框 | 我们的解读 |
|---|---|---|---|---|
| 0 | 7 文本 | 76.1% | 651,138 56×14 | 包装上的印刷字,误检成目标 |
| 4 | 11 食物 | 48.3% | 83,301 197×159 | 西兰花 |
| 8 | 2 植物 | 44.2% | 83,301 197×159 | 同一个框,另一个标签 |
| 11 | 11 食物 | 41.4% | 243,55 354×184 | 上层那排东西 |
| 6 | 7 文本 | 46.8% | 653,221 24×5 | 24×5 像素的噪声框 |
界面结果:
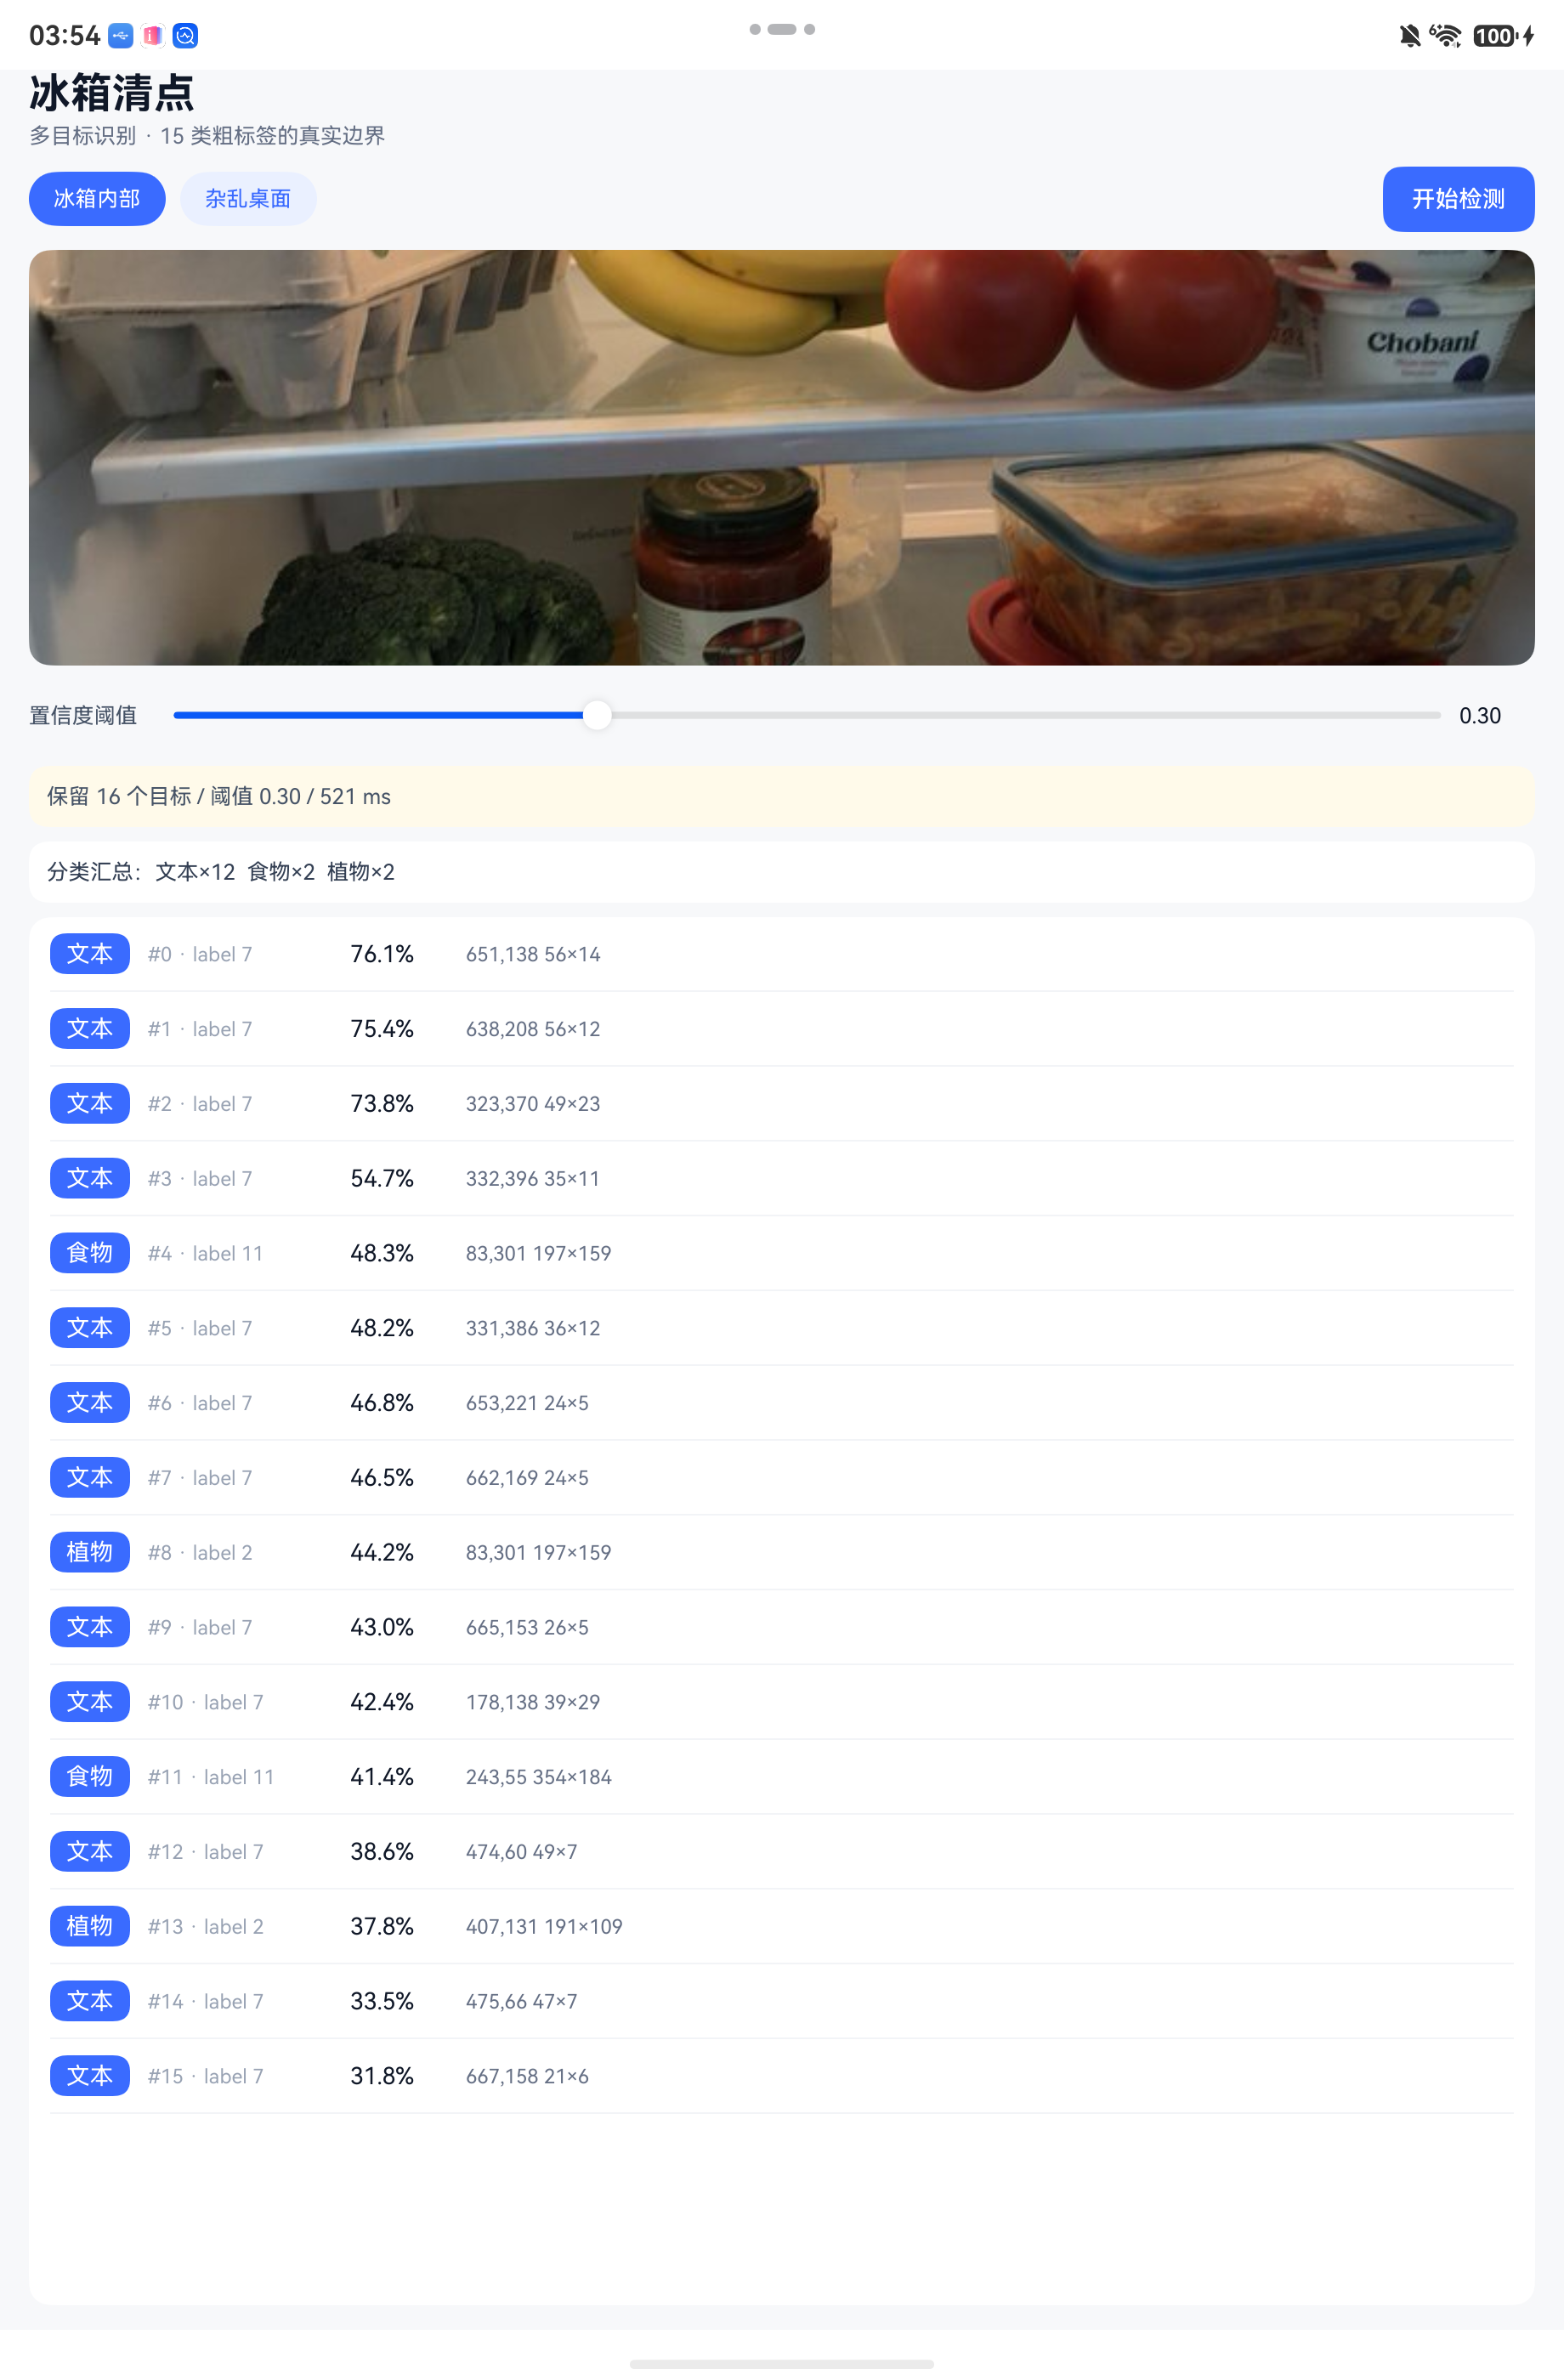
逐条明细(标签、置信度、框坐标):
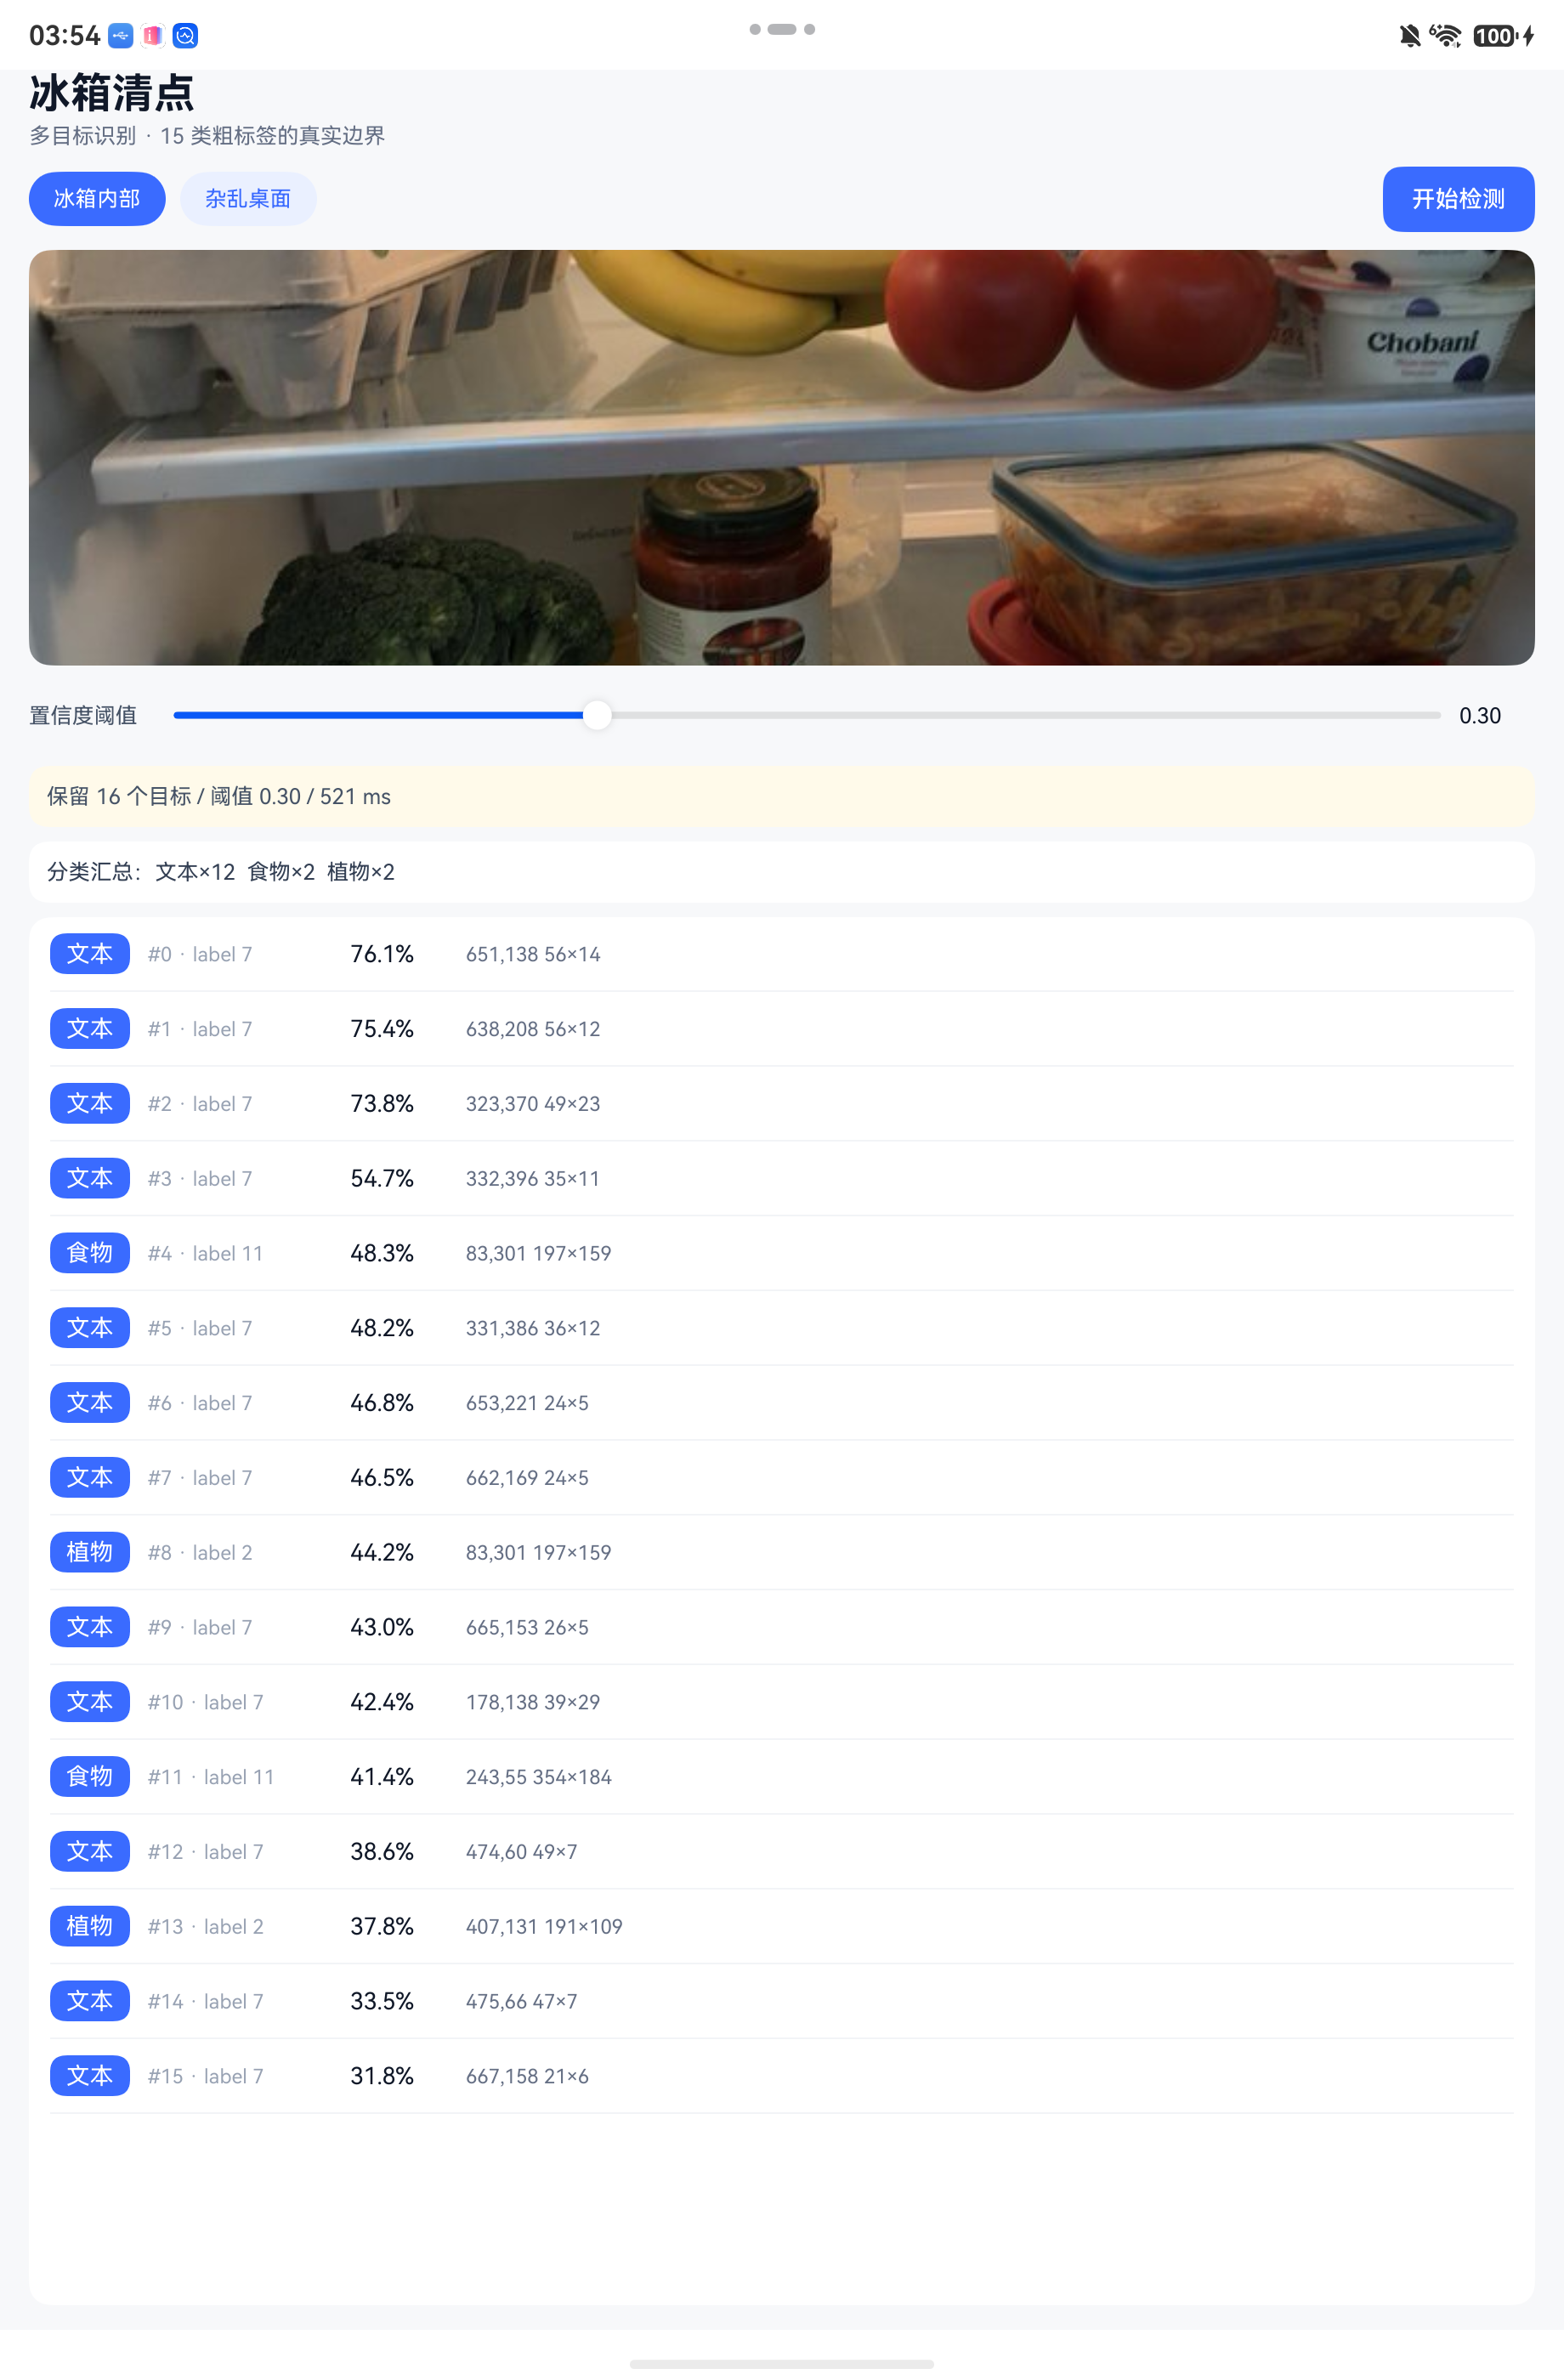
这次实验教给我们的四件事
第一件:15 类是硬上限,别指望细粒度识别。
"还剩几根香蕉"这种需求,objectDetection 做不到。要么接受只到"食物"这一层,要么换方案(见下一节)。
第二件:同一区域会被打多个标签,统计前先按框去重。
西兰花同时是"食物"和"植物",两个对象 id 不同但 boundingBox 完全一致(83,301,197×159)。如果你按对象数统计"图里有几个东西",会重复计数。
去重的做法是按框的重叠度合并:
function sameBox(a: Detected, b: Detected): boolean {
  return a.left === b.left && a.top === b.top
    && a.width === b.width && a.height === b.height;
}
完全相同只是最省事的一种;真实场景要算 IoU。
第三件:误检主要来自"像字的纹理",必须双重过滤。
12/16 是"文本",绝大多数是几十像素宽的条状框。这是因为冰箱里确实到处是标签和印刷字——模型没错,是我们的需求假设错了:"食品包装上的字"也是文本。
阈值 0.30 时留下 16 个,提到 0.50 只剩 4 个。所以阈值不是越高越好,越高越容易把真正的目标(食物最高才 48.3%)也砍掉。
这个 48.3% 值得记住:在这类"物体不是画面主体"的场景里,正确目标的置信度天然偏低,用通用阈值 0.6 会直接漏检。
第四件:耗时可以接受,但别在预览帧上跑。
单次 679 ms(首次)/ 521 ms(热态)。做"拍一张分析一次"完全够用,做实时预览则每秒只能跑一两次,需要降分辨率。
那我们到底该怎么实现冰箱清点
三条路,按投入排序:
| 路线 | 做法 | 代价 | 适用 |
|---|---|---|---|
| 一、换需求 | 把"识别每样食材"改成"有没有食物、有几处食物",用于"该补货了"这类粗提醒 | 几乎为零 | 能接受粗粒度 |
| 二、串联文搜图 | 给常备食材建参考图库并索引进 textSearchImage,对检测到的"食物"框逐个裁剪检索 |
每框一次检索,十几个框要几秒 | 需要"这是香蕉"级别 |
| 三、自己接模型 | 引入真正的细粒度分类器 | 工作量最大 | 效果要求高 |
我们最后选了路线二。因为对"还剩什么"这个用户问题,"按相似度匹配参考图"给出的答案已经足够好,而且用户能自己往参考库里加新食材。
总结
什么场景值得用它:把图片按内容粗分——文本 / 文档 / 卡证 / 表格做拍照归档,猫头狗头做宠物相册,人脸人头做打码粗筛。
不适合:细粒度的"这是什么东西"。15 类是硬上限,香蕉、鸡蛋、牛奶都不在那张表里。
💡 一句话:当 15 类内容粗分器用是对的,当通用物体识别器用是错的——要细粒度就串文搜图。
参考文献
- Core Vision Kit 开发指南 · 多目标识别:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-object-detection
- Core Vision Kit API 参考 · objectDetection(多目标识别):https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-object-detection-api
- Core Vision Kit 开发指南 · 通过文本搜索图片(细粒度串联方案):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-text-search-image