前言
需求是我家老人提出来的,不是产品经理。她把平板递过来说"帮我找找宝宝在海边的照片",我打开相册的搜索框,输入"宝宝 海边",结果是空的。
这件事让我意识到:相册搜索对不会打字、不会组织关键词的人来说,是个负功能。他们脑子里是一句话,搜索框要的是一个词。
鸿蒙 7 的 Core Vision Kit 里有个端侧能力叫文搜图(textSearchImage),拿自然语言去检索本地图片。我们把它接到一个九张照片的小相册上,做了 15 条查询的命中率实验。结论很反直觉:在这个能力上,"教用户输入关键词"是错的产品设计。
实验怎么设的
相册 9 张图:3 张宝宝(海边玩沙、客厅沙发看书、公园草地跑)+ 6 张旅行照(海、雪、沙漠、森林、城市、古镇)当干扰项。全部用 insertImage(path, 'family') 建到同一个 scope。
15 条查询分四组,每条的期望结果在跑之前就先写死,避免事后找解释:
| 组 | 查询 | 期望命中的图 |
|---|---|---|
| 主体词 | 宝宝 / 孩子 / 小孩 / 娃 | 任一 kid_* |
| 场景词 | 沙发 / 客厅 / 海滩 / 沙子 / 草地 / 公园 | 对应那一张 |
| 口语整句 | 宝宝在沙发上看书 / 孩子在草地上跑 / 把宝宝在海边的照片给我看看 | 对应那一张 |
| 干扰词 | 雪山 / 沙漠 | 对应旅行照 |
判定标准:返回结果的第一位是不是期望的那张图。
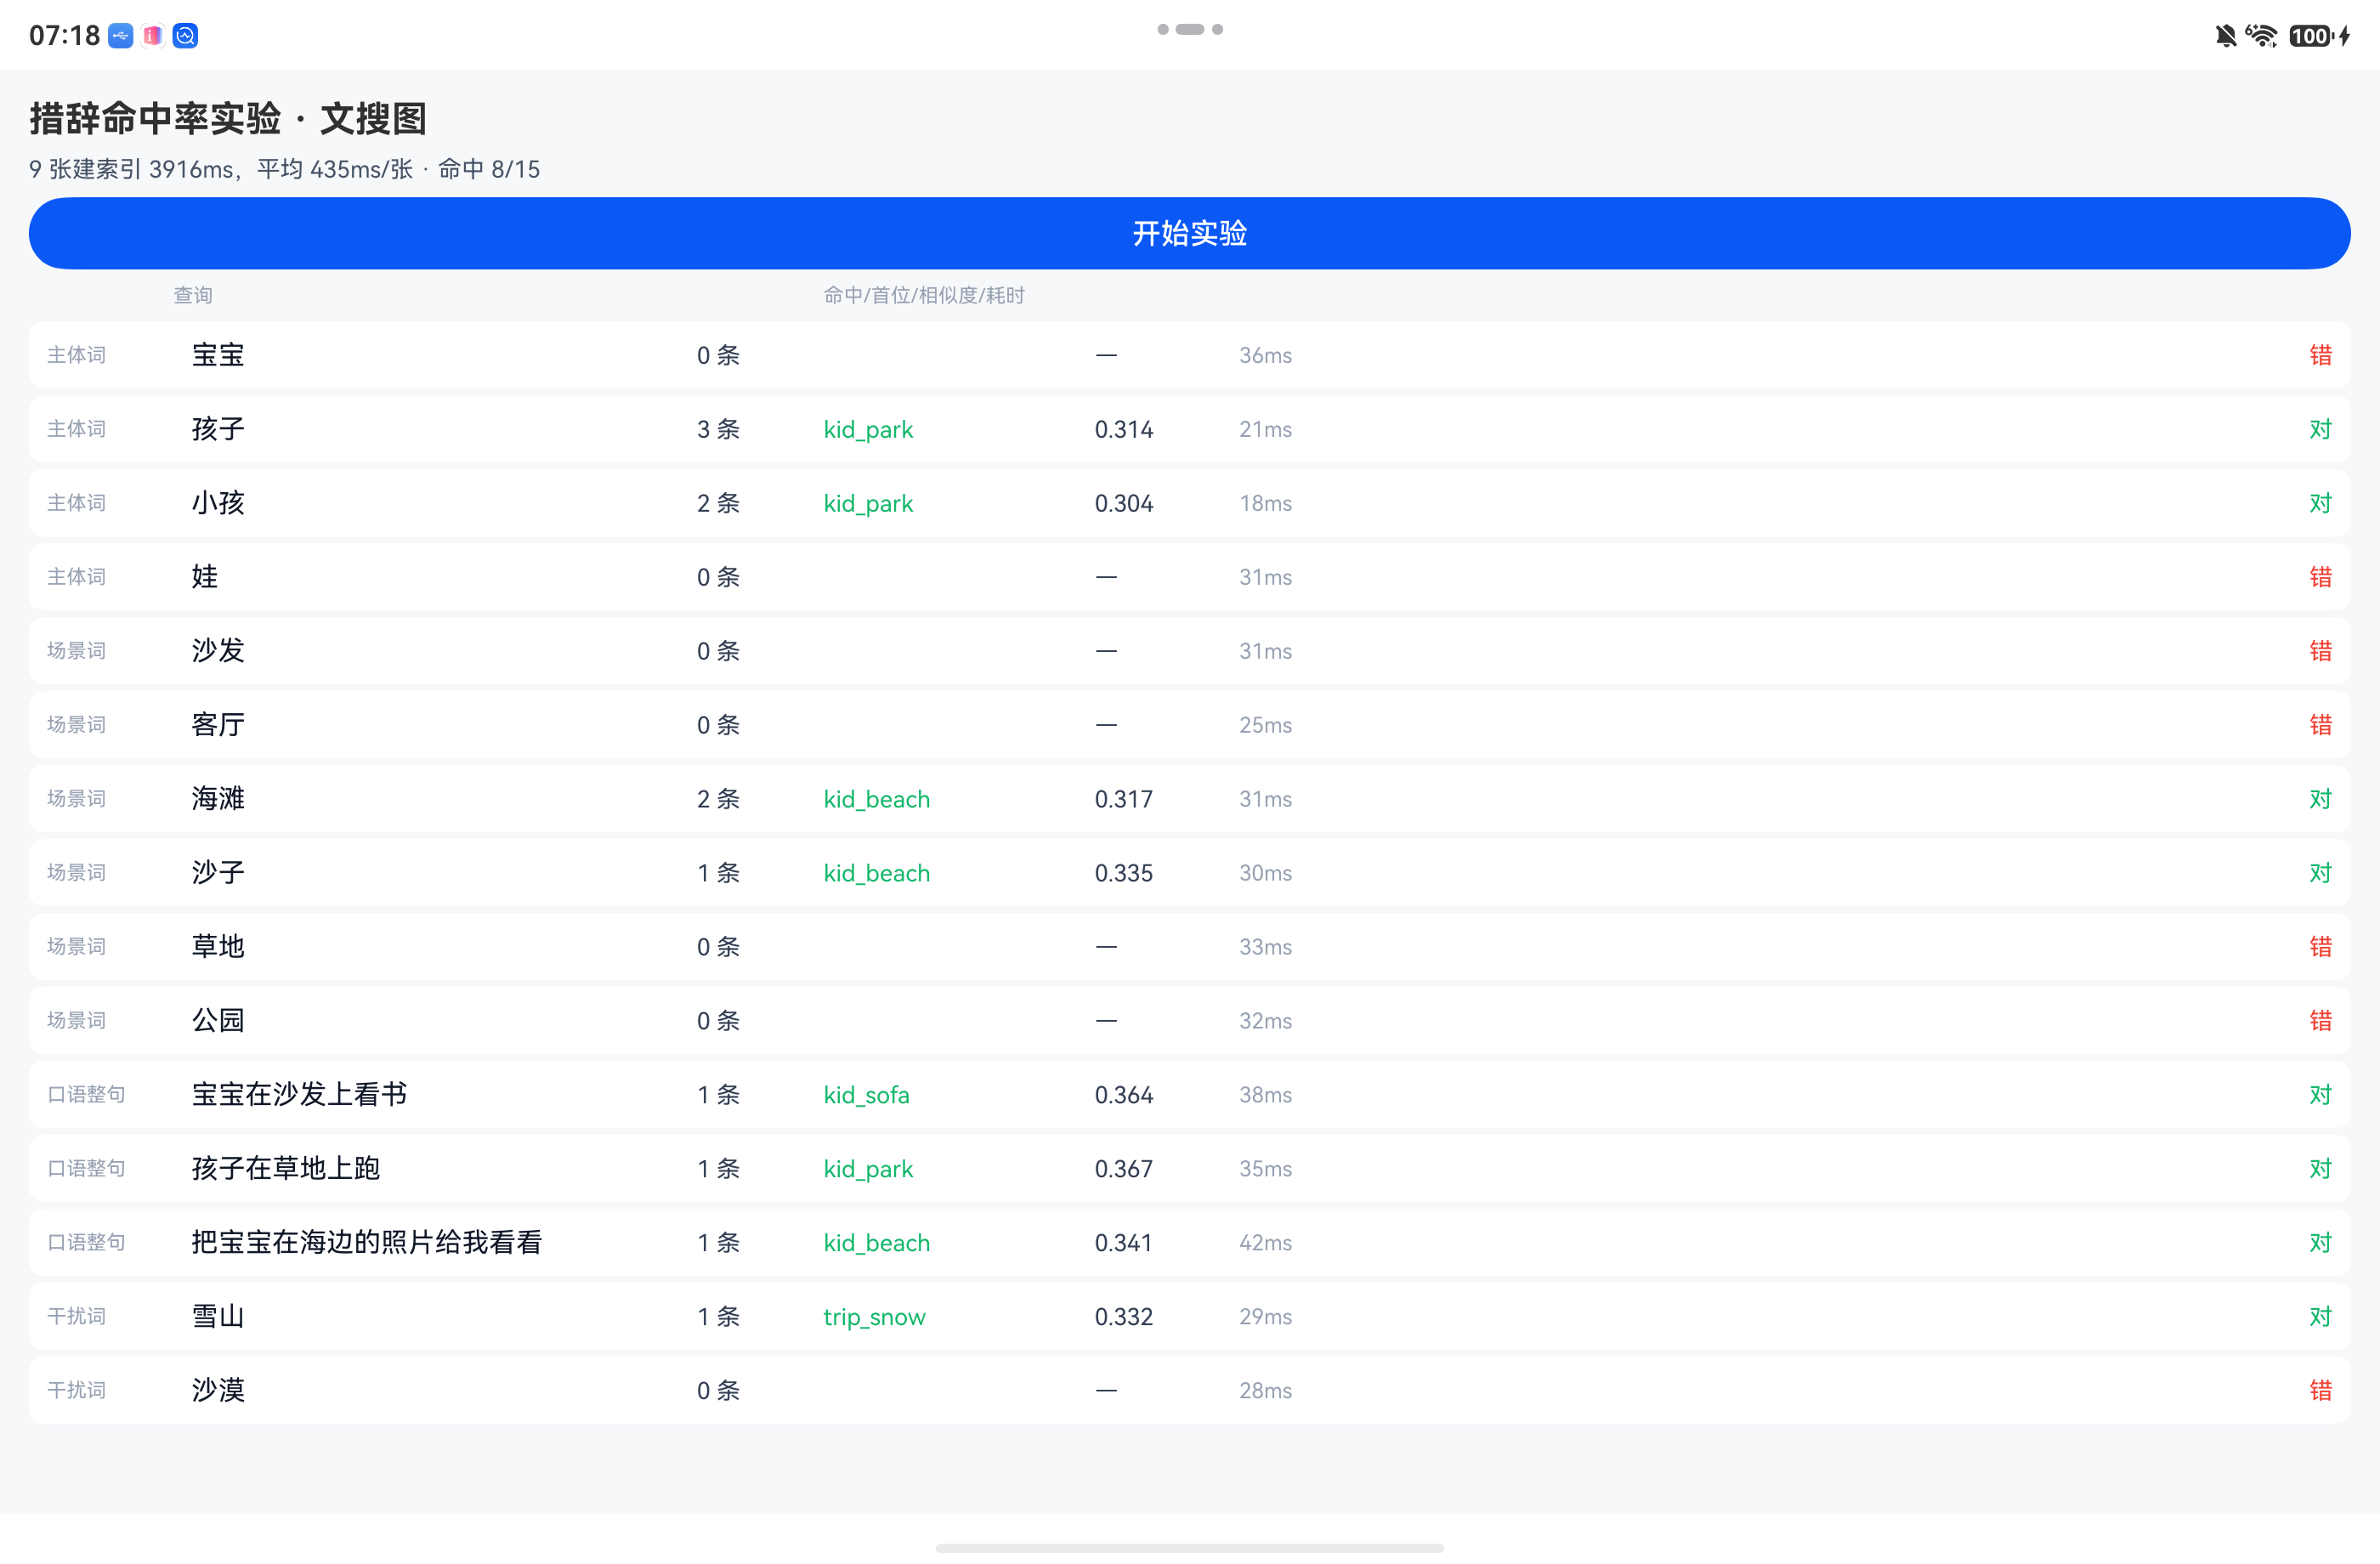
结果:8/15
| 组 | 查询 | 命中数 | 首位 | 相似度 | 耗时 |
|---|---|---|---|---|---|
| 主体词 | 宝宝 | 0 | — | — | 36ms |
| 主体词 | 孩子 | 3 | kid_park | 0.314 | 21ms |
| 主体词 | 小孩 | 2 | kid_park | 0.304 | 18ms |
| 主体词 | 娃 | 0 | — | — | 31ms |
| 场景词 | 沙发 | 0 | — | — | 31ms |
| 场景词 | 客厅 | 0 | — | — | 25ms |
| 场景词 | 海滩 | 2 | kid_beach | 0.317 | 31ms |
| 场景词 | 沙子 | 1 | kid_beach | 0.335 | 30ms |
| 场景词 | 草地 | 0 | — | — | 33ms |
| 场景词 | 公园 | 0 | — | — | 32ms |
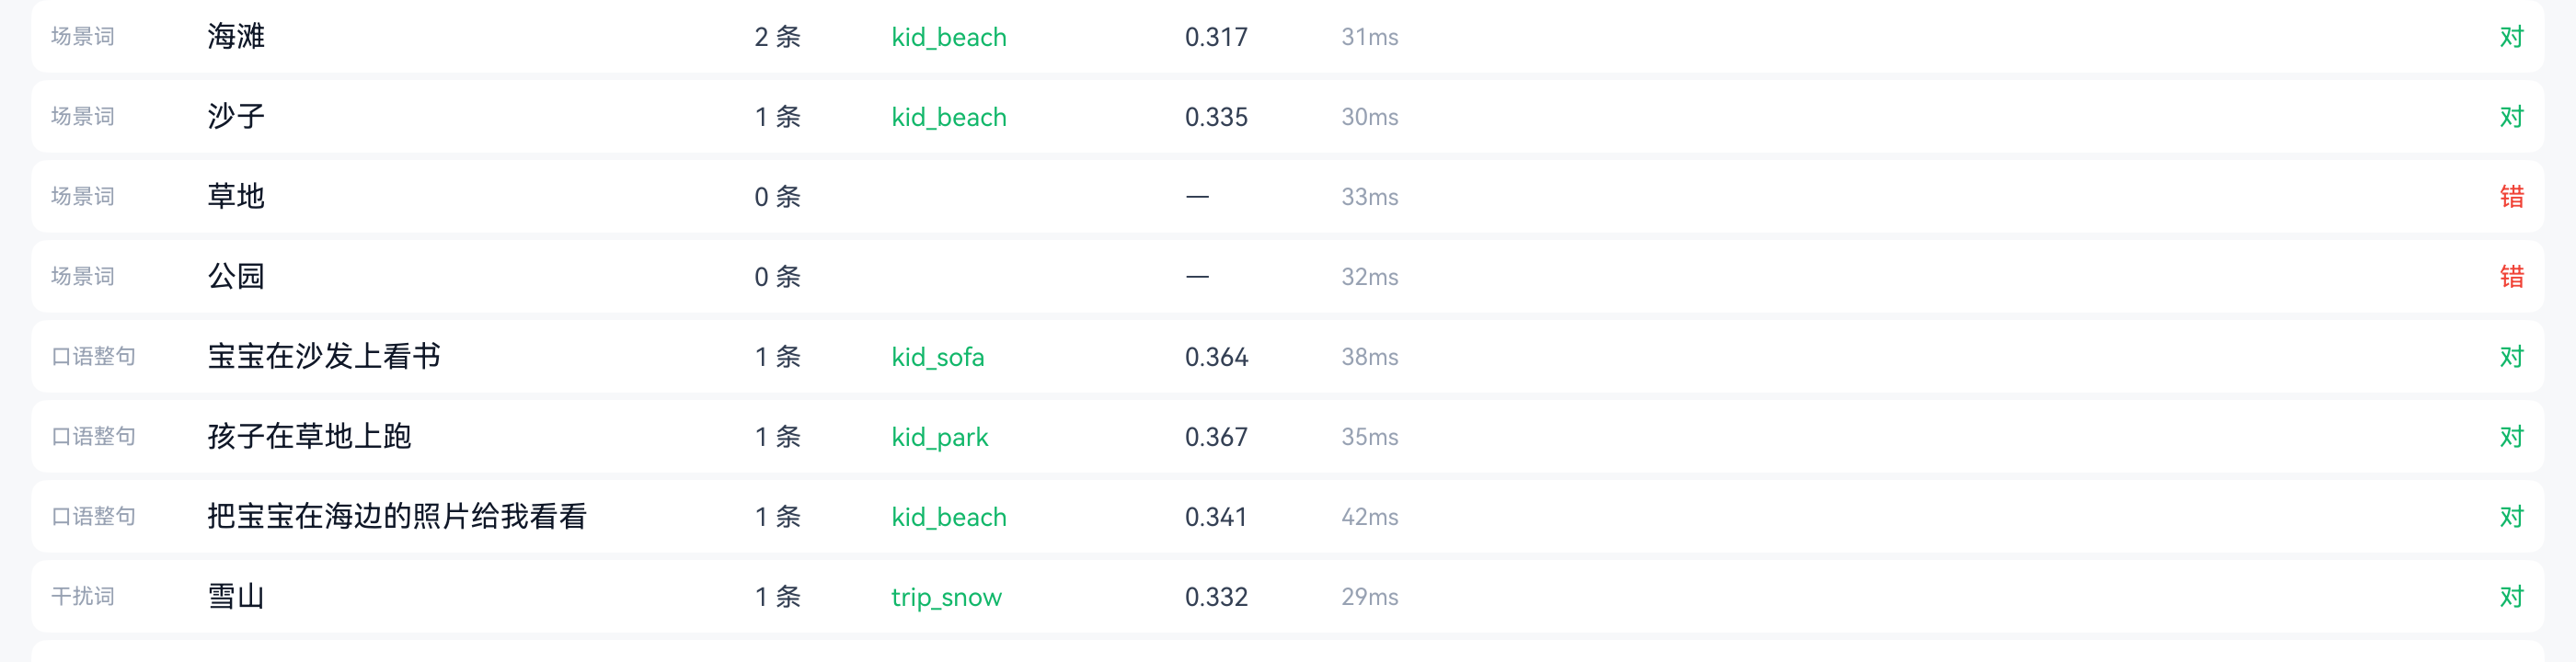
| 整句 | 宝宝在沙发上看书 | 1 | kid_sofa | 0.364 | 38ms |
| 整句 | 孩子在草地上跑 | 1 | kid_park | 0.367 | 35ms |
| 整句 | 把宝宝在海边的照片给我看看 | 1 | kid_beach | 0.341 | 42ms |
| 干扰 | 雪山 | 1 | trip_snow | 0.332 | 29ms |
| 干扰 | 沙漠 | 0 | — | — | 28ms |
九张图建索引 3916ms,平均 435ms/张;单条查询 18~42ms。
结论一:单词会失败,整句能救回来
最关键的一组对比:
"沙发"            → 0 条
"宝宝在沙发上看书" → 命中 kid_sofa

"草地"            → 0 条
"孩子在草地上跑" → 命中 kid_park同一个场景、同一张图,把词换成句子就有了。这说明它不是关键词匹配,而是把整句编码成一个语义向量去比对——信息量不够的时候,一个孤立的词反而落不到任何一张图上。
对产品的影响非常直接:搜索框的占位文案不能写"输入关键词",那是在教用户用一种会失败的方式输入。应该写"描述一下这张照片",并且给一两个整句例子。
结论二:别做同义词表
"宝宝" 0 命中,"孩子""小孩" 有结果,"娃" 0 命中。第一反应是加同义词改写:宝宝 → 孩子。
但看结论一就知道这没用——问题不在词的选择,在于输入只有一个词。把"宝宝"改写成"孩子",还是单词,大概率还是空。
真正该做的是把句子补全。我们试的三条整句全部命中,包括"把宝宝在海边的照片给我看看"这种带一堆废话("把""给我看看")的口语。也就是说这个能力对口语噪声是耐受的,用户不需要说"规范的话"。
所以产品上应该推的是输入引导,不是查询改写。
结论三:相似度绝对值不能用
所有命中结果的相似度都落在 0.304 ~ 0.367 之间。注意两件事:
- 命中的结果,相似度也才 0.3 出头。如果按直觉设一个"低于 0.5 不展示"的置信度门槛,这个相册会一条结果都不剩。
- 整句的相似度(0.341~0.367)系统性地高于单词(0.304~0.335),和命中率的方向一致。这个差值可以拿来做排序参考,但不能拿来当绝对阈值。
结论:similarity 只能当相对量用(排序、分组、"更多类似照片"),不能当质量分用。要判断"没找到",唯一可靠的信号是返回数组长度为 0。
适老化界面上会怎么改
按这三条结论,界面要动的地方其实不少:
- 输入方式:语音优先。老人说一句比打字快得多,而且天然就是整句。
- 占位与示例:把"搜索照片"改成"说说那张照片里有什么",下面挂两个示例整句。
- 空结果页:不要只显示"没有找到"。给一句可执行的引导——"试试说完整一点,比如'宝宝在沙发上看书'"。这一条能直接决定用户是再试一次还是关掉应用。
- 结果呈现:大缩略图、单列,别搞九宫格。他们要的是"是不是这张",不是"扫一眼有多少张"。
- 索引时机:435ms/张意味着可以在充电待机时批量建,也可以拍一张建一张。查询 30ms 级,用户完全无感,不需要做"搜索中"的加载态。
没测的部分
三件事这轮没有数据,不下结论:
- 照片量上去之后的召回变化。9 张是玩具规模,几千张时"0 命中"的比例会不会更高,不知道。
- 方言与语音识别错误。我们输入的是标准普通话整句,真实场景里语音转写本身会带错字。
- 关系词。"我孙子""姥姥家那只狗"这类需要外部知识才能落到图上的查询,一条都没测。
真机数据
| 项目 | 实测值 |
|---|---|
| 设备 | MatePad Pro(HarmonyOS 7 / API 26,序列号略) |
| 建索引 | 9 张 3916ms,平均 435ms/张 |
| 单次查询 | 18 ~ 42ms |
| 查询命中率 | 8/15(整句 3/3,单词 4/10,干扰 1/2) |
| 命中结果相似度区间 | 0.304 ~ 0.367 |
| 单词 vs 整句 | "沙发"0 条 → "宝宝在沙发上看书"命中 |
总结
文搜图适合"用户记得画面、不记得文件名"的场景:家庭相册、旅行照片、截图找旧信息、电商素材库。它的输入是自然语言,所以产品形态应该往"描述"靠,而不是往"关键词"靠。
不适合需要精确筛选的场景——按拍摄日期、按人、按地点的硬条件过滤,还是得靠元数据。这次实验真正的收获是那条反直觉的:越口语、越完整的句子,效果越好,所以搜索框应该鼓励用户多说,而不是少说。
💡 一句话:在这个能力上,"输入关键词"是会失败的用法——把搜索框改成"说说那张照片里有什么",命中率从 4/10 变成 3/3。
参考文献
- 通过文本搜索图片(开发指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-text-search-image
- textSearchImage(文搜图)API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-text-search-image-api
- Core Vision Kit 简介:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-introduction
- Core Vision Kit 目录:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/core-vision-kit-guide